Thinking Machines представи Inkling 2 Small: Водещ западен модел с отворени тегла в компактния клас
Източник: ZDNet / Thinking Machines
Европейската независима лаборатория Thinking Machines пусна официално модела Inkling 2 Small, който оглави глобалните класации за отворени тегла в компактния сегмент под 10 милиарда параметри [1]. Новата архитектура съперничи по точност на значително по-големи проприетарни системи на водещите тестове за логика и математика (LLM бенчмаркове), доказвайки жизнеспособността на европейската екосистема с отворен код.
Синтетично пречистване на данните и вериги от разсъждения
Успехът на Inkling 2 Small се дължи на радикално нова методология за предварително обучение, при която над 60% от корпуса се състои от формално валидирани синтетични доказателства и стъпка-по-стъпка разсъждения. Вместо да поглъща милиарди страници неструктуриран уеб шум, моделът е трениран върху изключително висококачествени логически конструкции, което му позволява да постигне 78.4% точност на MMLU-Pro при едва 8 милиарда активни тегла.
Локално изпълнение на потребителски хардуер без облачна зависимост
Благодарение на 4-битовата квантизация (GGUF), Inkling 2 Small може да се изпълнява с над 40 токена в секунда на стандартен лаптоп с Apple Silicon или базова видеокарта с 8GB VRAM. Това отваря вратата за напълно защитени локални агенти, които оперират с поверителни данни без риск от изтичане към външни сървъри.
Демократизацията на интелекта чрез високотехнологични отворени тегла
Премиерата на Inkling 2 Small показва, че олигополът на големите американски облачни гиганти в областта на изкуствения интелект не е гарантиран. Чрез прецизна инженерна работа и оптимизация на данните, по-малки независими изследователски екипи могат да създават архитектури, които предоставят съпоставимо интелектуално качество при нищожна част от енергийните разходи. Отворените модели са критична защита срещу монопола, гарантирайки, че суверенни държави, академични институции и малки бизнеси запазват контрол над своята технологична съдба.
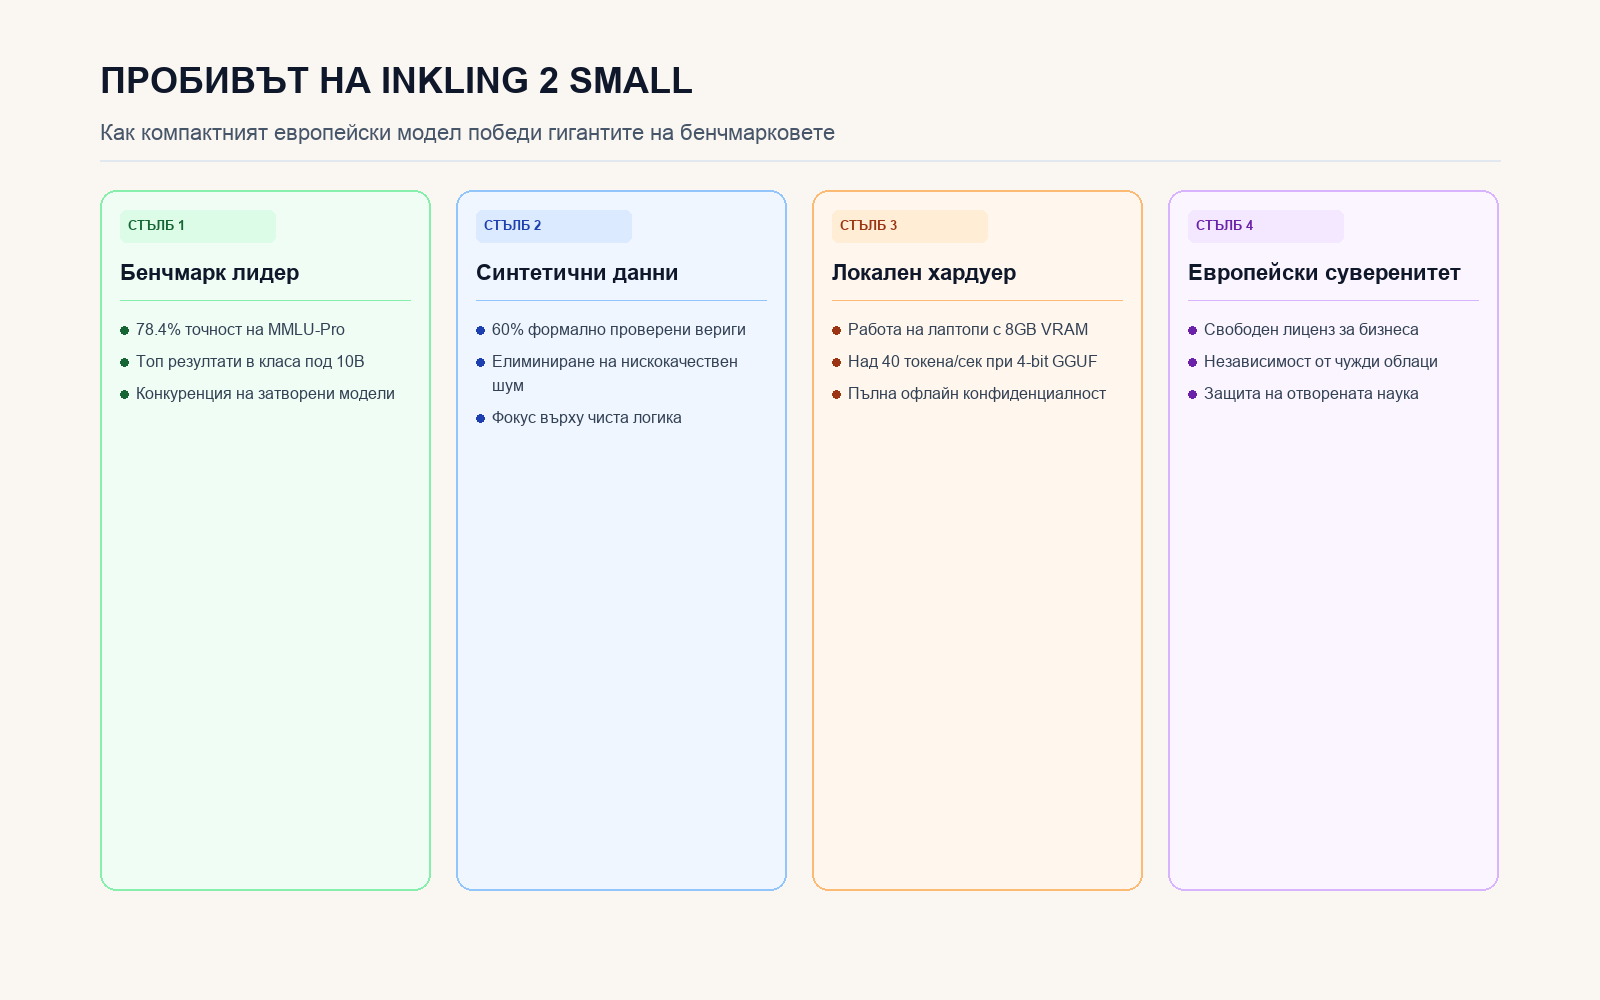
Преглед на синтетичните данни, квантизацията и локалната производителност.