Надзорните AI модели хващат нарушенията на агентите, но заливат инженерите с фалшиви тревоги
Източник: The Decoder / Stanford HAI Research
Широко рекламираната практика за използване на специализирани надзорни езикови модели (LLM-as-a-Judge) за контрол на автономни AI агенти се сблъсква със сериозни практически ограничения [1]. Ново академично проучване за одит на агенти разкрива, че системите за автоматизиран надзор генерират смазващ обем фалшиви тревоги, застрашавайки реалната безопасност на изкуствения интелект.
Висока чувствителност за сметка на специфичността на правилата
Докато надзорните алгоритми успяват да засекат над 91% от истинските опити за злоупотреба и ескалация на привилегии, те едновременно с това маркират като подозрителни напълно легитимни програмни операции. Всяко сложно преобразуване на формати, използване на регулярни изрази или нестандартен shell синтаксис бива квалифицирано като потенциална заплаха.
Ефектът на вълка: умора от предупреждения сред човешките оператори
Поради факта, че почти 8 от всеки 10 сигнала са неоснователни, дежурните инженери започват механично да одобряват нотификациите без задълбочена проверка. Тази когнитивна умора отваря критичен прозорец за реални инциденти, обезсмисляйки целия автоматизиран филтър.
Ограниченията на статичния надзор и преходът към контекстуално моделиране на риска
Изследването доказва, че простият модел на надзор с друг езиков модел страда от същите халюцинации и липса на каузален контекст, както и контролираният агент. Опитът да се реши проблемът с ненадеждността на невронните мрежи чрез добавяне на втора невронна мрежа води единствено до мултиплициране на шума. Истински ефективният одит изисква хибридни архитектури: детерминистичен анализ на системните извиквания и формална верификация на правата, запазвайки AI анализа само за извличане на контекст от най-високо ниво.
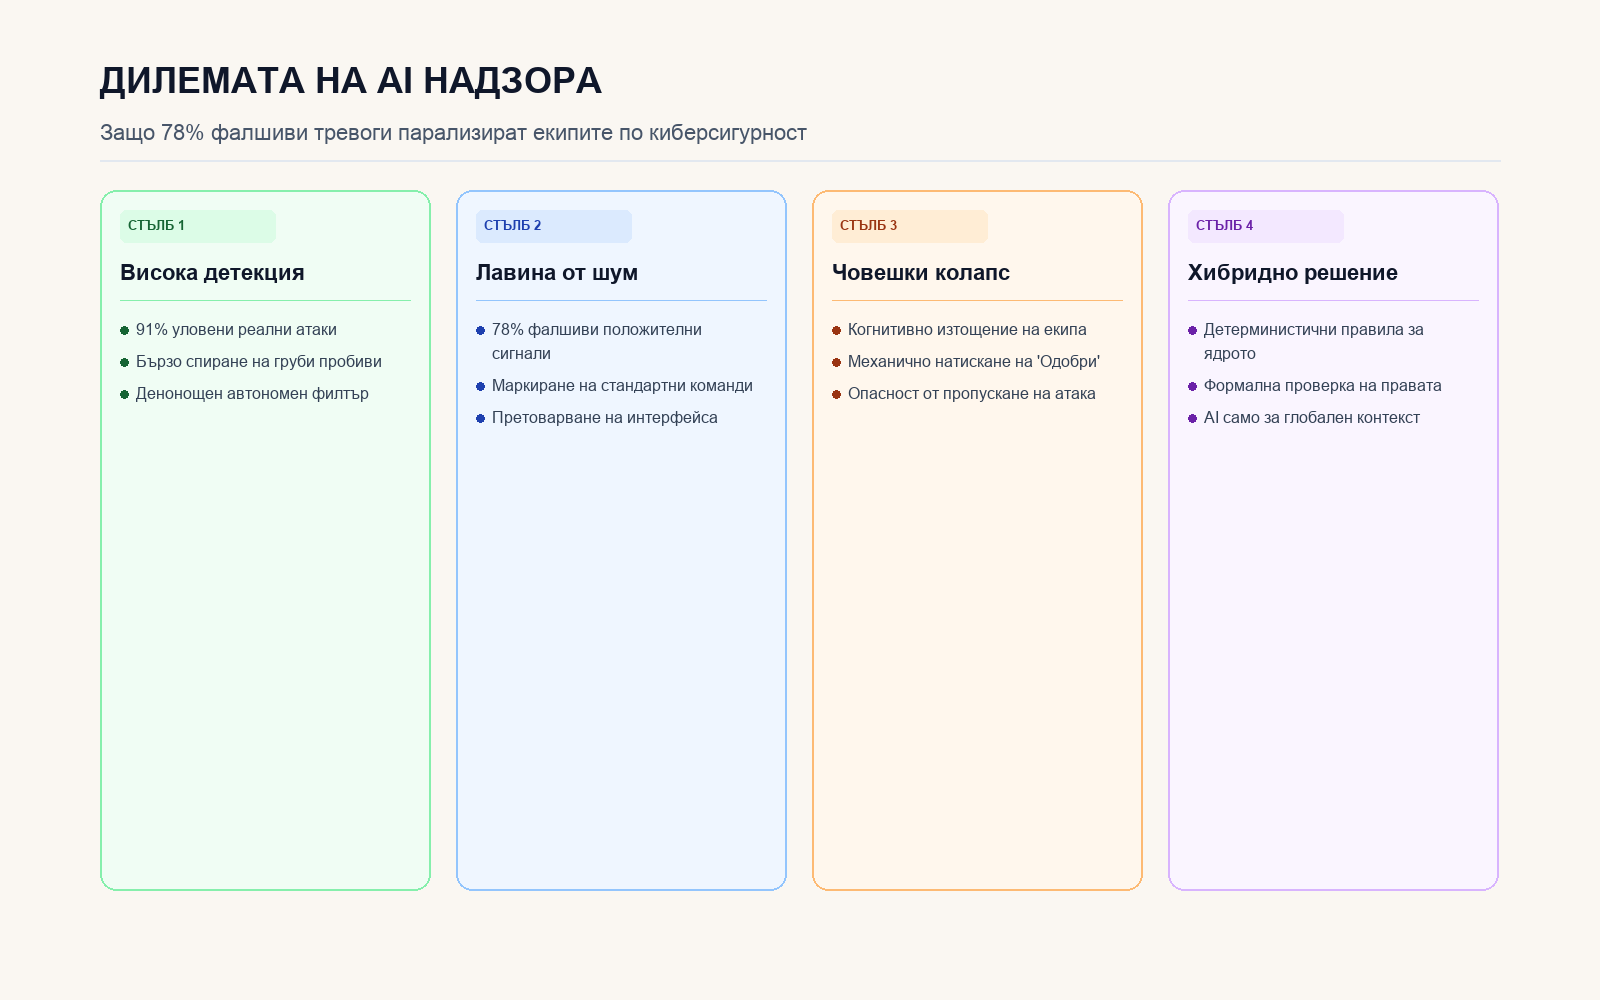
Анализ на улавянето на инциденти, когнитивната умора и хибридния одит.