Новият бенчмарк MaxxBench разкри масово замърсяване и изтичане на тестови данни при DeepSWE
Източник: MaxxBench / Unlap AI Research
Публикуването на новата тестова платформа MaxxBench предизвика сериозно сътресение сред компаниите, разработващи кодиращи агенти [1]. Изследването в областта на софтуерните бенчмаркове доказа, че водещият индустриален стандарт DeepSWE е дълбоко компрометиран от изтичане на тестови данни в тренировъчните корпуси, разкривайки илюзията за автономен софтуерен инженеринг при съвременните AI агенти на базата на SWE-bench.
Методология на проверката: мутация на семантиката без промяна на логиката
Екипът зад MaxxBench подложи на изпитание най-добре представящите се модели, като взе реалните задачи от DeepSWE и извърши автоматизирано преименуване на променливи, промяна на архитектурната структура на папките и въвеждане на еквивалентни софтуерни интерфейси. При тези леки козметични промени успеваемостта на моделите се срина от над 82% до катастрофалните 14%, доказвайки, че системите просто възпроизвеждат запомнени пачове.
Индустриалният натиск за изкуствено завишаване на метриките
Разкритието хвърля светлина върху практиката на венчърно финансираните стартъпи да обучават своите модели директно върху публичните тестови хранилища преди обявяване на инвестиционни рундове. Това създава изкривена представа за готовността на технологията да замени реални програмисти в корпоративна среда.
Кризата на доверието при софтуерните бенчмаркове и пътят към динамичен одит
Скандалът с DeepSWE е симптом за по-дълбок структурен проблем: статичните бенчмаркове са напълно неадекватни за оценка на съвременните езикови модели. Щом един тестов датасет стане публичен, той неизбежно попада в следващите итерации на синтетичното предтрениране. Бъдещето на софтуерната оценка принадлежи на динамични платформи, които генерират уникални, невиждани досега софтуерни среди и частни хранилища в реално време, оценявайки способността на модела да се адаптира към неизвестен контекст, а не да рецитира запаметени решения.
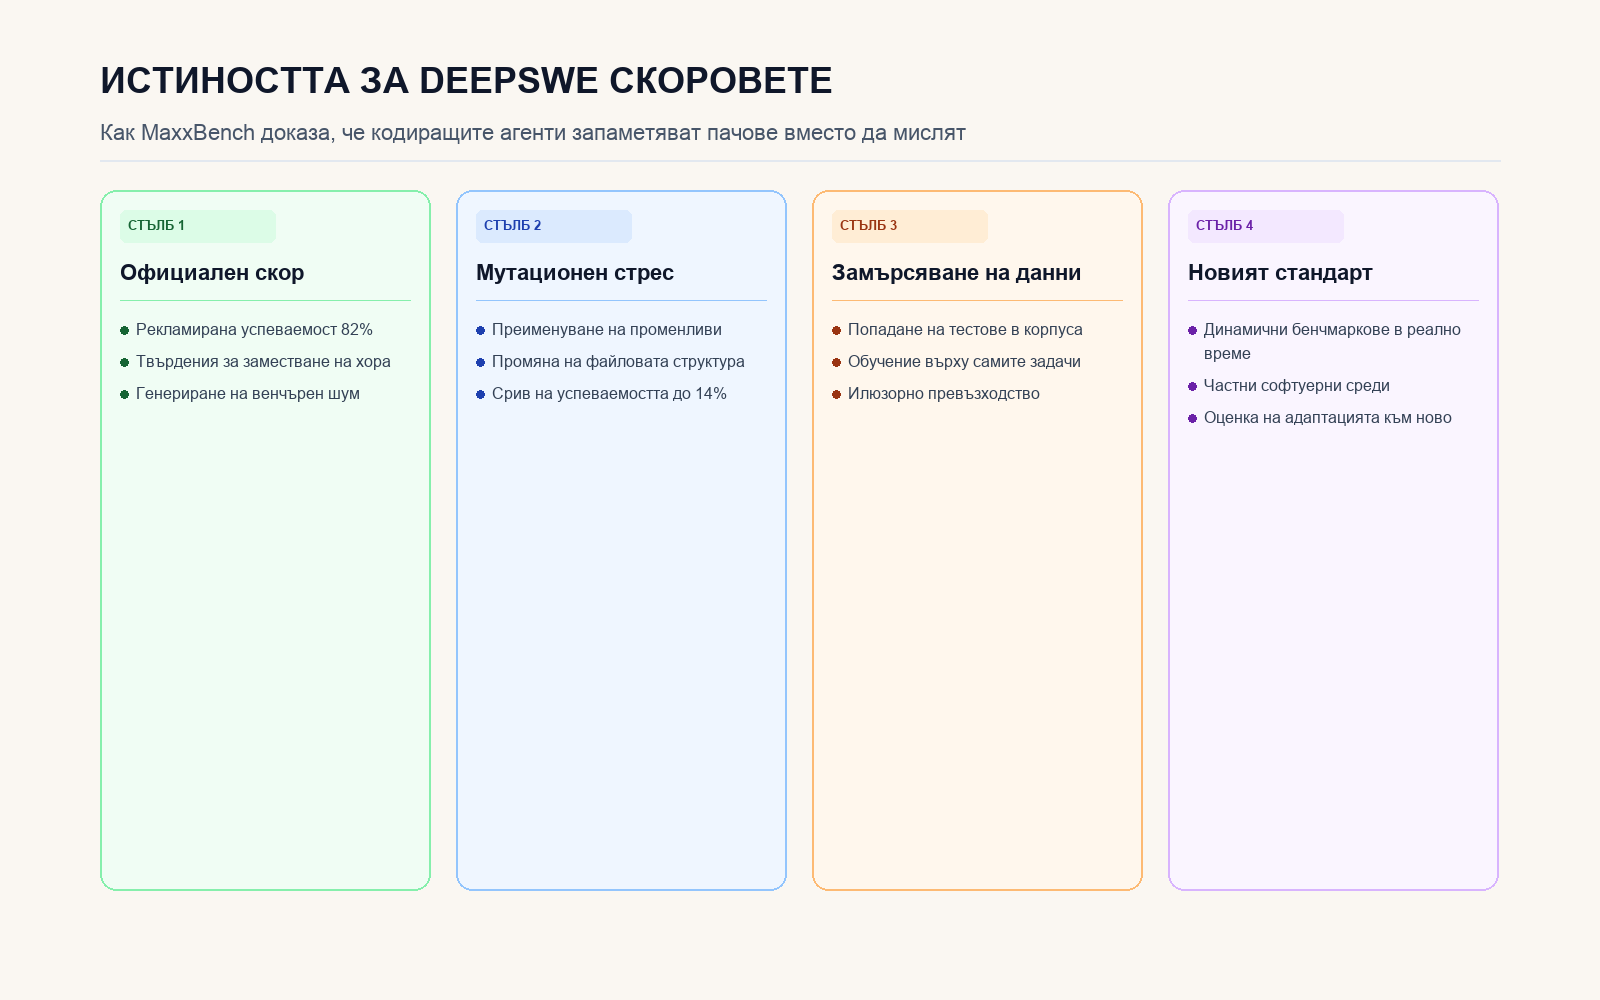
Сравнение на официалните резултати, мутационния тест и замърсяването на датасетите.