Underdog демонстрира свръхкомпактен 32MB неврон модел за гласово разпознаване, работещ изцяло в браузъра
Източник: TechCrunch / Underdog Audio Research
Технологичният стартъп Underdog впечатли индустрията по време на живо демонстрационно събитие, представяйки компактен неврон модел с размер от едва 32 мегабайта [1]. Системата поставя нов стандарт в сферата на периферния изкуствен интелект и автоматичното разпознаване на реч, компилирайки целия модел в бинарен WebAssembly формат за локален изкуствен интелект.
Премахване на мрежовата латентност при гласови диалози
Най-голямото неудобство при днешните гласови асистенти е паузата от 500 до 1500 милисекунди, необходима за компресиране на аудиото, изпращането му до отдалечен център за данни и връщането на транскрипцията. Моделът на Underdog се зарежда директно в паметта на браузъра и обработва аудио потока с латентност под 40 милисекунди, осигурявайки усещане за естествен човешки разговор в реално време.
Абсолютна сигурност на медицински и правни разговори
Тъй като аудио сигналът никога не напуска микрофона на локалната машина, моделът решава критичните регулаторни казуси около съхранението на чувствителни биометрични и гласови данни. Това го прави идеален за автоматизирано водене на медицински картони, банкови консултации и съдебни заседания.
Краят на зависимостта от облачни API интерфейси за базова комуникация
Пробивът на Underdog маркира дългоочакваното завръщане на изчисленията към крайните устройства. Годините, в които дори най-простата диктовка изискваше непрекъсната интернет връзка и плащане на такси на облачни монополисти, са към своя край. Когато един пълнофункционален гласов интелект може да бъде свален като обикновен уеб компонент от 32 MB, гласовото управление ще стане неизменна част от всеки уебсайт, мобилно приложение и интелигентен домашен уред.
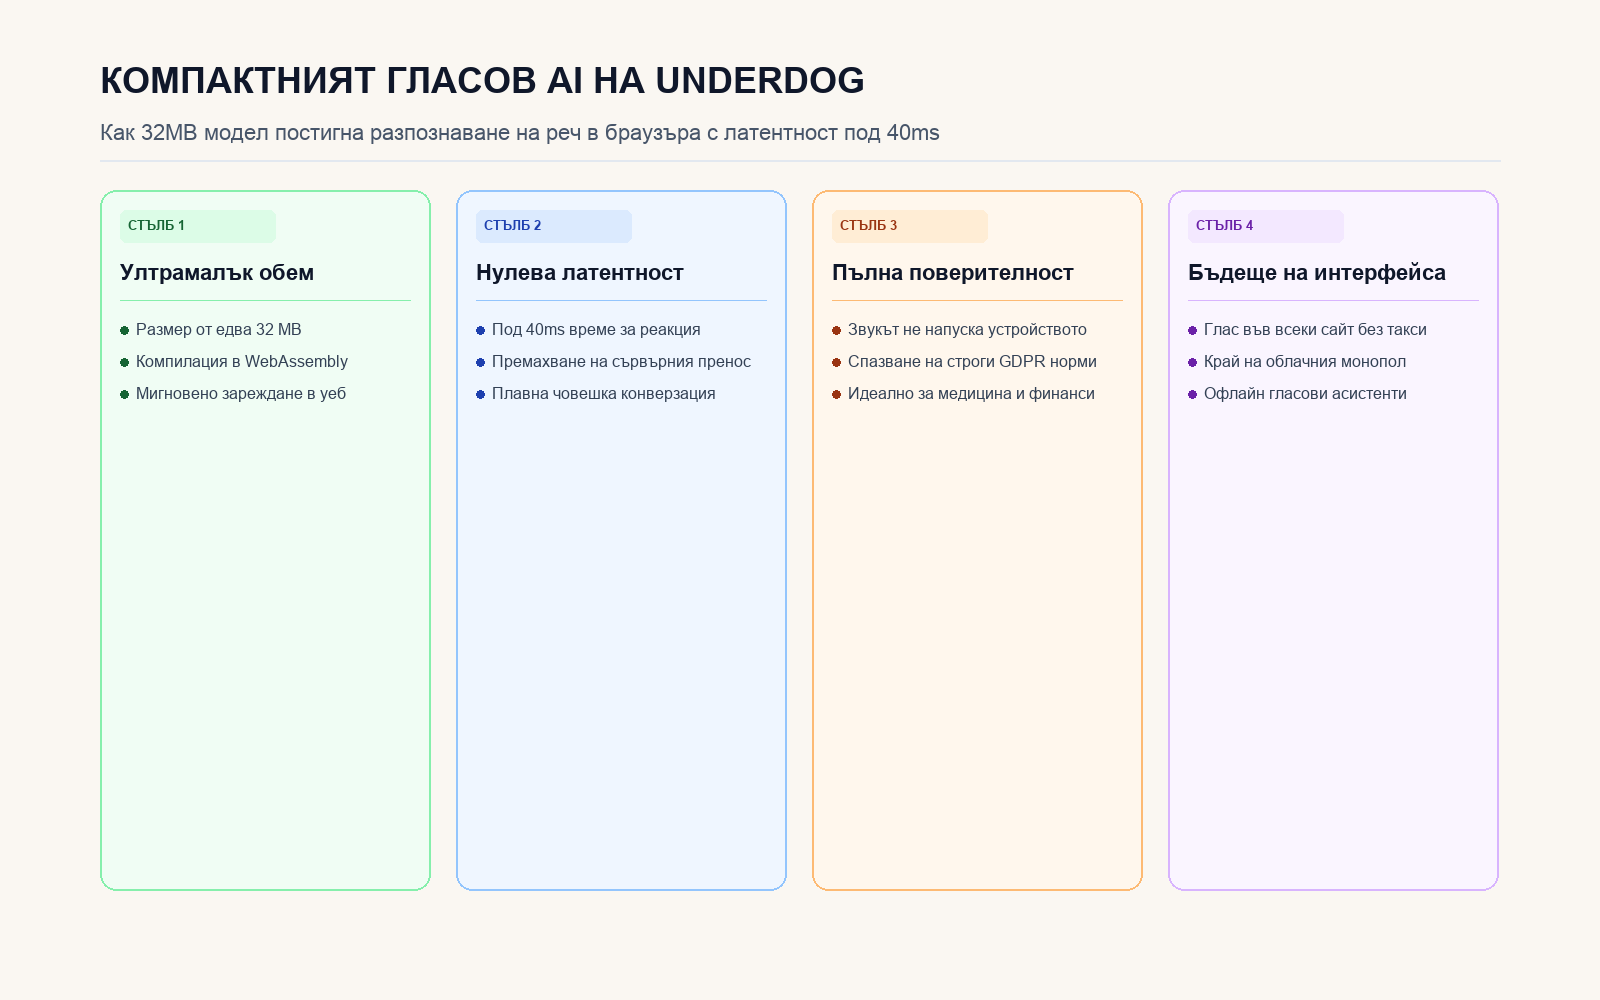
Сравнение на латентността, мрежовия трафик и защитата на гласови данни.