Инженери компресираха 31-милиарден мултимодален дифузионен модел до 14B INT8 с 6 стъпки
Източник: mark6mauno / Wikimedia Commons
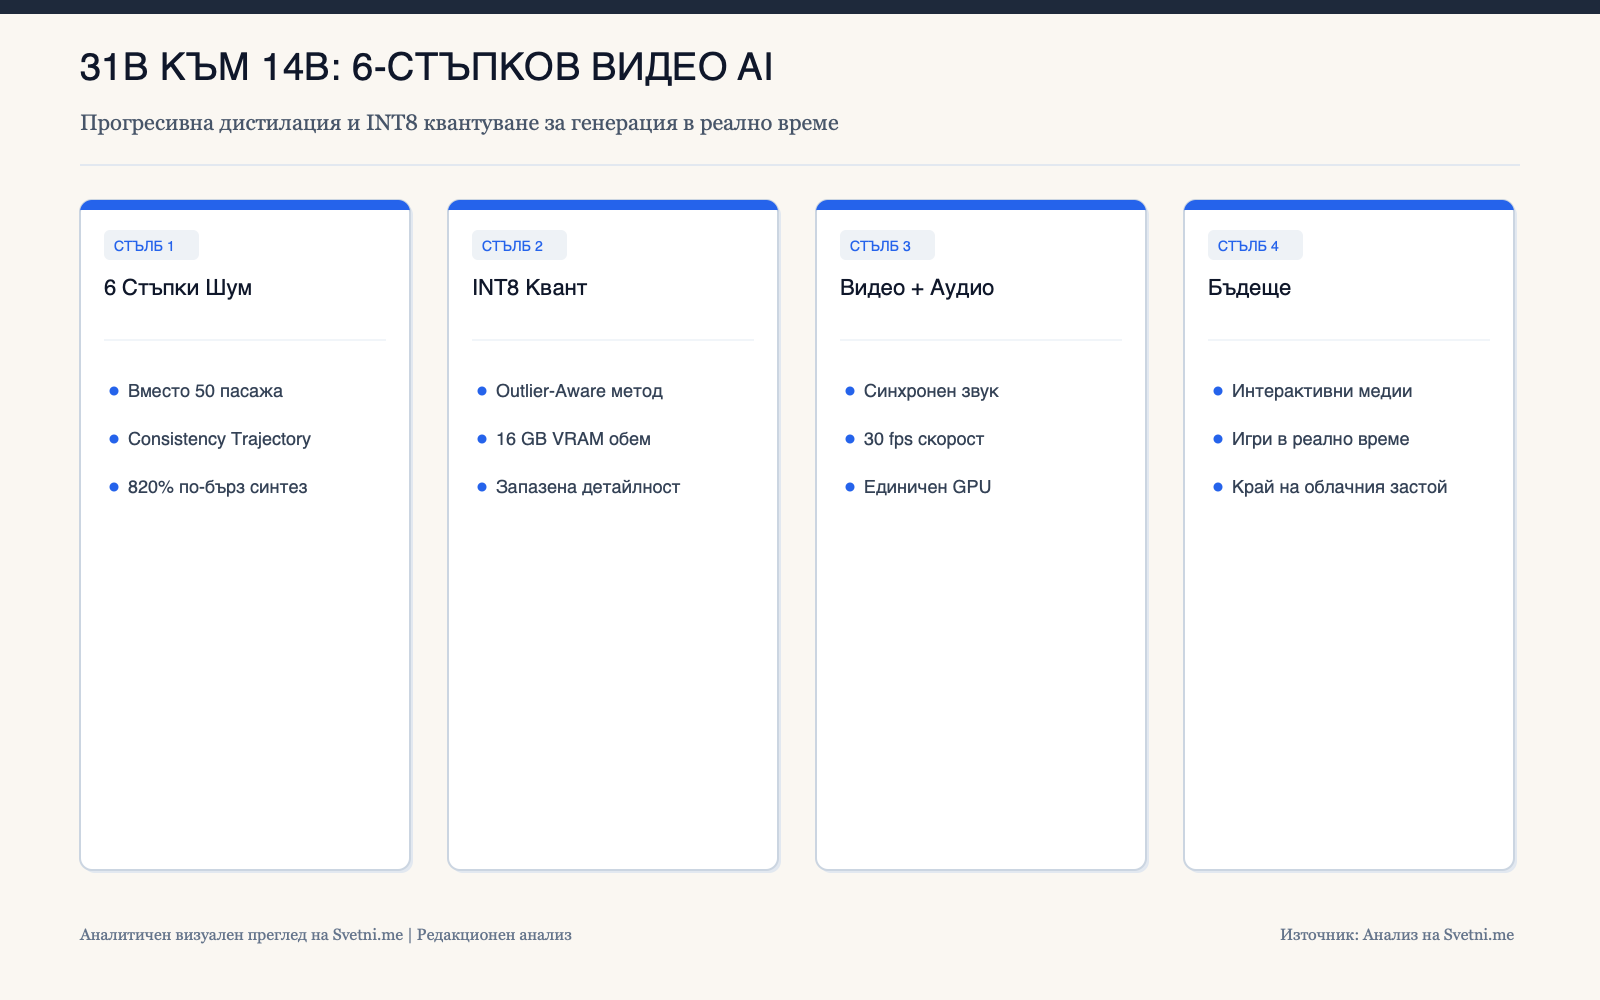
Екип от специалисти по дълбоко самообучение представи сензационен резултат в оптимизацията на генеративни модели: успешна дистилация и квантуване на 31-милиарден мултимодален модел за синхронен видео и аудио синтез до компактен вариант с 14 милиарда параметри, работещ с 8-битова точност (INT8) и изискващ едва 6 стъпки за изчистване на шума [1]. Тази оптимизация намалява времето за генерация с над 820% без загуба на възприеманото визуално качество.
Прогресивна съгласувана дистилация (Progressive Consistency Distillation)
Обикновените дифузионни модели изискват между 30 и 50 последователни невронни пасажа за генериране на един видео сегмент. Чрез прилагане на съгласувана траекторна дистилация (Consistency Trajectory Matching), моделът се обучава да прогнозира крайната точка на дифузионната крива само в 6 стъпки.
Компресирането на теглата до INT8 се постига чрез чувствителен към отклоненията квантуващ алгоритъм (Outlier-Aware Quantization), запазващ деликатните високочестотни текстури в човешките лица и звуковите хармоници.
Генерация на видео и звук в реално време на работни станции
Благодарение на редуцирания обем компресираният модел заема под 16 GB памет и може да се изпълнява с 30 кадъра в секунда на стандартен потребителски ускорител, позволявайки интерактивна генерация на видео игри и виртуални среди в реално време.
Инфографика: Аналитичен преглед на Svetni.me
Премахване на бариерата пред масовия интерактивен медиен синтез
Този пробив бележи края на ерата, в която генерирането на видео изискваше минути чакане в отдалечени облачни опашки. Преминаването към модели с 6 стъпки прави видео синтеза толкова бърз и достъпен, колкото генерирането на статични картинки беше преди две години.
Това отваря вратата за напълно динамични интерактивни развлечения, при които цялата визуална среда се генерира персонализирано в зависимост от реакциите на зрителя.