DeepX постига инференция на 100-милиардни AI модели при консумация под 5 вата
Източник: ResearchFrontier / Wikimedia Commons
Полупроводниковият стартъп DeepX обяви историческо инженерно постижение в областта на периферните изчисления: успешно изпълнение на квантуван езиков модел с размер 100 милиарда параметри при обща електрическа консумация под 5 вата [1]. Това прави възможно разгръщането на усъвършенствани автономни агенти в превозни средства, дронове и потребителски уреди без необходимост от връзка с облачни клъстери.
Асиметрично квантуване и специализирана паметова архитектура
Постигането на тази драстична енергийна ефективност се дължи на патентованата технология за селективно квантуване (Dynamic Precision Quantization). Вместо унифицирано намаляване на теглата до INT4, критичните слоеве за внимание (attention heads) запазват смесена точност, докато матричните умножения в MLP слоевете се редуцират до разредени 2-битови представяния.
Чипът интегрира и ултра-плътна LPDDR5X памет с директен оптичен интерконект на ниво подложка, елиминирайки най-големия източник на загуба на енергия — преноса на данни между процесорното ядро и външната RAM памет.
Сравнение с традиционните GPU решения и топлинно управление
Докато конвенционалните сървърни графични ускорители изискват водно охлаждане и консумират между 300 и 700 вата за аналогичен инференс, чипът на DeepX работи с пасивен радиатор при температура под 48°C. Това позволява херметично капсулиране за военни и индустриални приложения.
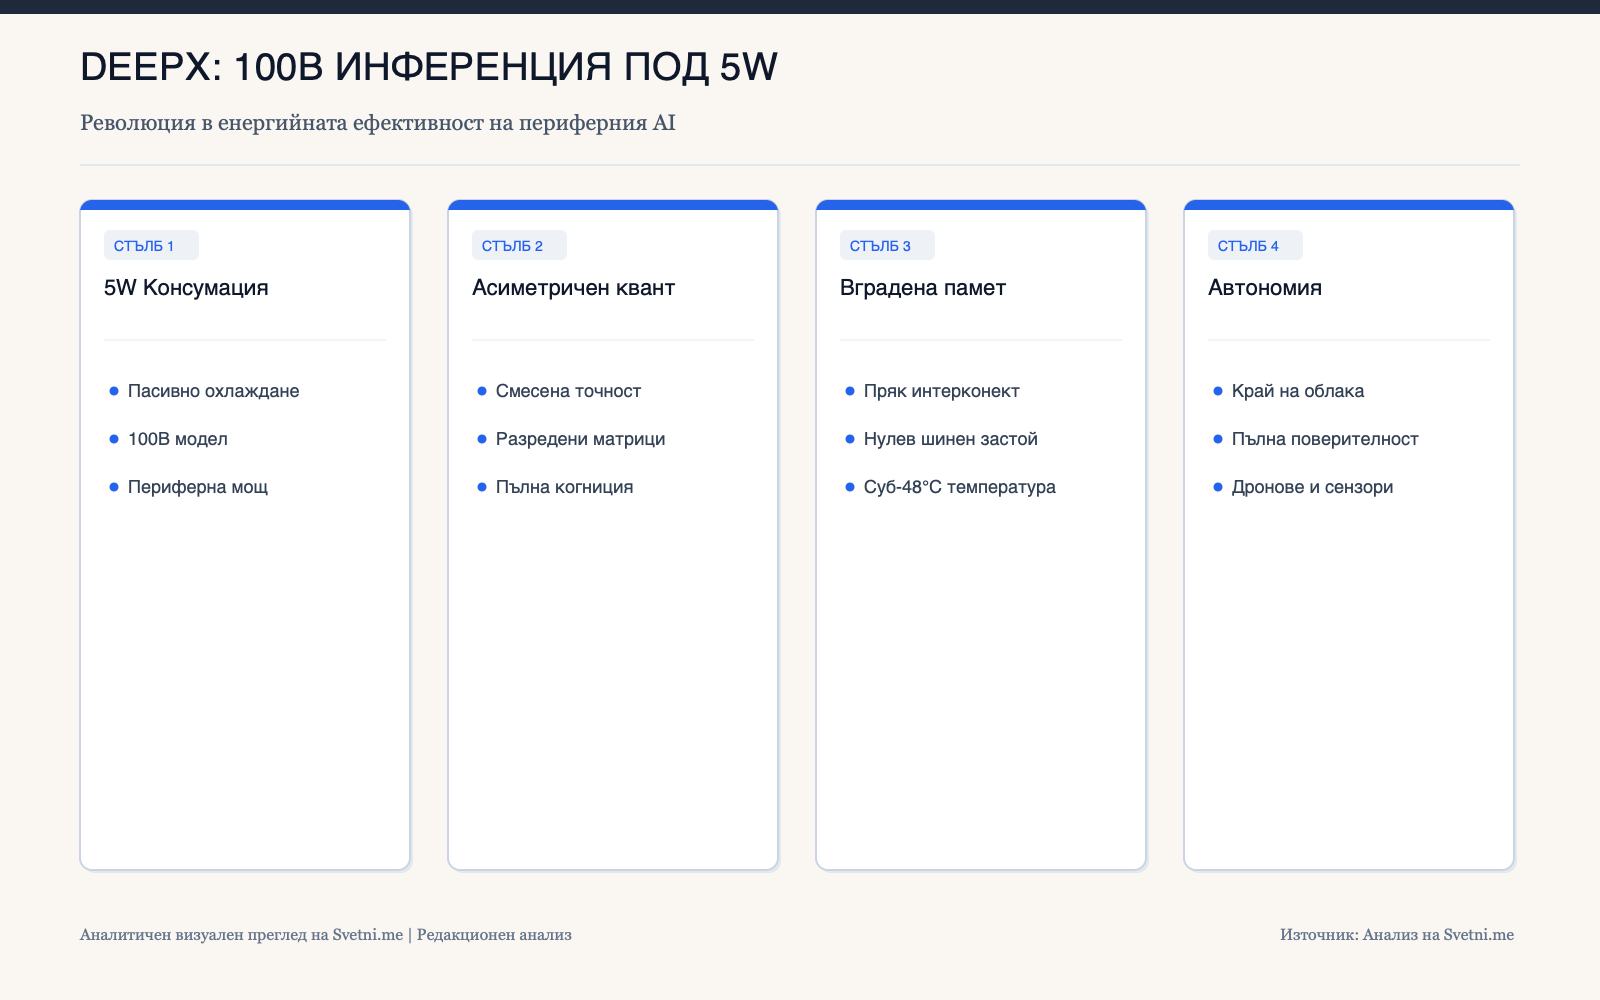
Инфографика: Аналитичен преглед на Svetni.me
Демократизация на локалния изкуствен интелект и край на облачната зависимост
Възможността за изпълнение на фронтиерни модели на периферни чипове с 5-ватова консумация подкопава икономическия монопол на големите облачни доставчици. Корпорациите вече могат да защитят интелектуалната си собственост и личните данни на клиентите, като задържат цялата обработка вътре в корпоративната мрежа.
В геополитически план развитието на подобни високоефективни чипове премества фокуса на полупроводниковата надпревара от масивните фабрики за 2-нанометрови сървърни гиганти към иновации в архитектурата на паметта и алгоритмичната компресия, където по-малки компании могат да наложат нови стандарти.