Йерархични LLM съдии: Комбинацията от лек модел и Opus сваля разходите 4 пъти при запазена точност
Източник: USAID Pakistan / Wikimedia Commons
Инженерният екип на платформата за данни Hightouch публикува задълбочено изследване върху ефективността на йерархичните невронни съдии при разрешаване на дублирани потребителски самоличности и комплексно валидиране на записи [1]. Чрез разгръщане на компактен модел, който ескалира сложните казуси към върховия модел на Anthropic, компанията постига прецизността на скъпия модел при четирикратно по-ниски оперативни разходи.
Архитектура на ескалацията: Ентропиен праг на доверие
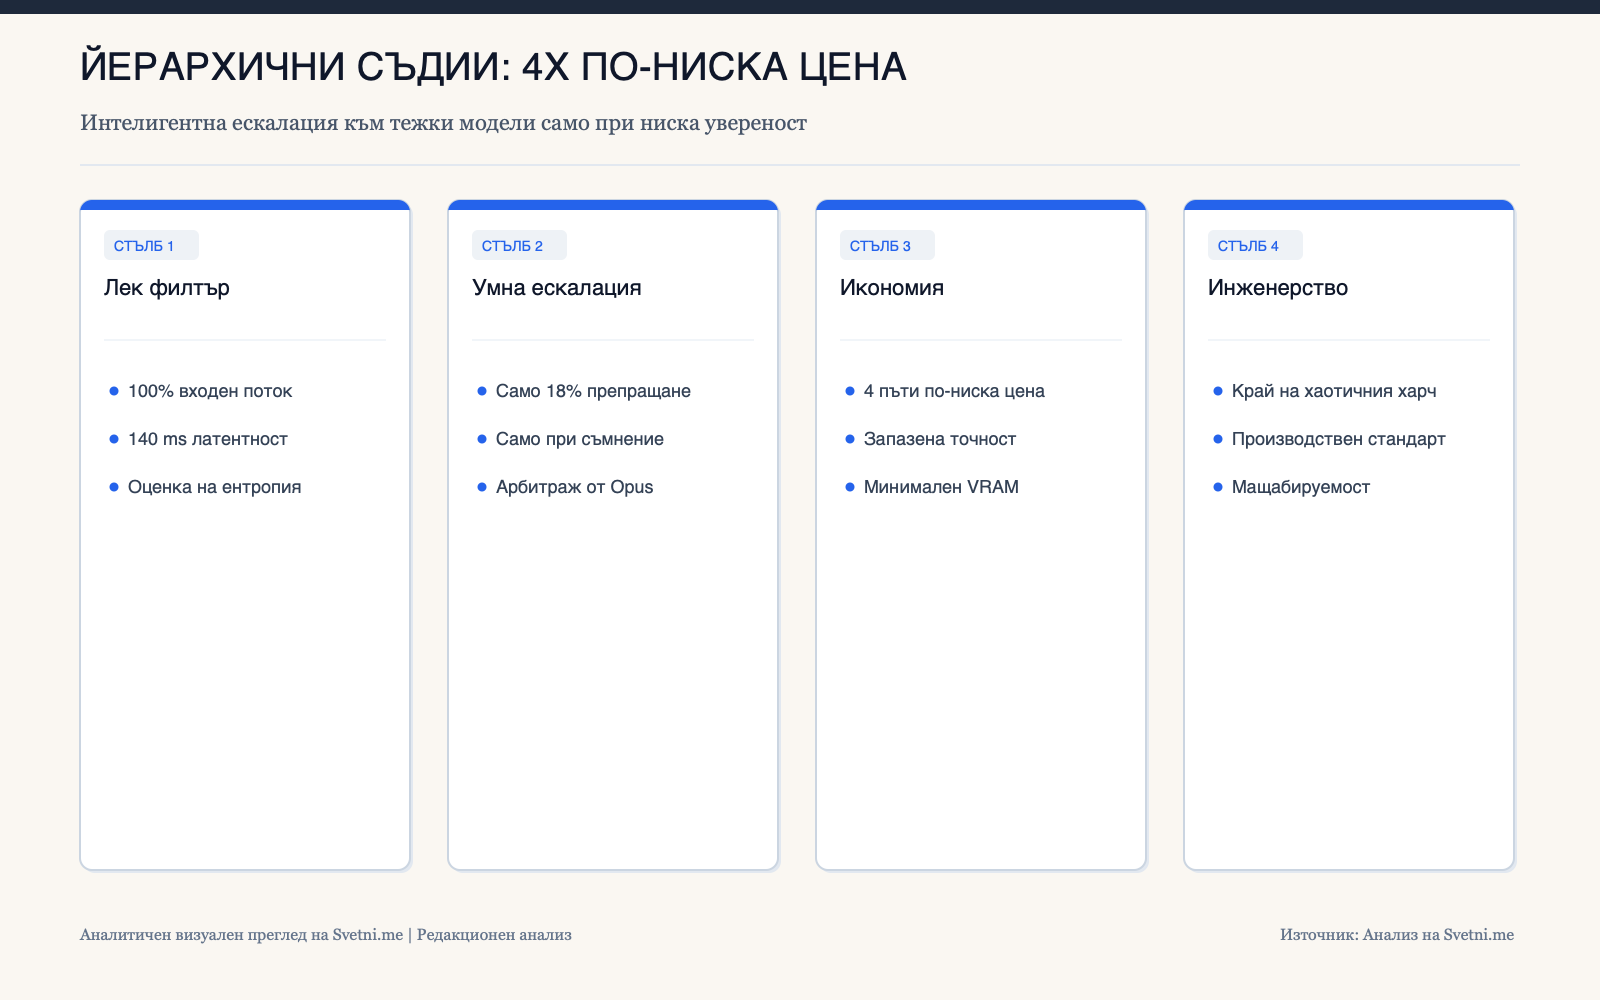
Вместо всяка транзакция да се оценява от масивен модел с висока цена за милион токена, лекият помощен модел обработва 100% от входящия поток. За всяко решение моделът генерира метрика за вътрешна увереност (log-probabilities entropy).
Ако оценката е категорична (над 95% сигурност), записът се категоризира мигновено. Само граничните, двусмислени казуси — приблизително 18% от целия обем — се препращат към тежкия флагмански модел за арбитраж.
Практическо въздействие върху корпоративния бюджет за токени
В мащаб от десетки милиони транзакции на ден този архитектурен дизайн спестява стотици хиляди долари месечно, като едновременно с това намалява средната латентност на обработката от 1200 ms на едва 140 ms за преобладаващата част от заявките.
Инфографика: Аналитичен преглед на Svetni.me
Зрялост на AI инженерството: Преход от демонстрации към икономическа устойчивост
Публикацията на Hightouch е емблематична за прехода на технологичната индустрия от еуфория по суровата мощ на моделите към финансова и оперативна рационализация. Корпоративните клиенти вече отказват да плащат огромни сметки за еднородна инференция върху тривиални данни.
Йерархичните системи се превръщат в златен стандарт за всеки производствен AI конвейер, доказвайки, че интелигентната оркестрация на софтуерно ниво е също толкова решаваща, колкото и размерът на самите невронни мрежи.