HubSpot обедини фрагментираните данни за обучение и инференция в унифицирана Feature Serving архитектура
Източник: HubSpot Product Blog / HubSpot
Софтуерната корпорация HubSpot представи технически обзор на своята нововнедрена платформа за унифицирано обслужване на атрибути (Feature Store), която премахва фрагментацията между аналитичните езера от данни и инференцията в реално време [1]. Системата решава един от най-скъпите проблеми в съвременното машинно обучение — несъответствието между данните при обучение и данните при експлоатация (train-serve skew), което води до скрита деградация на предсказващите модели.
Елиминиране на информационните силози и двойното програмиране
В традиционните архитектури екипите за данни обработват исторически записи чрез SQL и Spark за периодично обучение на модели, докато софтуерните инженери пренаписват същата логика на Java или Go за нисколатентна инференция при входящи потребителски заявки. Това неизбежно водеше до фини разминавания в изчисленията.
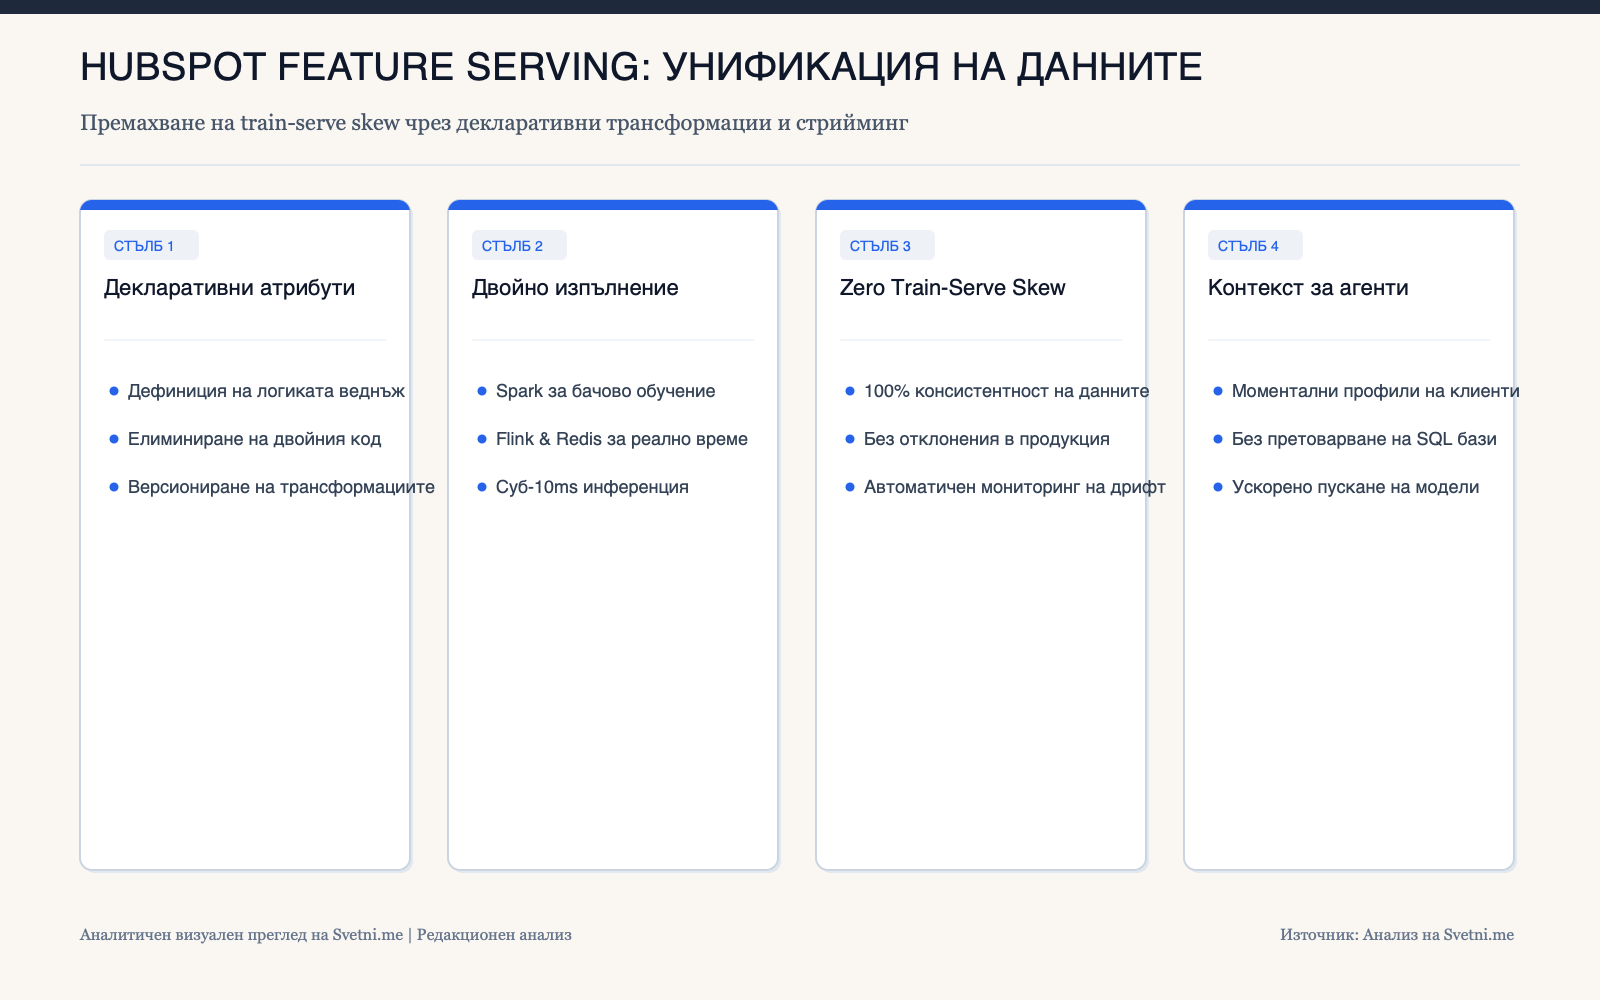
Архитектурата на HubSpot дефинира логиката за трансформация на атрибутите само веднъж чрез декларативни конфигурации. Платформата автоматично компилира тази логика в бачови пайплайни за хранилището Snowflake и стрийминг процесори върху Apache Flink и Redis за обслужване с латентност под 10 милисекунди.
Семантичен контекст за корпоративни AI агенти
Освен за класически предиктивни алгоритми, новата архитектура служи като директен източник на свеж контекст за корпоративните агенти на HubSpot. Когато агент комуникира с клиент, той мигновено получава агрегирани показатели за поведението му без претоварване на основните трансакционни бази данни.
Инфографика: Аналитичен преглед на Svetni.me
Платформената стандартизация като фундамент за мащабиране на изкуствения интелект
Инженерният опит на HubSpot илюстрира критичната фаза на зрялост, в която навлиза AI индустрията. След първоначалния експериментален хаос, водещите корпорации осъзнават, че истинската стойност на изкуствения интелект зависи от надеждността на подлежащите тръбопроводи за данни (data pipelines).
Изграждането на централизирани платформи за атрибути намалява времето за внедряване на нови модели от месеци до броени дни, позволявайки на компаниите да репликират успешни функционалности без да дублират скъпа изчислителна инфраструктура.