Инженерите на Meta създадоха TLX: Хардуерно-нативен GPU компилатор за мащабно машинно обучение
Източник: Engineering at Meta / Meta AI
Инженерният екип на Meta публикува детайлно изследване за разработката на TLX — специализиран хардуерно-нативен компилатор за графични процесори (GPU), създаден за преодоляване на ограниченията на традиционните CUDA оптимизатори при мащабни невронни мрежи [1]. Новият софтуерен слой позволява постигане на до 3.2 пъти по-висока изчислителна плътност при обучение и инференция на хиляди паралелни клъстери.
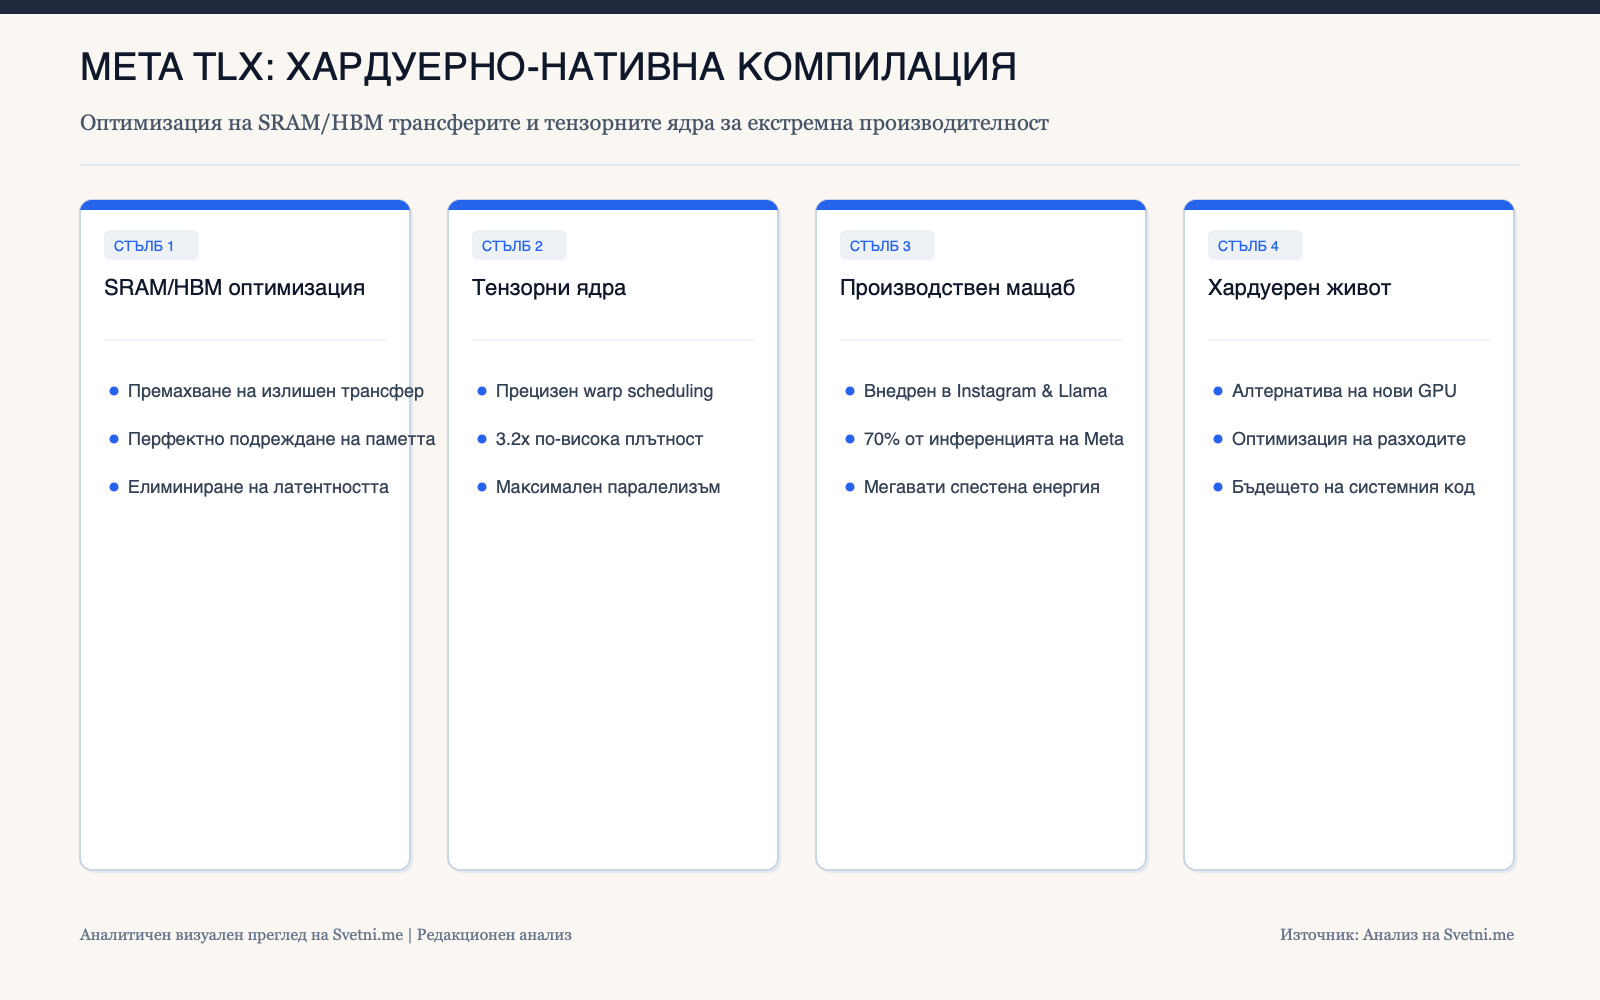
Директно адресиране на микроархитектурните кешове (SRAM и HBM)
Основното тясно гърло при съвременните трансформатори е латентността при пренос на данни между бързата локална статична памет (SRAM) и основната широколентова памет (HBM). Традиционните компилатори като Triton и стандартният NVCC компилатор често генерират неоптимални шаблони за достъп до паметта.
TLX въвежда автоматично изчисление на потоците от данни на ниво междинно представяне (IR), следейки за перфектно съвпадение на тензорните операции с физическите размери на изчислителните блокове (warp scheduling). Това елиминира излишното презаписване на данни и гарантира максимално натоварване на матричните ядра.
Внедряване в инфраструктурата на Llama и препоръчителните системи
Meta вече е прехвърлила 70% от своите производствени инференционни мощности за препоръчителните алгоритми на Instagram и моделите Llama към TLX компилатора. Това е довело до икономия на стотици мегаватчаса електроенергия дневно.
Инфографика: Аналитичен преглед на Svetni.me
Компилаторните иновации като алтернатива на закупуването на нов хардуер
Публикуването на TLX подчертава нарастващата роля на нисконивовия системен софтуер в управлението на разходите за изкуствен интелект. Тъй като физическите закони на силициевото производство (краят на закона на Дънард и забавянето на закона на Мур) оскъпяват всеки нов хардуерен скок, компаниите трябва да извличат скритата производителност от съществуващите чипове.
Чрез дълбока компилаторна оптимизация, технологичните гиганти могат да удължат жизнения цикъл на своите скъпи сървърни клъстери, спестявайки милиарди долари за капиталови разходи.