Оптимизация на латентността при RAG: Нови векторни индекси и хибридно семантично търсене
Източник: Hacker News / Data Engineering
В общността за разработка на AI системи бе представен задълбочен технически доклад, разглеждащ ново поколение техники за оптимизация на конвейерите за разширено генериране чрез извличане (RAG) [1]. Анализът демонстрира как комбинирането на квантувани векторни бази данни, йерархични съседски графи (HNSW) и бързо лексикално филтриране BM25 може да намали времето за извличане на документи с до 85% при запазване на високата семантична релевантност.
Тесното място: Проклятието на размерността и паметта при векторното търсене
С нарастването на корпоративните бази от данни до десетки милиони документи, традиционното търсене по косинусово сходство върху 1536-мерни вектори с пълна точност (FP32) изисква стотици гигабайти скъпа оперативна памет.
Новите архитектури прилагат скаларно и продуктово квантуване (Scalar/Product Quantization), което компресира векторите до 8 или 4 бита. Това позволява съхраняването на целия индекс в L3 кеша на процесора и използването на хардуерни SIMD/AVX-512 инструкции за светкавично сканиране.
Двуетапен хибриден конвейер: Филтриране и реранкиране
Вместо да подава хиляди потенциални документи на скъп модел за реранкиране (cross-encoder), оптимизираният конвейер прилага двуетапен подход. Първият етап извършва грубо хибридно търсене за под 5 милисекунди, връщайки топ 50 кандидати.
Вторият етап използва олекотен модел за оценка, който селектира само 3 до 5 най-релевантни пасажа, оптимизирайки контекстния прозорец за последващата инференция на големи езикови модели.
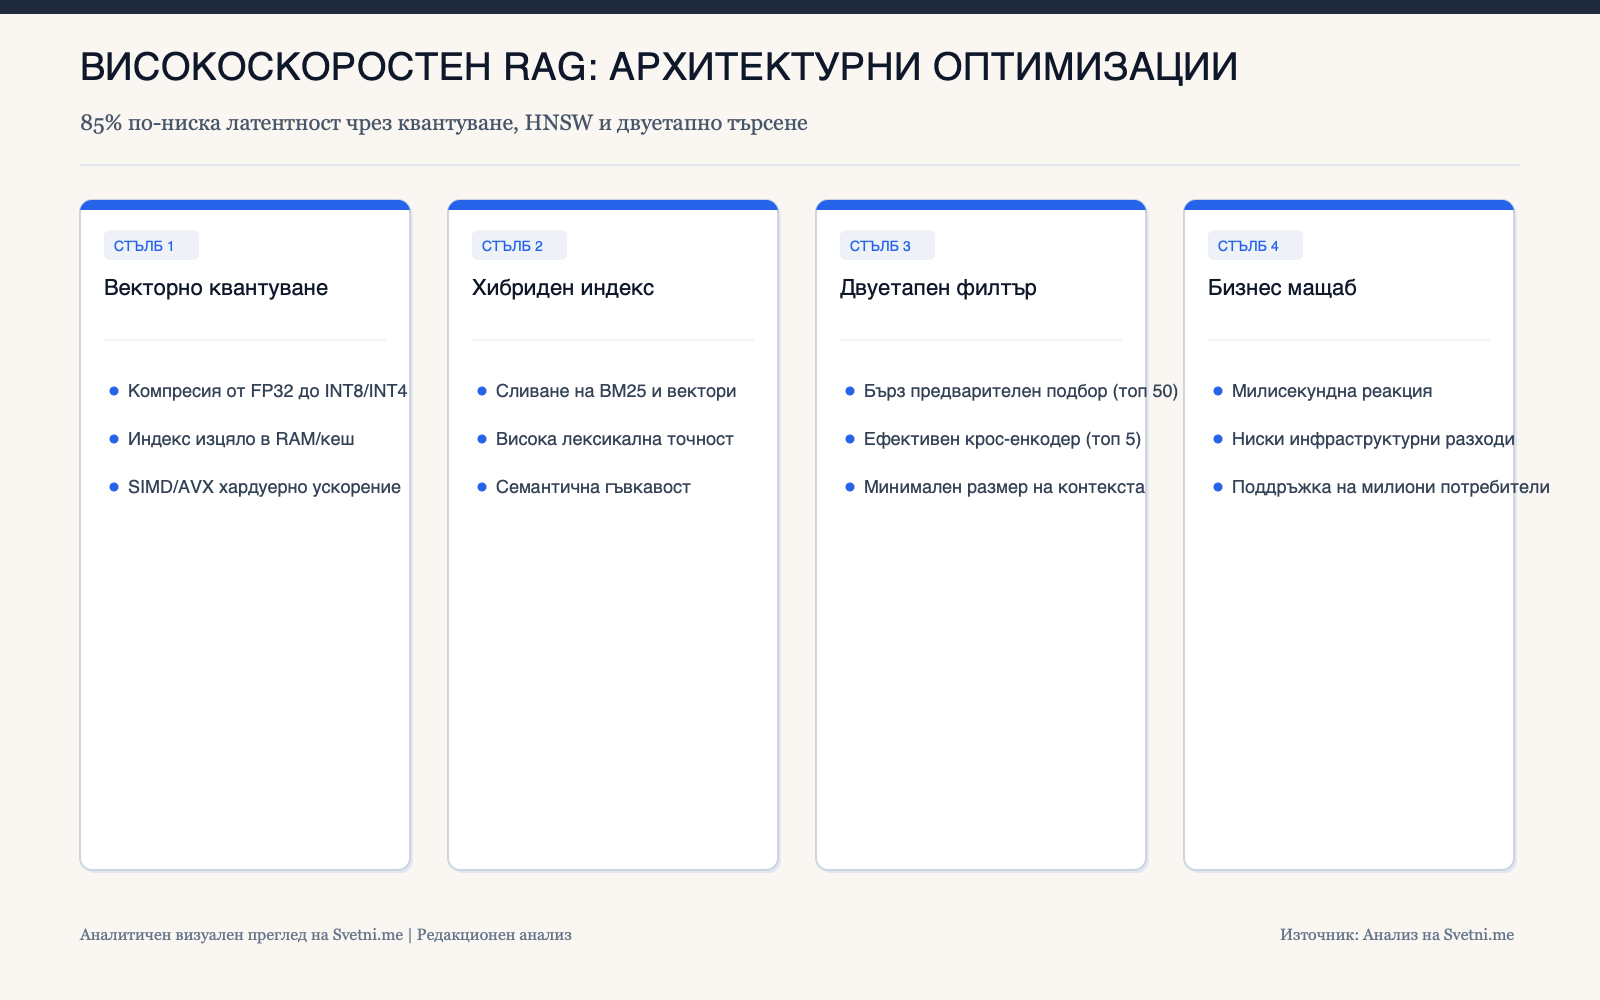
Инфографика: Аналитичен преглед на Svetni.me
Икономическа трансформация на корпоративните търсещи системи
Оптимизацията на RAG архитектурите бележи прехода на изкуствения интелект от фаза на експериментални прототипи към промишлено внедряване. Чрез съкращаване на латентността от секунди до десетки милисекунди, компаниите могат да внедряват семантично търсене в интерактивни приложения с милиони паралелни заявки без риск от претоварване на сървърите.
Тази софтуерна еволюция показва, че интелигентната организация на данните и алгоритмичните оптимизации остават също толкова важни, колкото и размерът на самите невронни мрежи.