ElevenLabs представи Scribe v3 Live с контекстуален анализ за предотвратяване на прекъсванията при гласови агенти
Източник: The Decoder / ElevenLabs
Пионерът в синтеза и разпознаването на реч ElevenLabs обяви пускането на Scribe v3 Live — авангарден модел за гласово взаимодействие в реално време, проектиран да реши един от най-дразнещите проблеми при гласовите асистенти: непрекъснатото прекъсване на събеседника [1]. Чрез интегриране на дълбок семантичен контекст в детекцията на гласова активност, моделът разграничава моментното колебание от края на изречението.
Архитектурни иновации в механизма за смяна на реда (Turn-Taking)
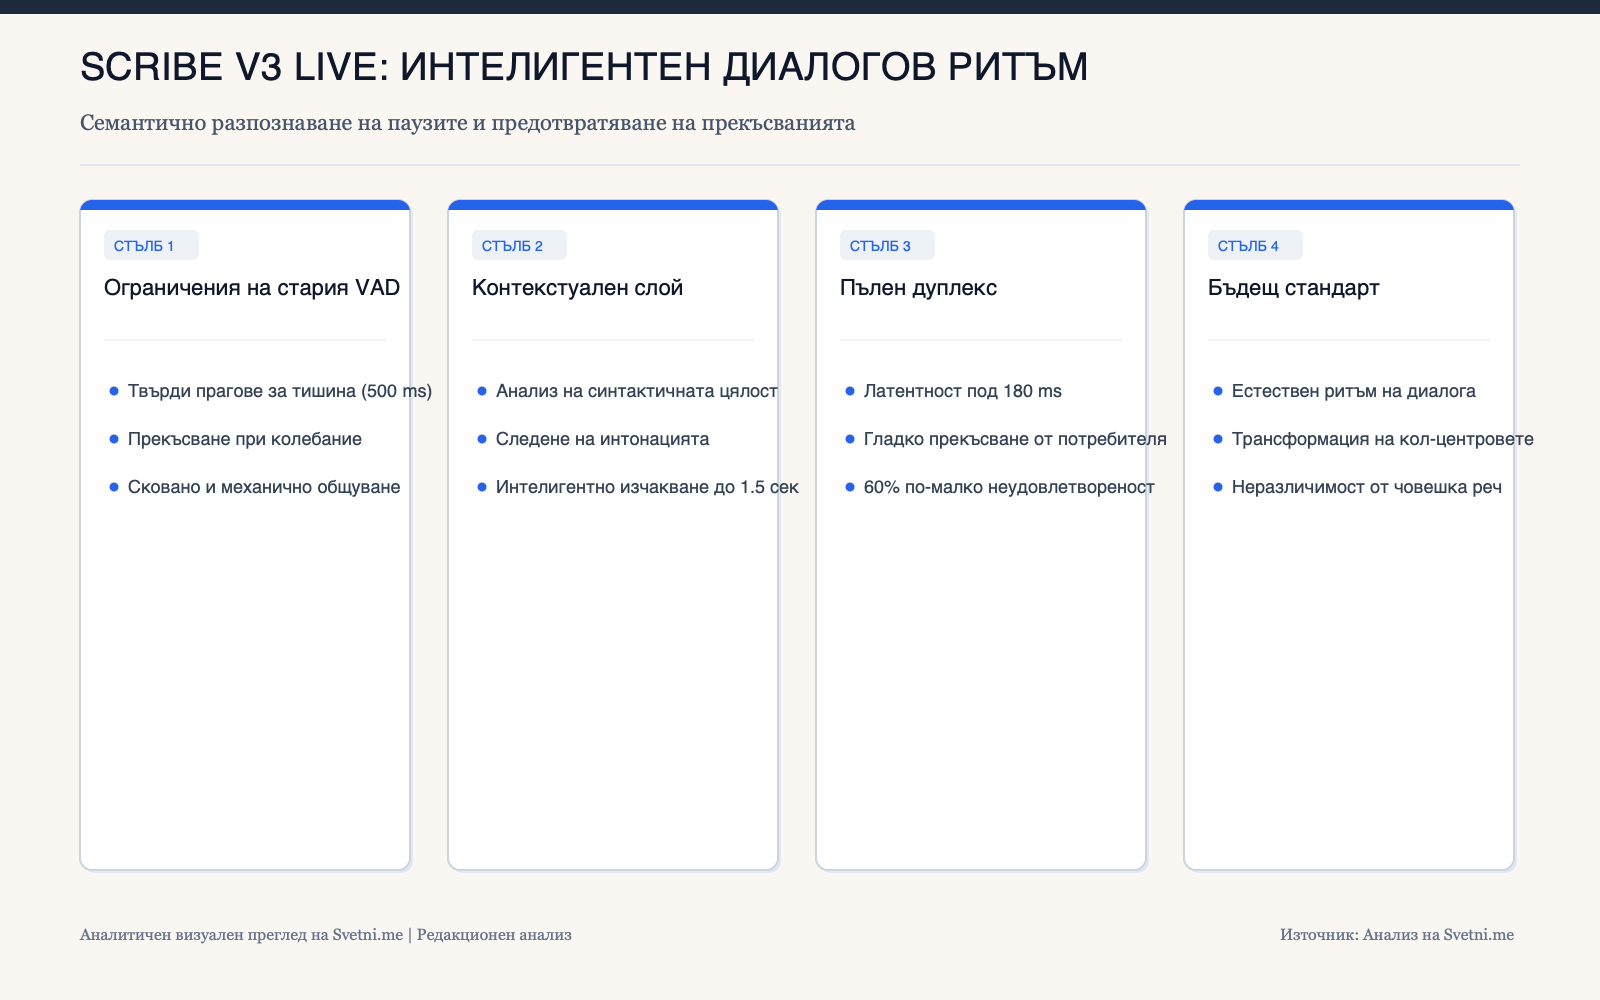
Традиционните гласови системи разчитат на прости прагове за тишина (Voice Activity Detection - VAD), които задействат отговор, ако потребителят замълчи за повече от 400-500 милисекунди. Това неизбежно води до прекъсване, когато човек просто обмисля следващата си дума.
Scribe v3 Live въвежда контекстуален предсказващ слой, който анализира синтактичната завършеност на речта, интонацията и тоналния спад в края на фразата. Ако семантичната конструкция е незавършена, моделът търпеливо изчаква до 1.5 секунди, без да нарушава диалога.
Ултраниска латентност и дуплексна комуникация
Системата поддържа пълна дуплексна комуникация (full duplex) със закъснение под 180 милисекунди, което позволява на потребителя естествено да спре асистента, ако желае да смени темата. При това прекъсването става незабавно и плавно, наподобявайки разговор между двама души.
Технологията е тествана в автоматизирани кол-центрове и системи за спешна помощ, където процентът на раздразнение у обаждащите се е спаднал с над 60%.
Инфографика: Аналитичен преглед на Svetni.me
Преходът към истински естествени гласови интерфейси
Напредъкът на ElevenLabs с Scribe v3 Live бележи важна крачка към премахването на последната бариера пред масовото навлизане на гласовия изкуствен интелект. Досега разговорите с ботове бяха сковани и неестествени именно поради липсата на интуитивно усещане за ритъм и споделено дишане в разговора.
Внедряването на подобни контекстуални модели за диалог ще трансформира потребителското обслужване, гласовите преводачи и персоналните дигитални спътници, правейки общуването с машини неразличимо от човешки разговор.