Smolmaxxing: Методология за ефективно стартиране на локални LLM върху остарял и ограничен хардуер
Източник: Hacker News / GitHub
В общността с отворен код се появи иновативният проект Smolmaxxing, който си поставя за цел да направи изпълнението на модерни езикови модели възможно върху силно ограничен и морално остарял хардуер [1]. Чрез съчетаване на суб-2-битова квантизация, агресивно подрязване на теглата и дълбоки оптимизации на ниво процесорен кеш (L1/L2), авторите постигат гладко генериране на текст на процесори с архитектура от преди десетилетие.
Технически техники за оптимизация на паметта и изчисленията
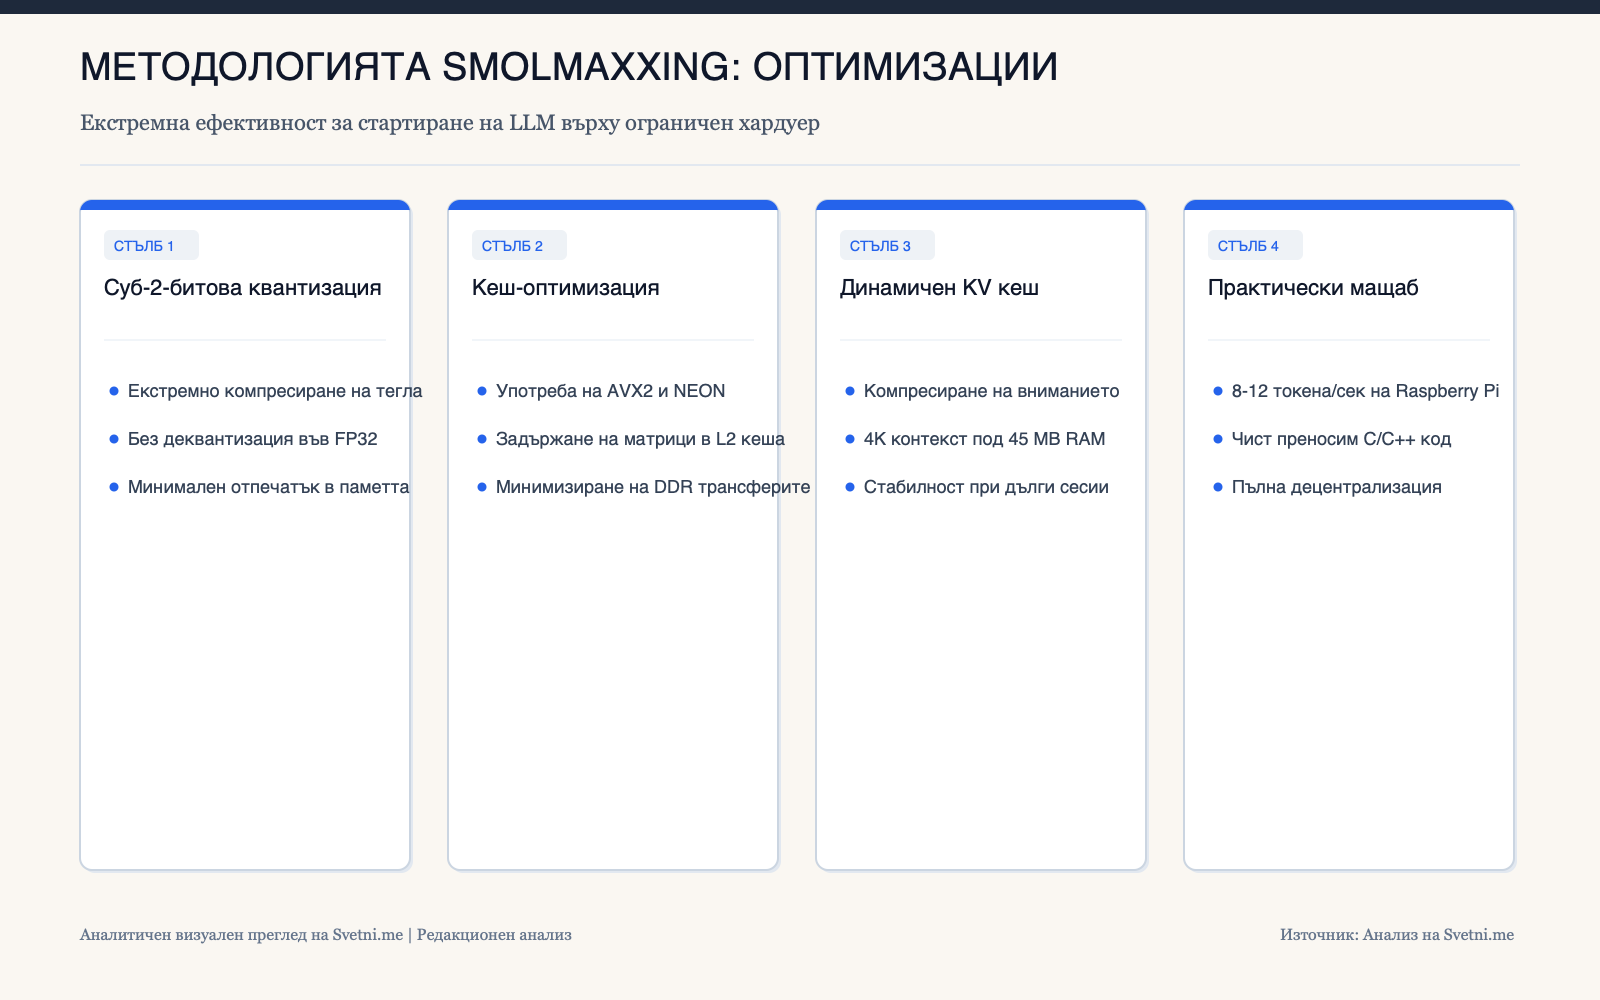
Ключовият пробив в Smolmaxxing се състои в пренаписването на матричното умножение за съвместно използване на целочислени SIMD инструкции (като AVX2 и NEON), без да се налага непрекъснато деквантизиране на теглата във формат FP32. Програмата организира зареждането на матриците така, че те да остават изцяло в бързия L2 кеш на процесора, минимизирайки обръщенията към бавната оперативна памет DDR3/DDR4.
В допълнение, размерът на KV кеша е сведен до минимум чрез динамично компресиране на вниманието, което позволява контекст от 4000 токена да заема по-малко от 45 мегабайта RAM.
Реална производителност върху евтини платформи
Тестовете показват, че оптимизиран модел с 3 милиарда параметри достига скорост от 8 до 12 токена в секунда върху преносими компютри с процесори Intel Core от шесто поколение и едноплаткови компютри като Raspberry Pi 5. Това е напълно достатъчно за локални гласови асистенти, интелигентно търсене в домашни бележки и автоматизация без интернет връзка.
Проектът е изцяло независим от външни библиотеки и е написан на чист C/C++, гарантирайки лесна преносимост към всякакви POSIX операционни среди.
Инфографика: Аналитичен преглед на Svetni.me
Демократизация на локалния ИИ и децентрализация
Успехът на инициативи като Smolmaxxing показва, че бъдещето на изкуствения интелект не принадлежи единствено на гигантските центрове за данни с консумация от гигавати. Чрез дълбоки алгоритмични оптимизации границата на полезно действие на компактните локални модели се разширява непрекъснато.
Това дава възможност на потребители в развиващи се региони или в условия на липса на стабилна свързаност да се възползват от генеративни технологии, гарантирайки абсолютна поверителност и устойчивост срещу спирания на облачни услуги.