Архитектурата Zen 6 на AMD: Анализ на векторните изчислителни блокове и пропускателната способност
Източник: Wikimedia Commons / Zephyris
В задълбочено техническо интервю главният архитект на AMD Майк Кларк разкри ключови детайли от бъдещата микроархитектура Zen 6, проектирана да отговори на екстремните изисквания на модерните натоварвания с изкуствен интелект [1]. Новото ядро въвежда фундаментални промени в разположението на конвейера, векторните изпълнителни блокове и подсистемата на кеш паметта за повишаване на локалната плътност на изчисленията.
Архитектурни промени във векторните регистри и FP16 конвейера
Zen 6 удвоява широчината на блоковете за изчисления с плаваща запетая, добавяйки директна апаратна поддръжка за матрични FP16 и BF16 инструкции без необходимост от емулиране през AVX-512. Архитектите са преработили планировчика на инструкции (scheduler), увеличавайки прозореца за пренареждане на инструкциите извън ред (Out-of-Order window) до безпрецедентните 768 записа.
Това позволява на процесора да поддържа висока натовареност на изчислителните блокове дори при работа с нерегулярни разредени тензорни структури.
Пропускателна способност на паметта и 3D V-Cache интеграция
Захранването на мощните изчислителни ядра изисква радикално преструктуриране на шината на паметта. Zen 6 въвежда ново поколение чиплети с директно вертикално подреждане на паметта чрез медни връзки без припой (direct copper-to-copper bonding), осигуряващи над 2.5 терабайта в секунда пропускателна способност между кеша и изпълнителните блокове.
Тази плътност позволява изпълнение на квантизирани невронни мрежи с минимална енергийна консумация директно на централния процесор.
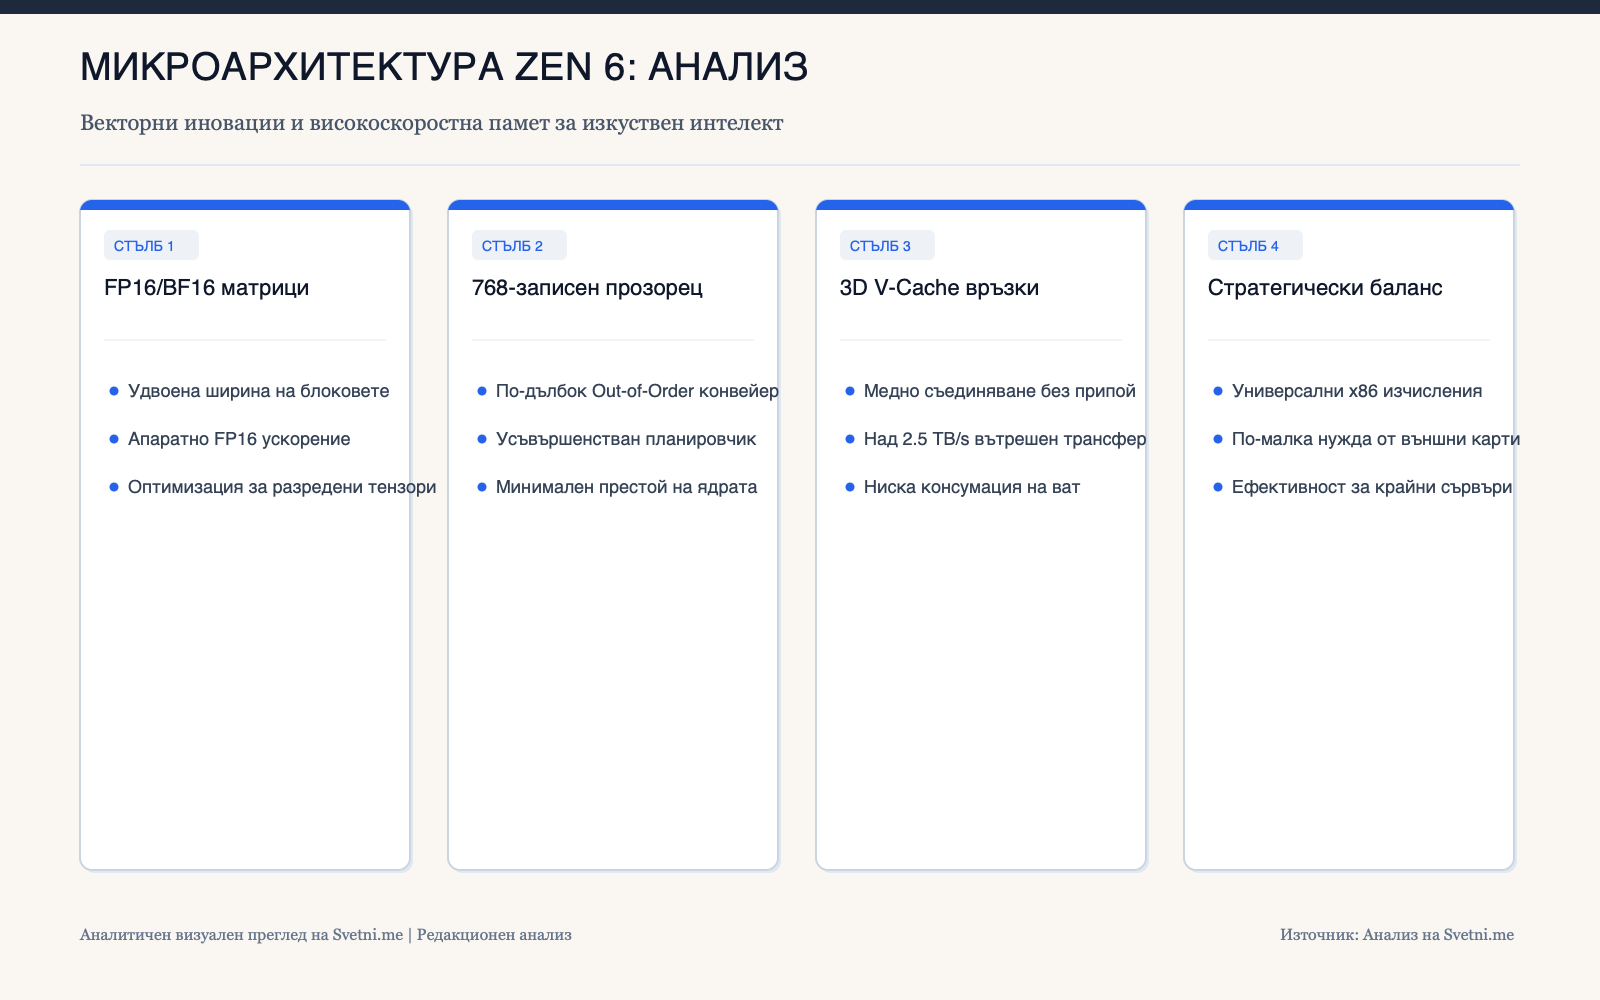
Инфографика: Аналитичен преглед на Svetni.me
Еволюцията на x86 архитектурата в ерата на ускорените изчисления
Иновациите в Zen 6 доказват, че класическата x86 архитектура далеч не е изчерпала своя потенциал пред лицето на специализираните AI ускорители. Чрез хибридизация на процесорните ядра с тензорни възможности, производителите на полупроводници създават универсални чипове, способни да изпълняват както сложна системна логика, така и масивни невронни изчисления.
Тази гъвкавост ще намали нуждата от отделни дискретни ускорители в масовите работни станции и периферни сървъри, променяйки пазарния баланс в технологичния хардуер.