Cerebras представя дезагрегиран инференс върху пластинни процесори за рекордна скорост на LLM
Източник: Cerebras Systems
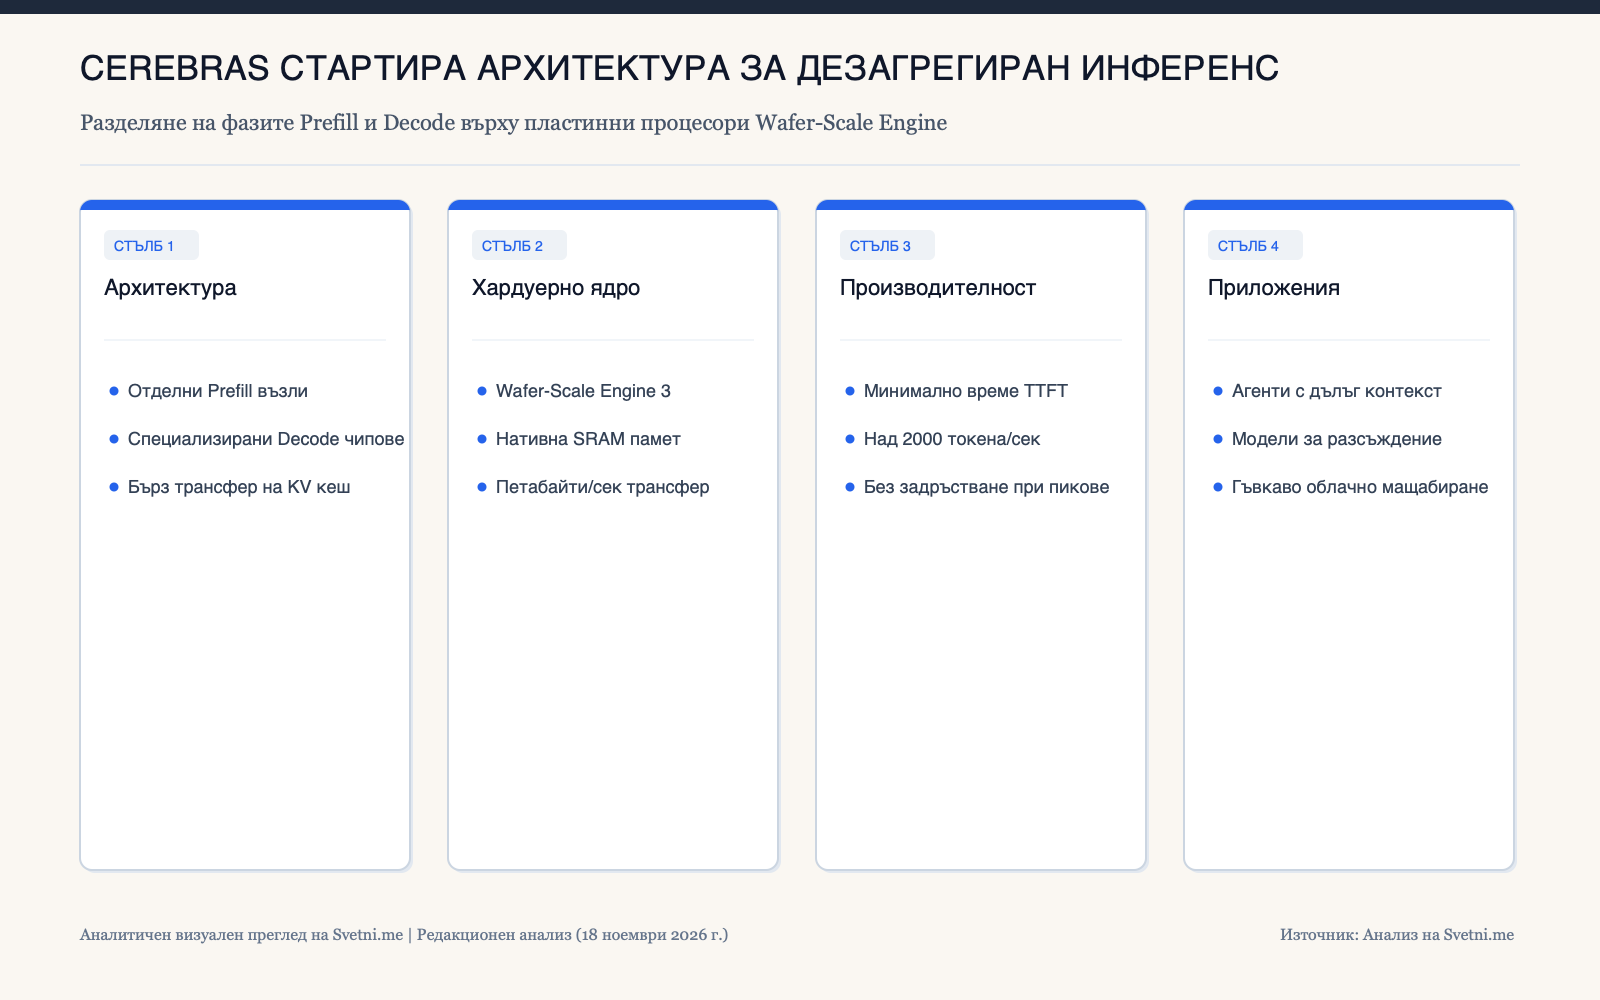
Пионерът в компютърните системи на ниво цяла силициева пластина Cerebras представи своята нова архитектура за дезагрегиран инференс (Disaggregated Inference) [1]. Системата разделя двете фундаментално различни фази на инференса при големите езикови модели — първоначалната обработка на входния промпт (prefill) и последователното генериране на отговора (decode) — върху специализирани възли с пластинни чипове (Wafer-Scale Chips).
Преодоляване на конфликта между Prefill и Decode
При традиционното обслужване на езикови модели един и същ хардуерен възел изпълнява и двете фази на заявката. Фазата prefill обработва паралелно хиляди входни токени и е изцяло ограничена от изчислителната мощ (compute-bound), докато фазата decode генерира по един токен на стъпка и е ограничена от пропускателната способност на паметта (memory-bandwidth-bound).
Когато нови дълги промптове прекъсват текущото генериране на токени на същия чип, възникват резки скокове в латентността. Архитектурата на Cerebras отделя възлите за prefill от тези за decode и прехвърля междинния KV кеш (Key-Value Cache) по свръхбърза вътрешна връзка на ниво пластина.
Предимството на вградената SRAM памет в Wafer-Scale Engine
Дезагрегираният инференс получава уникално ускорение върху процесорите Wafer-Scale Engine (WSE-3) на Cerebras, тъй като целият модел се съхранява във високоскоростна локална SRAM памет върху самата силициева пластина, осигуряваща петабайти в секунда пропускателна способност.
Чрез независимото мащабиране на броя prefill и decode пластини според профила на трафика (например агентни заявки с огромен входен контекст или дълги вериги на разсъждение), облакът на Cerebras постига многократно по-ниско време до първия токен (TTFT) при запазване на скорост от над 2000 изходни токена в секунда.
Специализацията на хардуерните топологии за агентни работни потоци
Въвеждането на дезагрегиран инференс от Cerebras потвърждава, че ерата на универсалните хомогенни клъстери за инференс отминава. Съвременните автономни агенти за програмиране и научен анализ изпращат стотици хиляди токени контекст и генерират дълги вътрешни монолози, което натоварва асиметрично паметта и аритметичните ядра.
Разделянето на фазите върху специализиран силиций позволява на инфраструктурните оператори да извличат максимална икономическа ефективност от всеки ват енергия, превръщайки ултрабързия инференс в ключово конкурентно предимство.
Инфографика: Аналитичен преглед на Svetni.me