Confluent пуска Managed Model Inference за директен AI анализ в потоци от данни в реално време
Източник: Confluent Blog
Лидерът в поточната обработка на данни Confluent обяви общата наличност на Managed Model Inference в своята облачна платформа Confluent Cloud [1]. Новата функционалност позволява на инженерните екипи да вграждат LLM инференс и генериране на векторни вграждания (embeddings) директно в конвейерите на Apache Kafka и Apache Flink за обработка на потоци от данни в реално време.
Елиминиране на външните микроуслуги чрез Flink SQL
Досега интегрирането на изкуствен интелект със събитийни потоци изискваше сложна верига от компоненти: четене на съобщението от Kafka топик, изпращане по мрежата към отделна Python микроуслуга, извикване на външен модел, управление на повторните опити при грешка и записване на резултата обратно в топика или във векторна база данни.
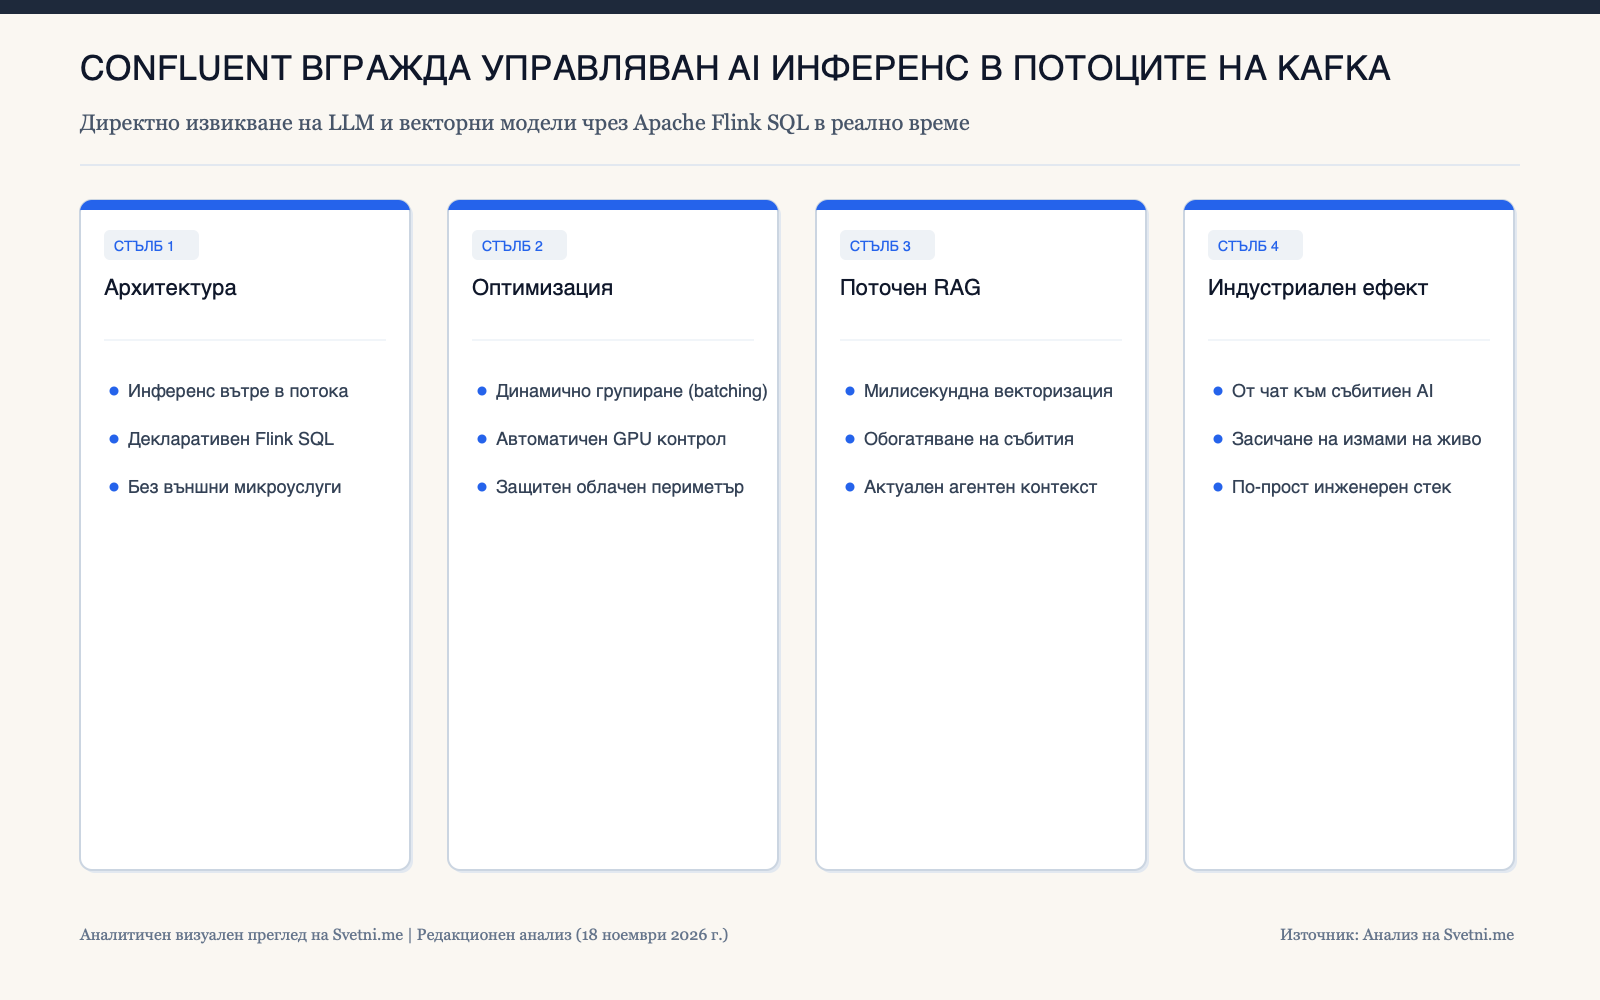
С Managed Model Inference този процес се свежда до декларативна SQL заявка в Apache Flink. Платформата автоматично управлява мащабирането на GPU ресурсите, групирането на съобщенията в пакети (dynamic batching) и асинхронното извикване на моделите, без данните да напускат защитения периметър на Confluent Cloud.
Контекст в реално време за RAG и агентни системи
Вграденият поточен инференс позволява всяко неструктурирано събитие — клиентско запитване, банков превод, системен лог или IoT телеметрия — да бъде класифицирано, обогатено и векторизирано в момента на неговото възникване.
Това осигурява на корпоративните агенти и системите за генериране с извличане (RAG) достъп до оперативното състояние на бизнеса с латентност от милисекунди, вместо да разчитат на остарели нощни ETL партиди.
Преходът от реактивни бази данни към проактивни събитийни агенти
Пускането на Managed Model Inference от Confluent отразява фундаментална архитектурна промяна в корпоративния софтуер. Първото поколение генеративни AI приложения работеше в режим „въпрос-отговор“, изчаквайки човек да напише промпт в чат прозорец.
Второто поколение корпоративен AI е събитийно-управлявано: моделите са разположени директно върху централната нервна система на предприятието (потоците в Kafka) и автономно задействат защитни, логистични или търговски процеси в секундата, в която се появи ново събитие.
Инфографика: Аналитичен преглед на Svetni.me