Feedzai оптимизира реално-времевото машинно обучение чрез компактно представяне на състоянията и селективен запис
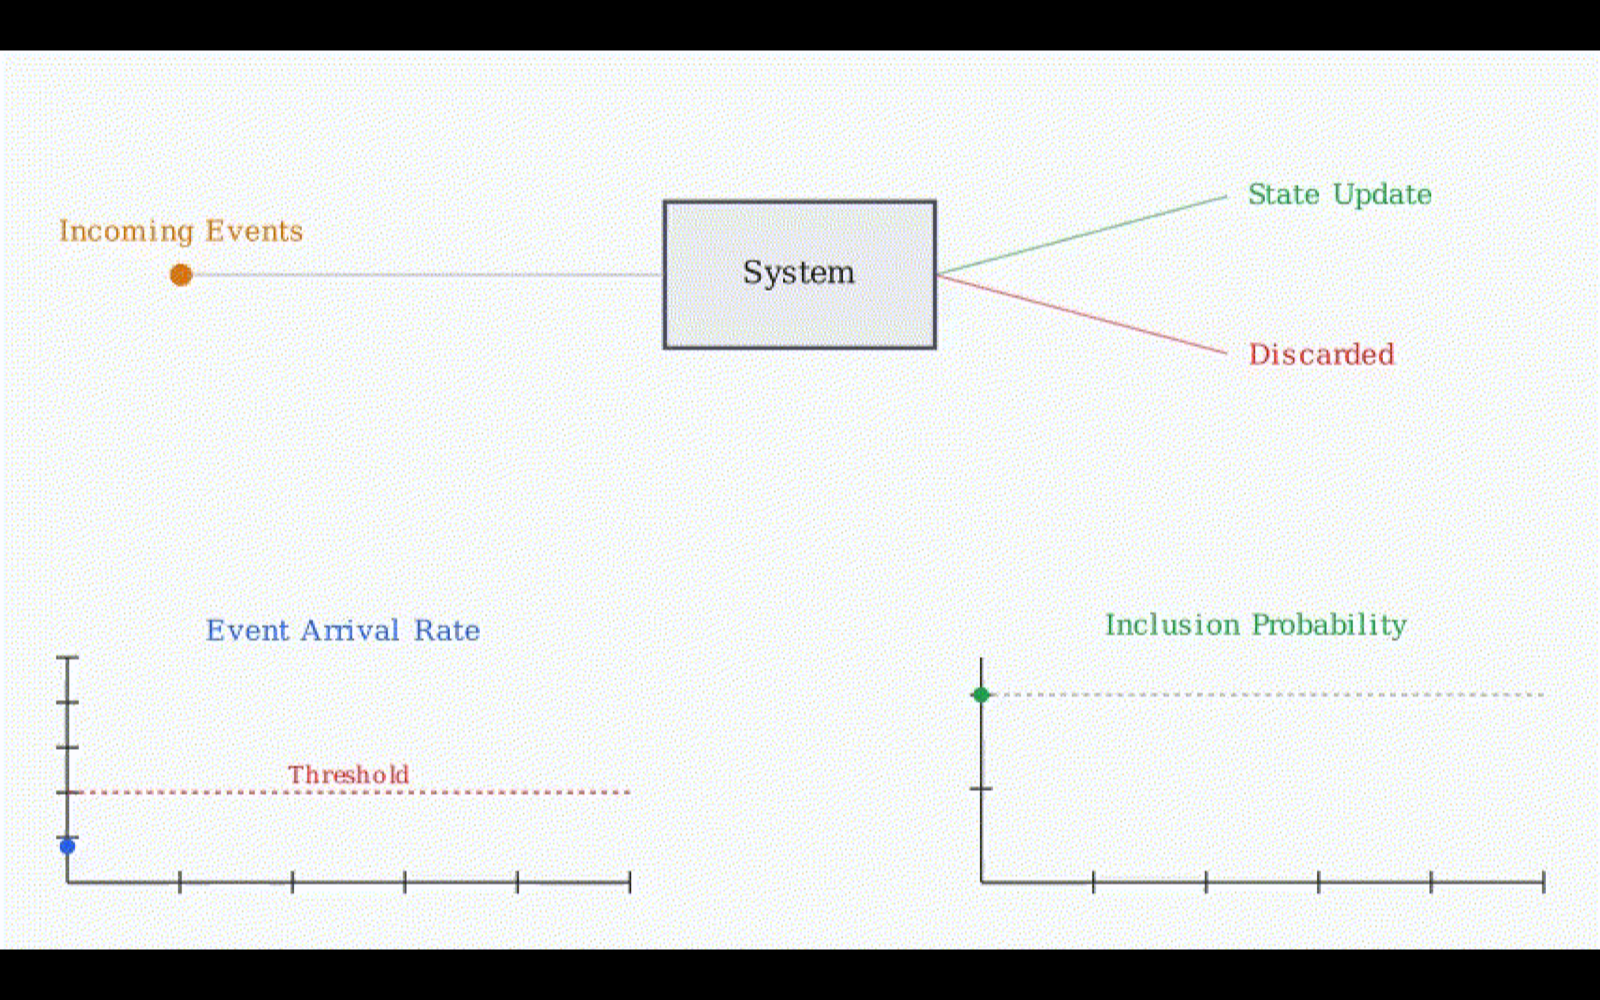
Източник: Feedzai Techblog / Feedzai Engineering
Тесният капацитет на цикъла четене-модификация-запис (Read-Modify-Write)
В сферата на съвременната борба с финансовите измами скоростта на реакция е разделителната линия между предотвратената злоупотреба и загубата на милиони долари [1]. Инженерният екип на финтех лидера Feedzai публикува задълбочен технически доклад, описващ как радикалното преосмисляне на начина, по който системите за машинно обучение управляват своите динамични състояния, позволява драстично намаляване на латентността и изчислителните разходи при обработка на поточни данни в реално време.
Всеки модел за откриване на финансови измами разчита на поведенчески профили, които следят навиците на потребителите и търговците във времето — например сумарните разходи за текущия месец, средния брой трансакции за последната седмица или бързината на поредица от плащания.
При всяка входяща трансакция традиционният конвейер изпълнява задължителен цикъл: извличане на профила от персистентна база данни, обновяване на стойностите с новите данни и обратно записване на диска. Именно последният етап — записът — се превръща в най-тежкото инфраструктурно тясно място (bottleneck). Множество паралелни работни нишки се състезават за достъп до дисковите ресурси, предизвиквайки остра конкуренция (database contention) и принудителни забавяния.
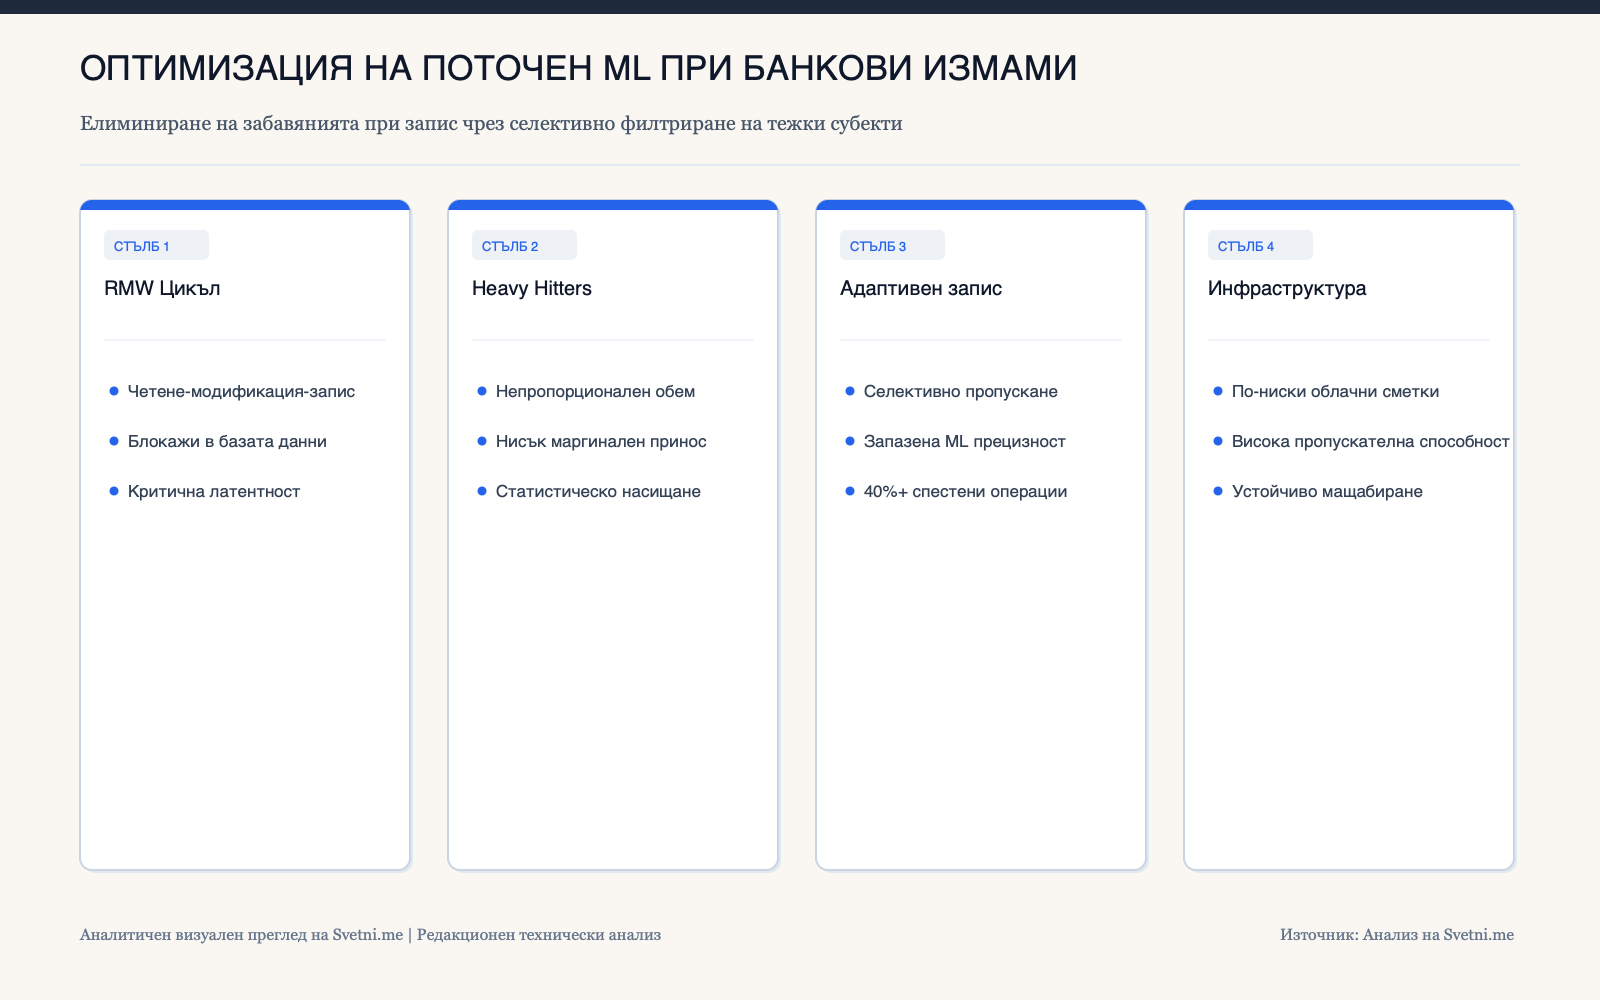
Инфографика: Ключови стълбове и анализ
Математическият пробив: Адаптивно филтриране за „тежки субекти“ (Heavy Hitters)
Анализът на трансакционния трафик показва силно асиметрично разпределение: минимален процент от субектите (големи търговски вериги, корпоративни сметки и платежни агрегатори) генерират по-голямата част от събитията.
Инженерите на Feedzai доказват, че от статистическа гледна точка всяко ново събитие за високочестотен субект добавя пренебрежимо малко информация към неговия обобщен поведенчески профил. Ако един търговец има десетки хиляди трансакции на ден, пропускането на междинния запис за няколко единични трансакции променя статистическата картина с части от процента, но напълно разтоварва базите данни.
Чрез въвеждане на адаптивни прагове за пропускане на записи системата запазва абсолютно всяко събитие за нискочестотните потребители (където всеки факт е критичен), докато динамично редуцира записите за натоварените акаунти, намалявайки дисковите I/O операции с над 40% без никаква загуба в точността на модела.
Системни архитектурни последици: Преосмисляне на състоянията в разпределените системи
Успехът на подхода „да постигнеш повече, като съхраняваш по-малко“ има дълбоки последици за проектирането на разпределени системи в цялата софтуерна индустрия. В продължение на десетилетия парадигмата в базите данни изискваше строга консистентност и фанатичен запис на всяка микропромяна на диска.
В ерата на високочестотните финансови потоци и агентните изчисления тази консервативна логика води до непосилни сметки за облачни ресурси и латентност, която заплашва потребителското изживяване.
Интегрирането на вероятностни алгоритми за агрегация и селективно съхранение доказва, че съвременното машинно обучение може да оптимизира не само предсказващите си изходи, но и самата инфраструктура, върху която функционира. Финансовите институции, които внедрят тези компактни състояния, ще си осигурят както по-висока сигурност срещу автоматизирани измами, така и съществено конкурентно предимство чрез намалени оперативни разходи.