Lakegres внедрява векторно търсене директно в отворените езерни таблици Hudi и Iceberg без ETL дублиране
Източник: Onehouse Engineering
Край на изолираните векторни бази и ETL фрагментацията
Внедряването на автономни ИИ агенти в корпоративния сектор срещна неочакван архитектурен препъникамък: огромната част от критичните бизнес данни (транскрипти за поддръжка, системни логове, продуктови каталози и история на трансакциите) се съхранява в отворени езера от данни с обем от стотици петабайти [1]. Инженерният екип на Onehouse обяви пускането на Lakegres — високопроизводително решение, което въвежда нативно векторно търсене директно върху масивите от данни в Apache Hudi и Apache Iceberg.
Досега организациите бяха принудени да изграждат тромави и скъпоструващи ETL конвейери, копиращи ембединги от езерото към специализирани векторни бази данни или затворени облачни платформи. Това водеше до дублиране на данни, забавяне на синхронизацията и астрономически сметки за лицензи.
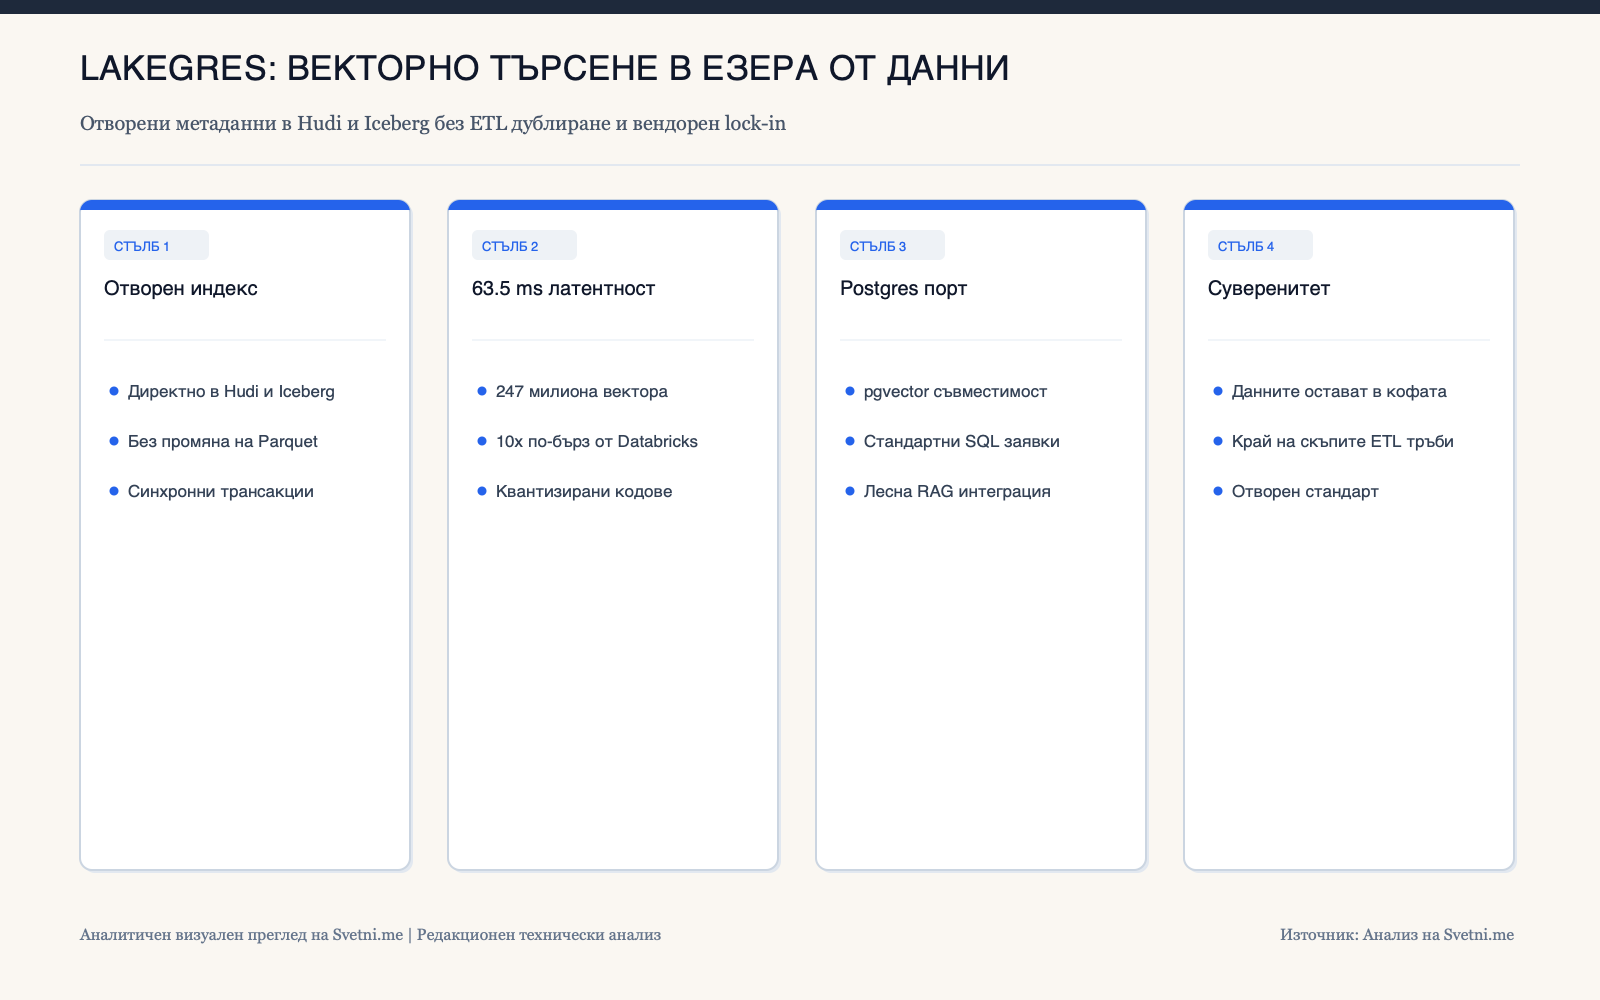
Lakegres променя правилата, като изгражда векторните индекси като производни метаданни директно в самите съществуващи отворени таблици. Подлежащите Parquet файлове не се презаписват, а индексите се обновяват автоматично при всяка нова трансакция (commit) към таблицата. Векторите се организират в клъстери и се съхраняват в компактни квантизирани формати, което позволява висока скорост при минимален отпечатък върху паметта.
Инфографика: Ключови стълбове и анализ
Постижения в скоростта и достъп през PostgreSQL интерфейс
При мащабни бенчмаркове върху 247 милиона вектора Lakegres демонстрира медианна латентност на заявките от 63.5 милисекунди при топъл кеш — приблизително десет пъти по-бързо от комерсиалното решение Databricks AI Search.
Едно от най-големите предимства на Lakegres е неговият интерфейс: системата предоставя PostgreSQL-съвместим порт с пълна поддръжка на синтаксиса на pgvector. Софтуерните разработчици и рамките за RAG (Retrieval-Augmented Generation) могат да използват познатите SQL заявки и библиотеки, без да се налага да изучават нови клиентски SDK или да пренаписват съществуващи интеграции.
Архитектурен суверенитет: Отворените стандарти печелят над затворените екосистеми
Появата на Lakegres бележи победа за концепцията за отворен софтуерен стек за данни. Много от големите доставчици на облачни складове публично подкрепят отворените таблични формати, но умишлено пазят векторните си индекси в проприетарни затворени формати, за да задържат клиентите си заключени в техните платформи.
Възможността векторният индекс да бъде управляван изцяло в собствената кофа на организацията в стандартизиран отворен формат премахва риска от вендорен lock-in.
В дългосрочен план това развитие ще ускори демократизацията на корпоративния изкуствен интелект. Когато мащабното векторно търсене стане естествено свойство на самото езеро от данни, бариерите пред малките и средни предприятия да създават интелигентни корпоративни агенти върху собствените си петабайтови архиви окончателно ще паднат.