Отворените VLM модели съкратиха цената за дигитализация на милион страници под $130 след петкратен спад за 18 месеца
Източник: The Decoder / Hugging Face
Сравнителният бенчмарк: От RolmOCR до LightOnOCR-3-0.8B
Преобразуването на масивни физически книжни фондове и архивни документи в структуриран дигитален текст премина през драматична икономическа и технологична трансформация [1]. Задълбочено сравнително изследване, проведено от експерта Даниел ван Стрийн от Hugging Face, доказа, че новото поколение компактни визуално-езикови модели (VLM) е намалило цената за оптично разпознаване на символи над пет пъти за последните 18 месеца.
Ван Стрийн подлага на стрес-тест осем отворени невронни модела върху корпус от 850 страници от изключителна трудност: антикварни книги по естествена история, първото издание на Encyclopaedia Britannica от 1771 г., както и ръкописни и машинописни държавни архиви.
Всички модели са тествани върху еднакъв хардуер за GPU изчисления — графичен ускорител Nvidia RTX PRO 6000, нает през облачната инфраструктура на Hugging Face на фиксирана цена от $2.75 на час. Резултатите разкриват шеметна еволюция:
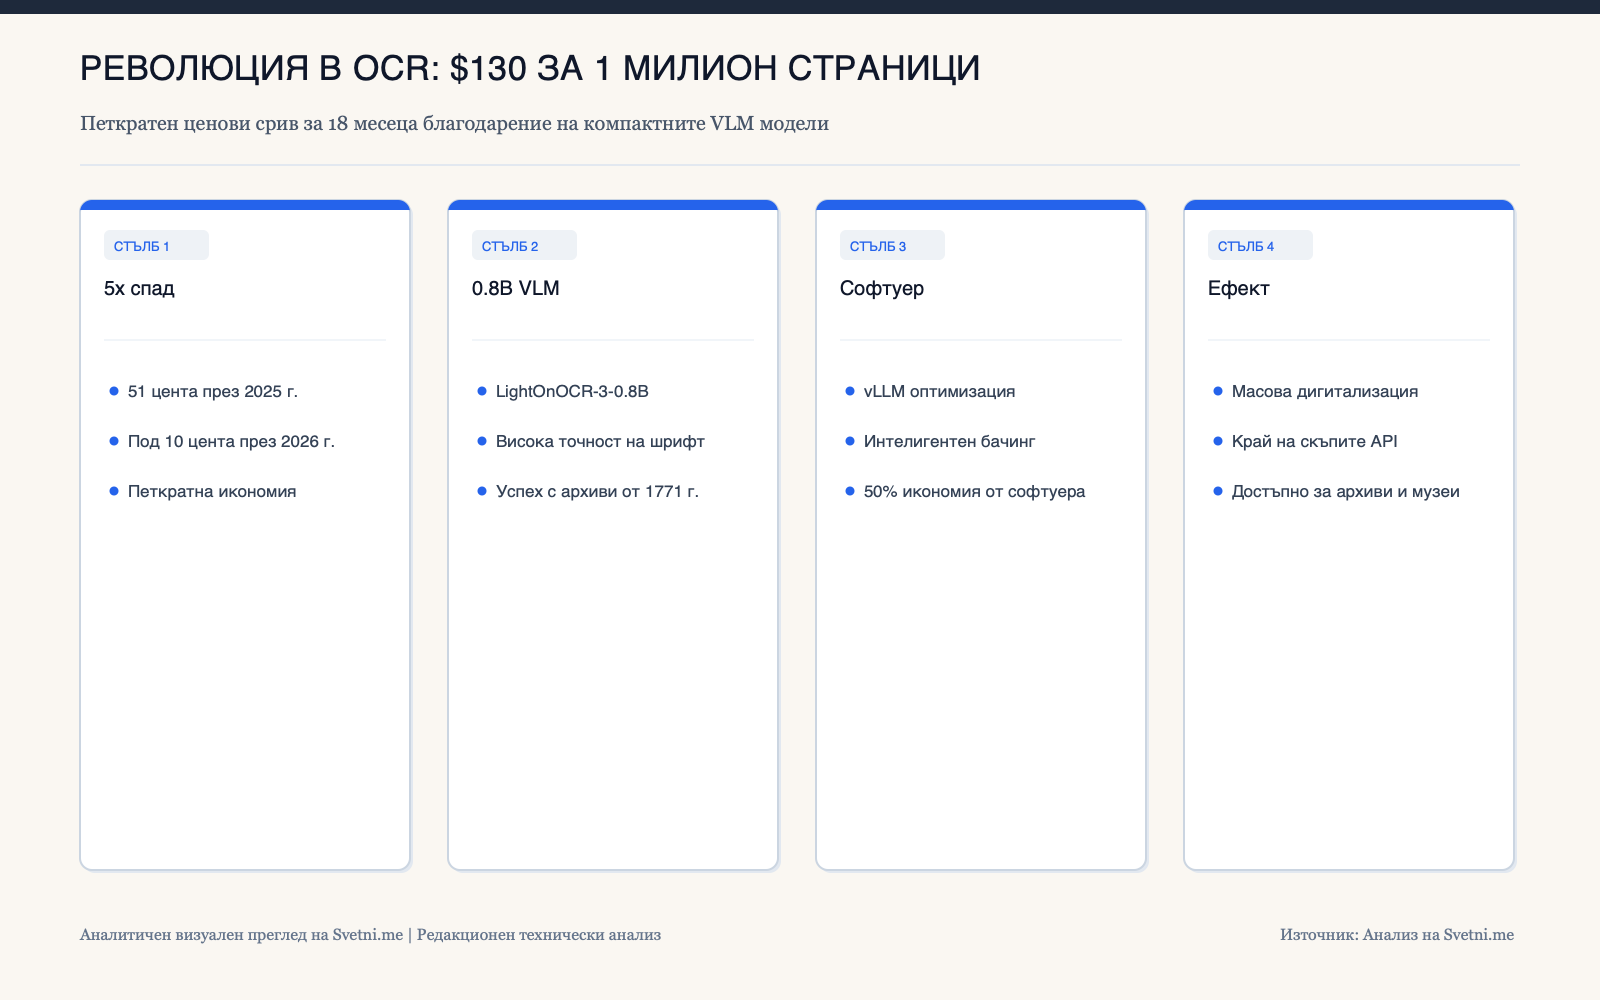
- Най-старият тестван модел от април 2025 г. (RolmOCR) изисква 51 цента за обработка на 1000 страници.
- Най-новият модел от октомври 2026 г. — ултракомпактният LightOnOCR-3-0.8B — обработва същите 1000 страници за по-малко от 10 цента.
- Цялостното разпознаване на един милион комплексни страници днес струва между $65 и $130 в облачен наем на GPU, запазвайки високо ниво на точност на символите и правилно разпознаване на таблици.
Инфографика: Ключови стълбове и анализ
Силата на софтуерната оптимизация: Повече спестявания от самия код, отколкото от теглата
Един от най-важните изводи от изследването е, че оптимизацията на конвейера за инференция носи поне толкова икономии, колкото и усъвършенстването на самите тегла на моделите.
Използването на модерни разпределени двигатели за изпълнение (като vLLM), адаптивното пакетиране на заявките (batch scheduling), динамичното намаляване на резолюцията на сканираните файлове до оптималния праг на четимост и премахването на празни страници намаляват сметките двойно. Въпреки това изследването отбелязва, че някои модели все още страдат от халюцинации върху празни полета или циклично повтаряне на един и същ текстов пасаж.
Демократизация на световната памет: Краят на скъпите проприетарни API за документи
Сривът в разходите за интелигентен анализ на документи има колосални социални и културни последици. Доскоро дигитализацията на национални архиви, общински регистри и университетски библиотеки изискваше бюджети за милиони долари, плащани предимно към затворените облачни услуги на водещите технологични монополисти.
Днес възможността цял исторически архив да бъде превърнат в търсим, семантично индексиран корпус срещу скромните $130 на милион страници отваря вратите за масово съхранение на човешкото знание.
Това развитие доказва, че малките, тясно специализирани отворени модели често превъзхождат гигантските мултимилиардни невронни мрежи в конкретни практически задачи, освобождавайки обществените институции от скъпа финансова зависимост.