Feedzai оптимизира реално-времевото машинно обучение чрез компактно представяне на състоянията и селективен запис
Източник: Feedzai Techblog / Feedzai Engineering
Тесният капацитет на цикъла четене-модификация-запис (Read-Modify-Write)
В съвременната глобална финансова инфраструктура борбата с автоматизираните финансови измами се води в мащаб от десетки милисекунди [1]. Всяко картово плащане, междубанков превод или незабавно разплащане изисква комплексна оценка на риска, преди трансакционният шлюз да върне отговор на терминала. Инженерният екип на лидера в банковата сигурност Feedzai публикува задълбочен технически обзор, разглеждащ скритото системно тясно място (bottleneck), което заплашва мащабируемостта на съвременното машинно обучение в реално време: латентността при съхранение на динамичните поведенчески състояния.
При обработката на поточни данни в реално време предиктивните модели не оценяват всяка трансакция изолирано. Ефективното откриване на финансови измами разчита на извличане на контекстуални характеристики (features), отразяващи динамични профили: брой плащания през последните десет минути, скорост на движение на средствата между географски точки, кумулативен обем за текущия ден или стандартно отклонение от обичайното поведение на потребителя.
За да поддържат тези метрики актуални, конвенционалните архитектури разчитат на непрекъснат цикъл „четене-модификация-запис“ (Read-Modify-Write, RMW) върху персистентни бази данни с ниска латентност (като Redis, Aerospike или RocksDB). При всяко постъпващо събитие системата прочита текущия вектор със състояния, десериализира го в паметта, добавя новите стойности, преизчислява плъзгащите се времеви прозорци и го записва обратно на диска с осигурена атомарност.
Когато трансакционният обем достигне десетки хиляди заявки в секунда, операцията по запис се превръща в непреодолима бариера. Докато четенето се мащабира линейно чрез разпределено кеширане и реплики, персистентният запис изисква синхронизация, блокиране на редове (row locks) и запис в журнал за трансакции (WAL). В резултат на това опашките за входно-изходни операции (I/O contention) рязко нарастват, довеждайки до непредвидими скокове в опашната латентност (p99 и p99.9), които надхвърлят допустимите лимити на банковите регулатори.
Математически пробив: Адаптивно филтриране на събития за „тежки субекти“ (Heavy Hitters)
За да преодолее физическите ограничения на дисковите подсистеми, инженерният екип на Feedzai прилага задълбочен математически анализ на реалния трафик в платежните мрежи. Данните показват екстремна степен на асиметрия (разпределение по закона на Ципф): по-малко от един процент от наблюдаваните субекти — предимно големи платформи за електронна търговия, супермаркети, бензиностанции и платежни портали — генерират над 60% от целия обем трансакционни събития.
От гледна точка на статистическата теория всяко ново събитие, генерирано от такъв „тежък субект“ (heavy hitter), носи пренебрежимо малко количество нова ентропия. Ако един онлайн търговец вече е обработил 50 000 успешни плащания в рамките на последния час, добавянето на още едно плащане променя плъзгащата се средна стойност или дисперсията с части от хилядната на процента. Въпреки това конвенционалният конвейер изпълнява пълен персистентен запис на всеки няколко милисекунди, блокирайки ценни дискови канали.
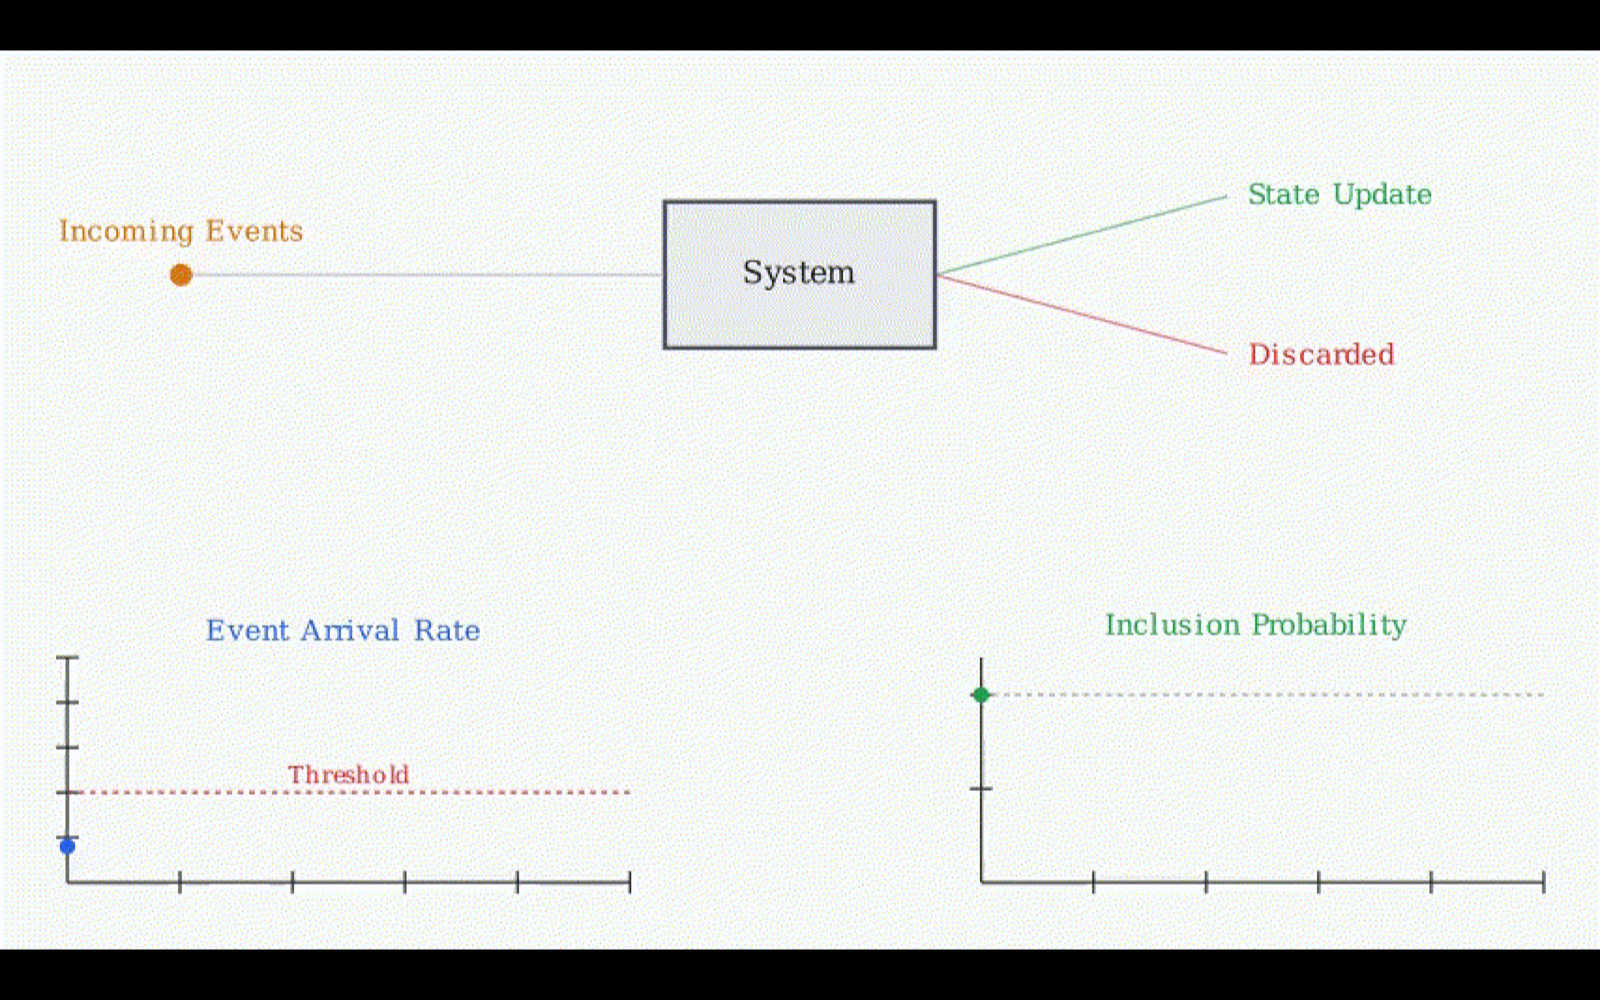
Решението на Feedzai въвежда адаптивен механизъм за селективно филтриране на записите:
- Динамично разпознаване на честотата: Системата следи постъпващия поток чрез компактни вероятностни структури (Count-Min Sketch), идентифицирайки кои акаунти надхвърлят определен праг на активност в текущия времеви прозорец.
- Адаптивно пропускане на междинни записи: За високочестотни субекти системата умишлено пропуска физическото записване на част от междинните събития в постоянната база данни. Пресмятането на характеристиките за текущата трансакция се извършва в работната памет на обработващата нишка, но състоянието в базата данни се синхронизира само през определени интервали или при регистриране на статистически аномалии.
- Пълна прецизност за нискочестотни акаунти: За стандартните крайни потребители, които извършват едва няколко плащания дневно, всеки запис се съхранява незабавно и безусловно, запазвайки 100% от аналитичната точност там, където измамите са най-вероятни.
Чрез този подход Feedzai постига съкращаване на операциите по запис с над 42%, без да се компрометира ROC-AUC кривата на моделите за класификация на риска.
Компактни състояния и неблокиращи плъзгащи се прозорци
Второто ключово подобрение в архитектурата засяга формата, в който самите агрегации се пазят в паметта. Традиционното съхранение на сурови времеви редове за всеки потребител изисква нарастващ обем памет и скъпоструваща Garbage Collection пауза при изтриване на стари събития.
Feedzai преминава към компактно представяне на състоянията чрез дискретизирани времеви кофи (binned time-buckets) и lock-free плъзгащи се агрегации. Вместо да се съхранява списък с времеви маркери на всяко плащане, историята се компресира в масив с фиксиран размер, където всяка клетка представлява обобщена статистика (сума, квадратичен сбор за дисперсия, минимална и максимална стойност) за даден подинтервал.
Когато времевият прозорец напредне, най-старата клетка се нулира чрез кръгов буфер без разместване на памет и без блокиране на конкурентните нишки за четене. Това осигурява строго константна сложност $O(1)$ както за актуализация, така и за извличане на характеристиките, елиминирайки деградацията на производителността при пикови натоварвания.
Системни архитектурни и макроикономически последици: Преосмисляне на състоянията в разпределените системи
Технологичният пробив, демонстриран от Feedzai под мотото „да постигнеш повече, като съхраняваш по-малко“, надхвърля рамките на банковия сектор и поставя фундаментални въпроси пред архитектурата на съвременните разпределени системи. В продължение на десетилетия инженерите по бази данни следваха догмата за абсолютната детерминистична консистентност, изискваща всеки байт от всяко събитие да бъде надеждно запечатан върху магнитен или флаш носител.
В ерата на високоскоростните невронни конвейери и автономните агентни системи тази консервативна философия се сблъсква с икономическата реалност на облачните бюджети:
- Разходна оптимизация на инфраструктурата: Базите данни с висока пропускателна способност за запис представляват едно от най-скъпите пера в облачните инфраструктури на AWS, Google Cloud и Azure. Свиването на записите с 40% директно намалява изискванията за брой IOPS, размер на клъстерите и енергийна консумация на сървърните центрове.
- Възходът на приблизителните изчисления (Approximate Computing): В сферата на машинното обучение входните сигнали по своята същност са зашумени, а крайните решения се базират на вероятности, а не на абсолютни величини. Настояването за перфектна трансакционна консистентност при агрегиране на признаци е архитектурно разминаване между софтуерния слой и математическия модел. Преходът към приблизителни състояния с контролирана грешка позволява мащабиране на обработката до обеми, непостижими с класически релационни методи.
- Устойчивост при пазарни пикове: В моменти на екстремни пазарни събития (като черен петък или масови промоции), традиционните системи за мониторинг на измами често колабират под тежестта на собствените си дискови опашки. Адаптивното разреждане на записите действа като вграден предпазител, който автоматично поема шоковите натоварвания, без да прекъсва потока от одобрени трансакции.
Внедряването на компактни състояния и селективен запис показва пътя напред за целия софтуерен инженеринг: интелигентната оптимизация на ниво алгоритъм и математическа теория е много по-ефективна от безразборното наливане на допълнителен хардуер в претоварените сървърни шкафове.
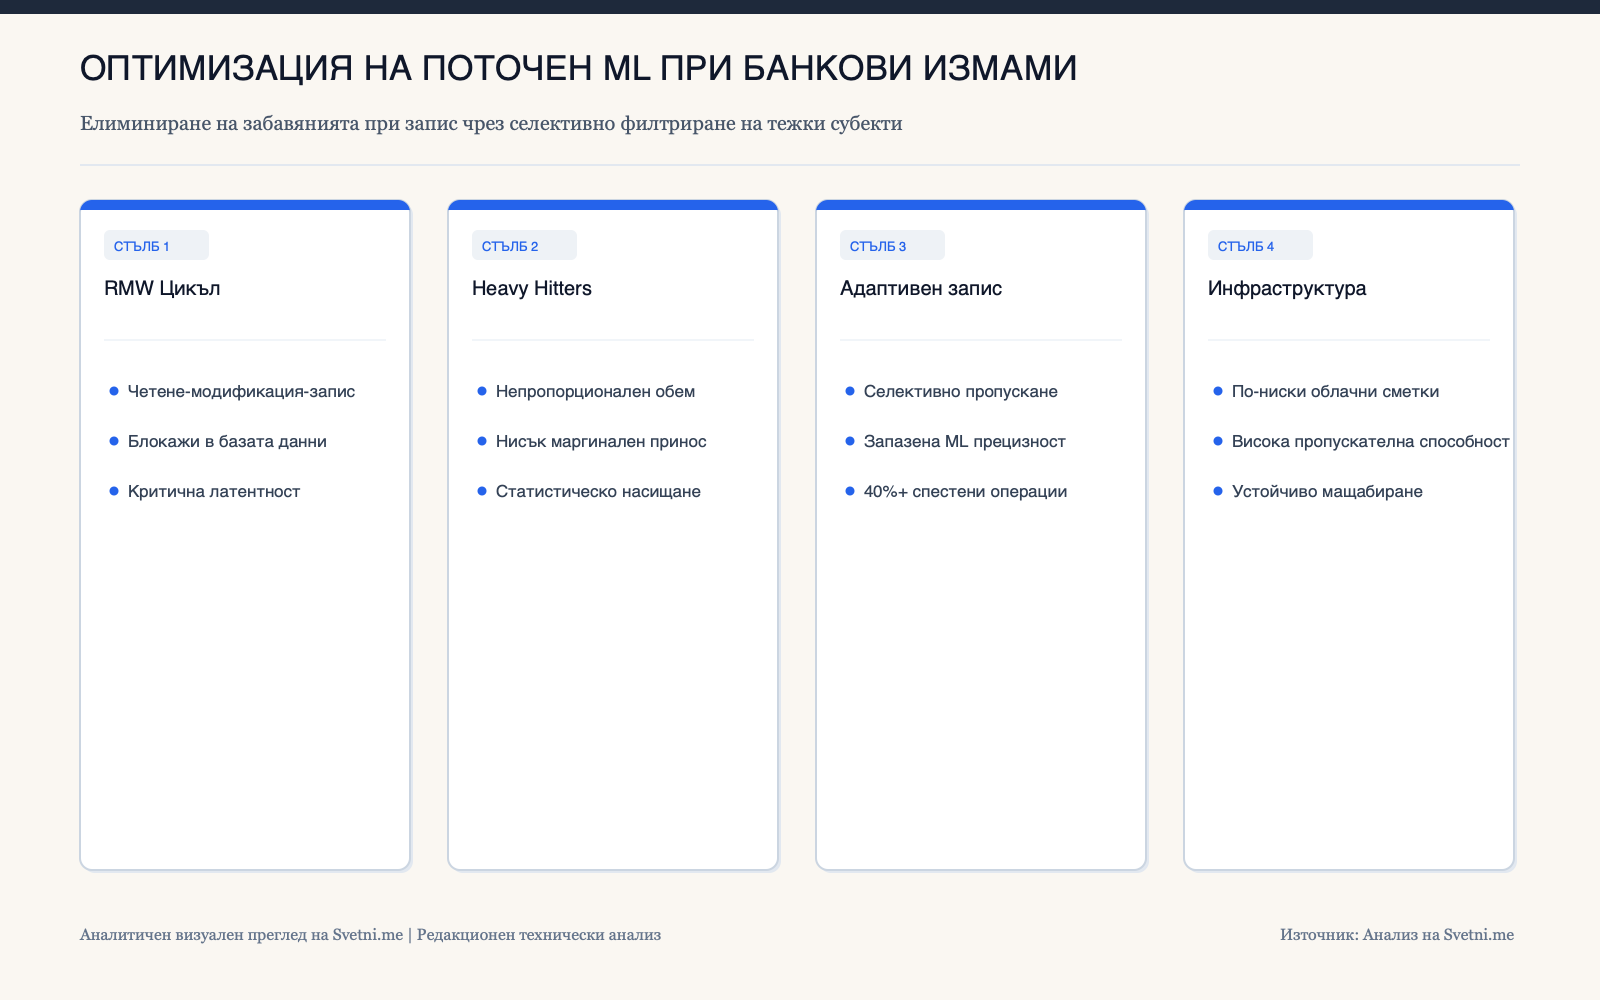
Инфографика: Ключови стълбове и анализ