Lakegres внедрява векторно търсене директно в отворените езерни таблици Hudi и Iceberg без ETL дублиране
Източник: Onehouse / Apache Hudi & Iceberg Lakehouse
Край на изолираните векторни бази и ETL фрагментацията
Съвременната корпоративна архитектура за извличане на контекст за големи езикови модели (RAG) доскоро страдаше от дълбоко структурен порок: необходимостта от изграждане на сложни, скъпи и чупливи конвейери за извличане, трансформация и зареждане (ETL) [1]. Корпоративните данни живеят в мащабни езера от данни (data lakes), организирани в отворени таблични формати като Apache Hudi и Apache Iceberg. За да се осигури семантично търсене обаче, инженерите бяха принудени да екстрахират тези масиви, да генерират вектори (embeddings) и да ги синхронизират в отделни, специализирани векторни бази данни като Pinecone, Milvus или Qdrant.
Тази фрагментация създава сериозни оперативни рискове:
- Двойни разходи за съхранение: Едни и същи терабайти от информация се съхраняват паралелно в облачния обектен склад (S3/GCS) и в паметта на специализираните векторни клъстери.
- Времево разминаване (Data Drift): Актуализациите, корекциите и изтриванията в основното езеро от данни се отразяват във векторната база със закъснение от часове или дни, водейки до халюцинации и генериране на остарели отговори от изкуствения интелект.
- Срив в сигурността и управлението (Governance): Правата за достъп на ниво редове и колони, дефинирани в езерото от данни, трябва да бъдат ръчно пресъздавани и поддържани във външната векторна система, което често води до изтичане на чувствителна информация.
Компанията Onehouse, основана от създателите на Apache Hudi, представи отговор на тази криза чрез Lakegres — новаторски изчислителен слой с отворен код, който предоставя векторно търсене на сходство директно върху съществуващите отворени езерни таблици, без каквото и да било дублиране на данни.
Архитектура на Lakegres: PostgreSQL протокол и векторизирано изпълнение върху Parquet
В основата на Lakegres стои елегантно инженерно решение: пълна съвместимост с мрежовия протокол на PostgreSQL и разширението pgvector, съчетана с директно четене на Parquet файлове в обектни складове.
Вместо да принуждава разработчиците да изучават нови клиентски библиотеки и собственически API интерфейси, Lakegres се държи като стандартен PostgreSQL сървър. Всеки съществуващ фреймуърк за изкуствен интелект — от LangChain и LlamaIndex до корпоративни вътрешни микроуслуги — може да се свърже към Lakegres чрез стандартен JDBC/ODBC или PostgreSQL драйвер. Заявките за векторно сходство (ORDER BY embedding <-> query_vector LIMIT 10) се приемат директно без никаква промяна в клиентския код.
Под капака обаче Lakegres не записва данни в традиционен монолитен релационен диск. Заявката се превежда директно във векторизиран план за изпълнение върху Apache Hudi или Apache Iceberg метаданните:
- Пренасочване и филтриране на метаданни: Първоначално заявката използва статистиките на Hudi/Iceberg (като min/max индекси и зонови карти), за да елиминира ненужните Parquet файлове, преди да докосне векторния индекс.
- Индексиране на вектори на място (In-Situ Indexing): Lakegres генерира индекси за приблизително най-близки съседи (HNSW и IVFFlat), съхранявани като леки метаданни заедно с отворените таблици. Индексите реферират редовете директно във файловия формат на езерото.
- Хибридно търсене в един проход: Системата позволява едновременно филтриране по релационни атрибути (например
tenant_id = 'enterprise_a' AND created_at > NOW() - INTERVAL '30 days') и семантично векторно търсене в рамките на един-единствен разпределен план за изпълнение, елиминирайки нуждата от двуетапни външни обединения (joins).
Според предоставените технически бенчмаркове Lakegres постига суб-секундна латентност при търсене в таблици с десетки милиони вектори, съкращавайки разходите за инфраструктура с над 70% в сравнение с поддържането на паралелен векторен клъстер.
Архитектурен суверенитет и макроикономически последици: Свободните формати побеждават затворените екосистеми
Появата на Lakegres е емблематичен момент в еволюцията на инфраструктурата за корпоративен изкуствен интелект. Тя отбелязва началото на края за първата вълна от стартъпи за векторни бази данни, които разчитаха на изкуствено отделяне на векторните данни от корпоративното езеро.
- Триумфът на отворените формати за данни: Корпоративните клиенти категорично отказват да заключат критичните си данни в затворени облачни хранилища с проприетарни формати. Apache Iceberg и Apache Hudi вече се утвърдиха като de facto стандартът за дългосрочно съхранение. Фактът, че векторното търсене вече може да се изпълнява директно върху тях, превръща обектния склад в единствен и окончателен източник на истина (Single Source of Truth).
- Консолидация на изчислителните разходи: За CIO и техническите директори елиминирането на ETL конвейерите означава рязко свиване на „данъка за пренос на данни“ (data egress and pipeline tax). Поддържането на поточни задания, които да поддържат външни бази актуални, генерираше огромни скрити сметки в AWS и GCP. Lakegres позволява същите изчисления да се правят по заявка (on-demand) или с леки споделени ресурси.
- Стандартизация около PostgreSQL: Изборът на Onehouse да използва Postgres протокола затвърждава PostgreSQL като универсалната операционна система за данни на модерната ера. От релационни трансакции, през аналитични заявки, до векторен RAG — общият език на SQL и Postgres екосистемата намалява драстично кривата на обучение за инженерните екипи.
Lakegres доказва, че бъдещето на генеративния изкуствен интелект не изисква пренаписване на правилата за съхранение на корпоративни данни, а интелигентно надграждане на вече съществуващите отворени езерни основи.
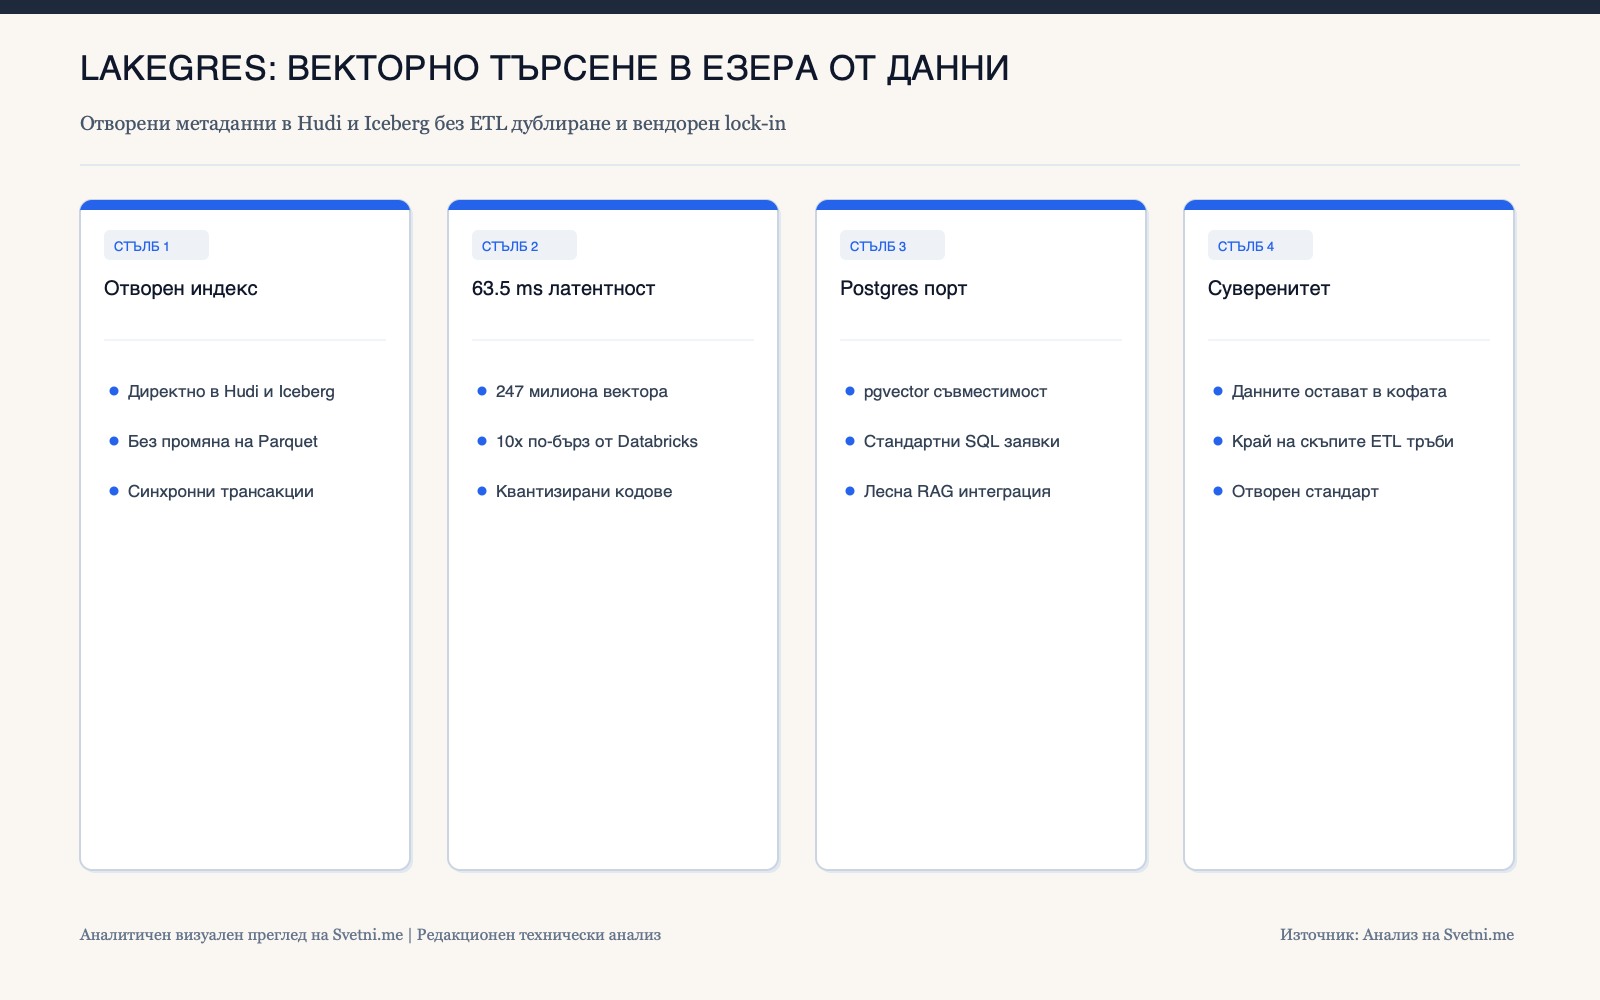
Инфографика: Ключови стълбове и анализ