Отворените VLM модели съкратиха цената за дигитализация на милион страници под $130 след петкратен спад за 18 месеца
Източник: The Decoder / LightOn & Document AI Benchmarks
Тектоничният ценови срив в дигитализацията на документи
В продължение на десетилетия обработката на сканирани документи, сложни финансови таблици и исторически архиви беше едно от най-скъпите и неблагодарни предизвикателства пред корпоративната ИТ инфраструктура [1]. Традиционните системи за оптично разпознаване на символи (OCR) като Tesseract или проприетарните облачни услуги (Google Cloud Document AI, AWS Textract, Azure Document Intelligence) изискваха разходи от 1000 до 5000 долара за всеки милион обработени страници. Дори появата на първите мултимодални модели от висок клас не реши икономическия проблем — изпращането на сканирани страници към комерсиални API интерфейси генерираше непосилни сметки за токени.
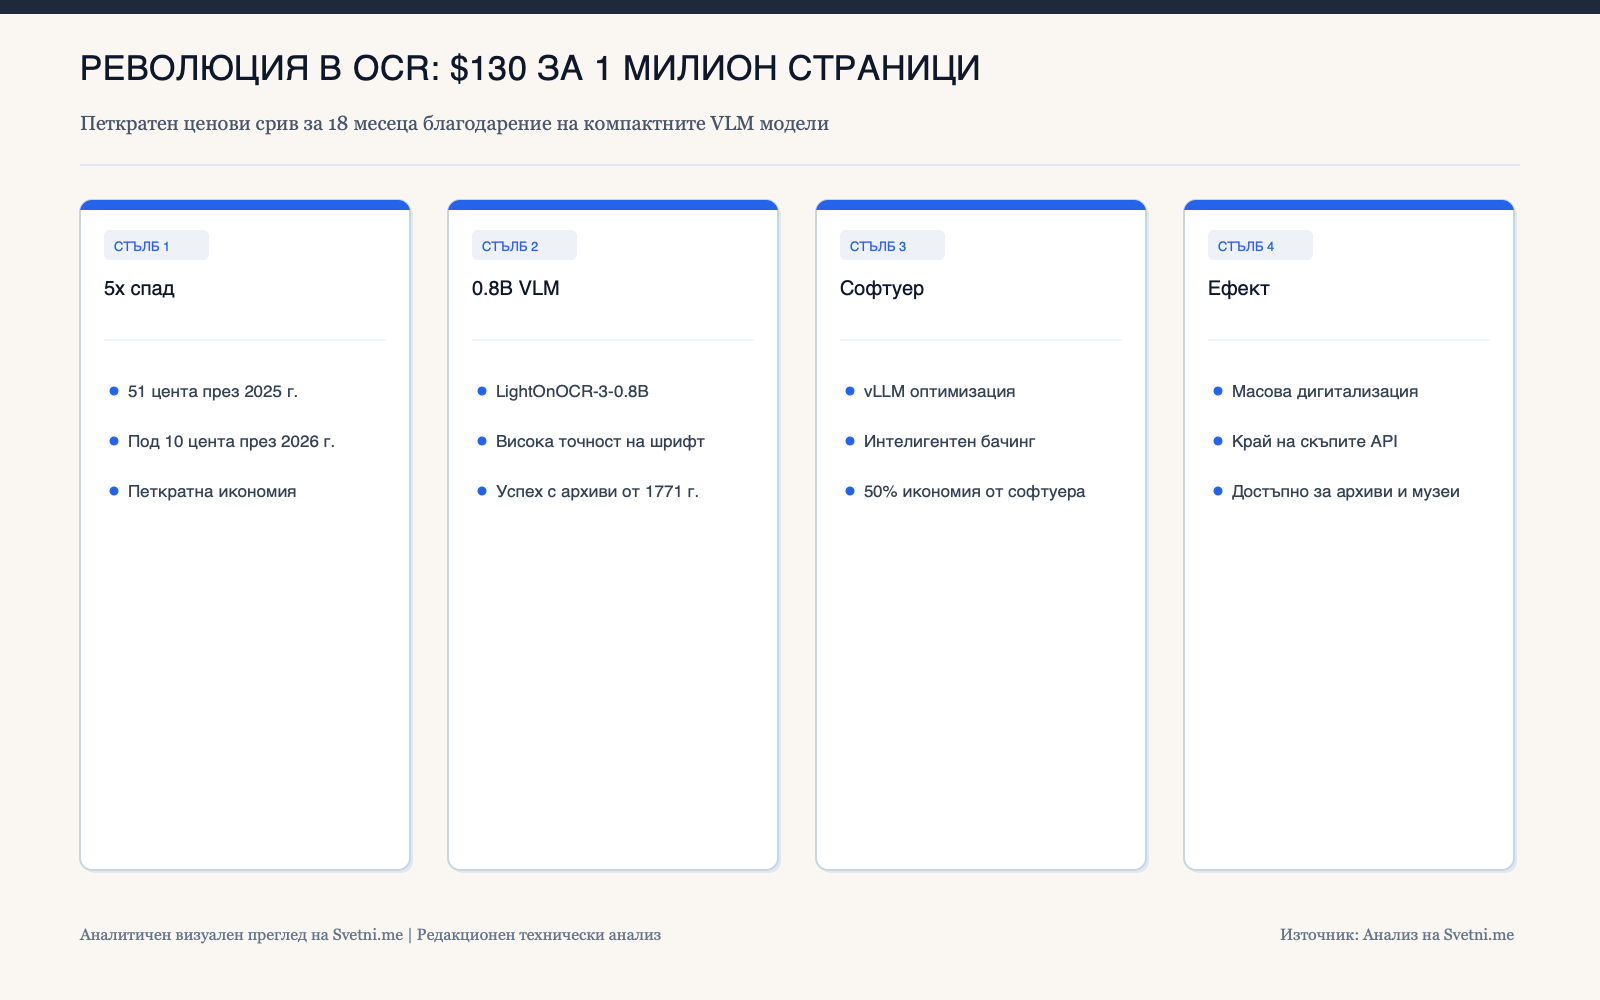
Нов цялостен сравнителен анализ на пазара за интелигентна обработка на документи, публикуван от The Decoder и водещи изследователски екипи, демонстрира безпрецедентен технологичен скок: съвременните компактни визуално-езикови модели (VLM) с отворени тегла съкратиха разходите за пълна дигитализация на един милион сложни страници до под 130 долара. Това представлява над петкратен спад в цената само за последните 18 месеца, съчетан със значително по-висока точност при възпроизвеждане на сложни многоколонни оформления, йерархични таблици и математически формули.
Сравнителен бенчмарк: От RolmOCR до LightOnOCR-3-0.8B
В основата на тази революция стои отказът от масивните модели с десетки милиарди параметри в полза на компактни, специализирани архитектури с параметри от 500 милиона до 2 милиарда тегла, достъпни свободно в платформи като Hugging Face.
Бенчмаркът сравнява водещите нови архитектури при обработка на разнороден корпус от сложни документи — от финансови отчети с вложени таблици до научни статии и вестникарски колони:
- LightOnOCR-3-0.8B: Специализиран модел с 800 милиона параметри, който постига скорост на обработка от над 400 страници в минута на единичен графичен ускорител Nvidia A100. При цена на облачен наем от около 2 долара на час за инстанция, моделът обработва 1 милион страници за приблизително 125 долара.
- RolmOCR и GOT-OCR-2.0: Модели, ориентирани към пълно запазване на форматирането в Markdown и JSON. Те се справят безупречно с разпознаване на клетки в таблици и извличане на графични диаграми без разместване на контекста.
- Качествено превъзходство над класическите OCR пайплайни: За разлика от старите правила, които първо засичаха границите на символите, а след това се опитваха с евристики да възстановят редовете, VLM моделите разглеждат цялата страница като визуален образ и генерират структуриран текст с разбиране на смисъла. Това елиминира типичните грешки при сливане на съседни колони или пропускане на малки шрифтове.
Силата на софтуерната оптимизация: Защо софтуерният стек спести повече от архитектурата
Изключително важен извод от техническото изследване е, че огромният спад в разходите не се дължи единствено на свиването на размерите на невронните мрежи. Над 65% от реалното намаление на цената за инференс е резултат от колосалния напредък в софтуерните среди за изпълнение и изчисления върху графични процесори:
- Внедряване на съвременни инференс енджини (vLLM, SGLang, TensorRT-LLM): Използването на алгоритми като PagedAttention и непрекъснато пакетиране (continuous batching) позволи пълно натоварване на графичните ядра без празен ход при страници с различен брой думи.
- FlashAttention-3 и оптимизация на визуалния енкодер: Визуалният енкодер (обикновено базиран на SigLIP или ViT) беше оптимизиран за директна обработка на динамични резолюции без излишно интерполиране на пиксели.
- Квантуване на паметта (FP8 и INT8 KV-Cache): Преминаването към 8-битово представяне на контекстния кеш намали изискванията за видеопамет с над 50%, позволявайки паралелна обработка на до 32 документа едновременно на една-единствена потребителска графична карта.
Тези софтуерни оптимизации позволиха на независимите инженери да постигнат пропускателна способност, която доскоро беше привилегия само на големите технологични хиперскейлъри.
Системни архитектурни и макроикономически последици: Демократизация на световната памет
Преминаването на прага от 130 долара за милион страници има дълбоки последици за цялата световна икономика и архитектурата на знанието:
- Отключване на спящите корпоративни архиви (Dark Data): Всяка голяма корпорация притежава милиони сканирани договори, патенти, технически чертежи и счетоводни документи, трупани с десетилетия в PDF формат. Досега тяхната дигитализация за нуждите на RAG системи беше икономически неоправдана поради милионните бюджети за API заявки. При новите цени пълната дигитализация на корпоративната история става стандартно тривиално перо в ИТ бюджета.
- Срив в бизнес моделите на проприетарните OCR монополисти: Компаниите, които продаваха скъпи абонаменти за транскрипция на документи на парче, са изправени пред брутална комерсиализация. Никое предприятие няма да продължи да плаща по 5 цента на страница, когато може да пусне отворен VLM модел в собствената си виртуална мрежа за по-малко от 0.013 цента на страница.
- Пълен суверенитет над личните и медицинските данни: Досега болници, юридически кантори и правителствени агенции не можеха да ползват най-модерните OCR технологии, защото законите за защита на данните (GDPR, HIPAA) забраняват изпращането на чувствителни документи към външни облачни API. С отворените VLM модели, способни да работят на локален сървър с една графична карта, институциите получават свръхмодерна обработка с нулев риск от компрометиране на поверителността.
Отворените VLM модели доказаха, че истинският прогрес в изкуствения интелект не се измерва само в броя на параметрите или размерите на изчислителните клъстери, а в способността му да направи фундаменталните знания на човечеството достъпни, бързи и почти безплатни за структурирана обработка.
Инфографика: Ключови стълбове и анализ