ByteDance доказва, че повечето фази при обучението на ИИ агенти са излишни, и пуска конкурентния отворен модел Axion 1.0
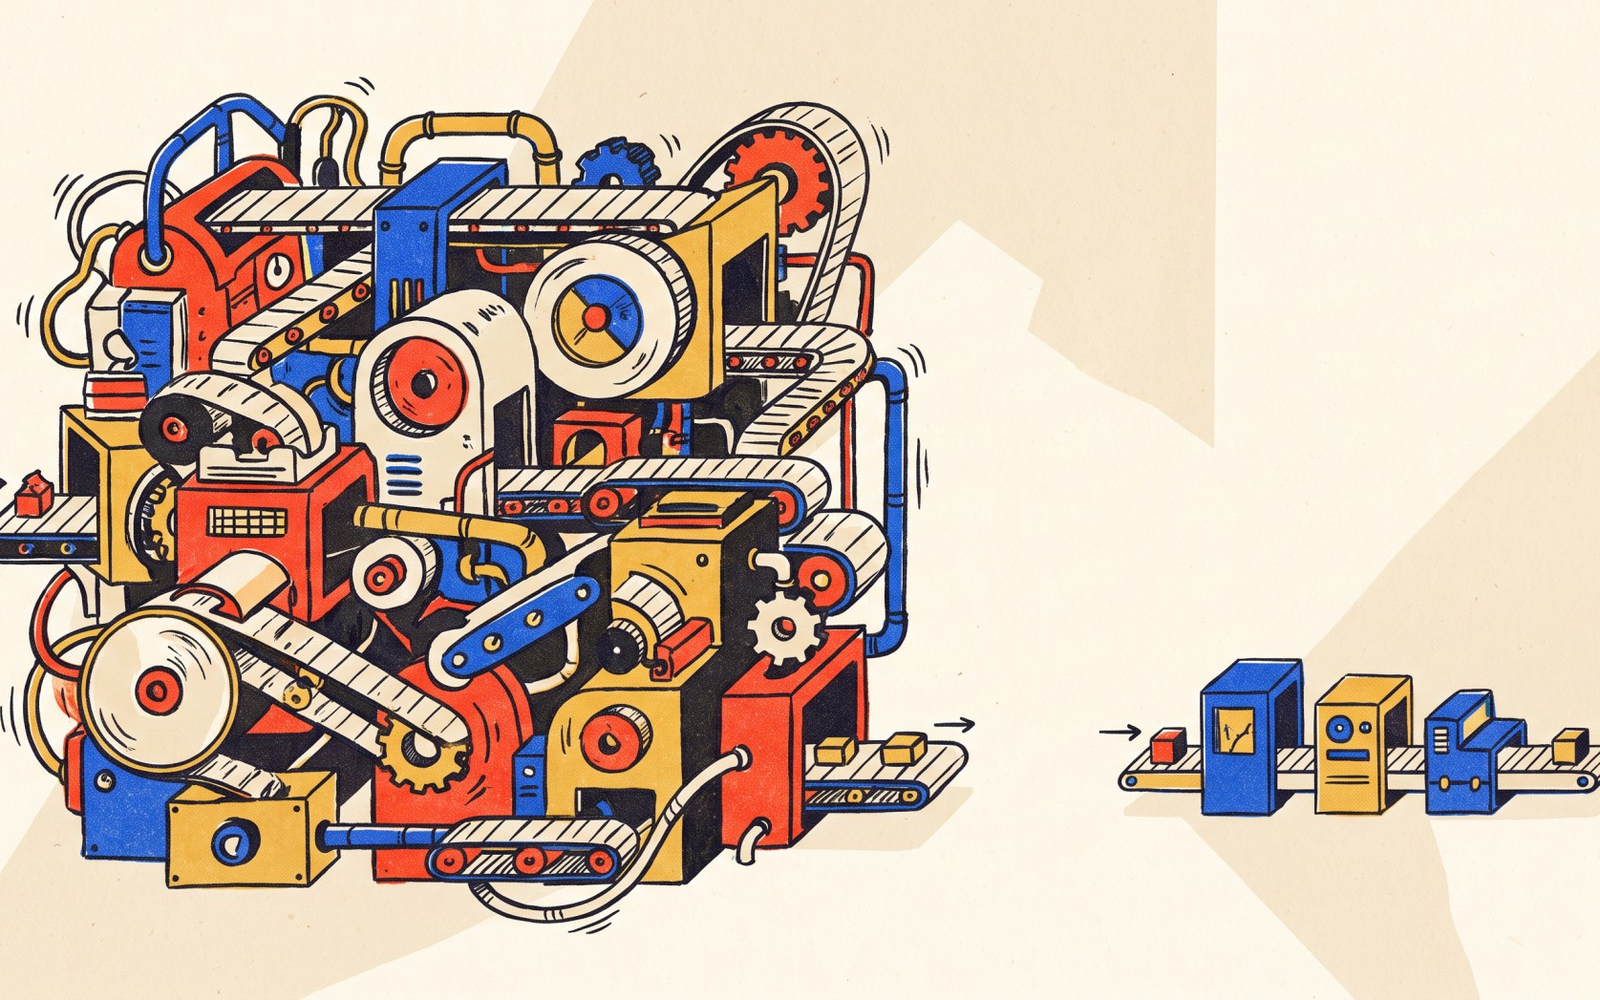
Източник: The Decoder / Оптимизиран трифазен тренировъчен пайплайн на ByteDance Axion 1.0
Изследователски екип от компанията майка на TikTok — ByteDance — в сътрудничество с учени от няколко американски университета представи Axion 1.0, нов модел за автономни ИИ агенти, който се изравнява в бенчмарковете с водещите комерсиални системи на OpenAI и Anthropic след едва три прецизно организирани фази на обучение, съобщава The Decoder [1]. В придружаващия научен труд авторите аргументират, че повечето насложени етапи в съвременните тренировъчни конвейери са излишни, а пълният пакет от модели с отворени тегла, тренировъчни набори от данни и програмен код на Axion 1.0 е публикуван свободно за научната общност [1].
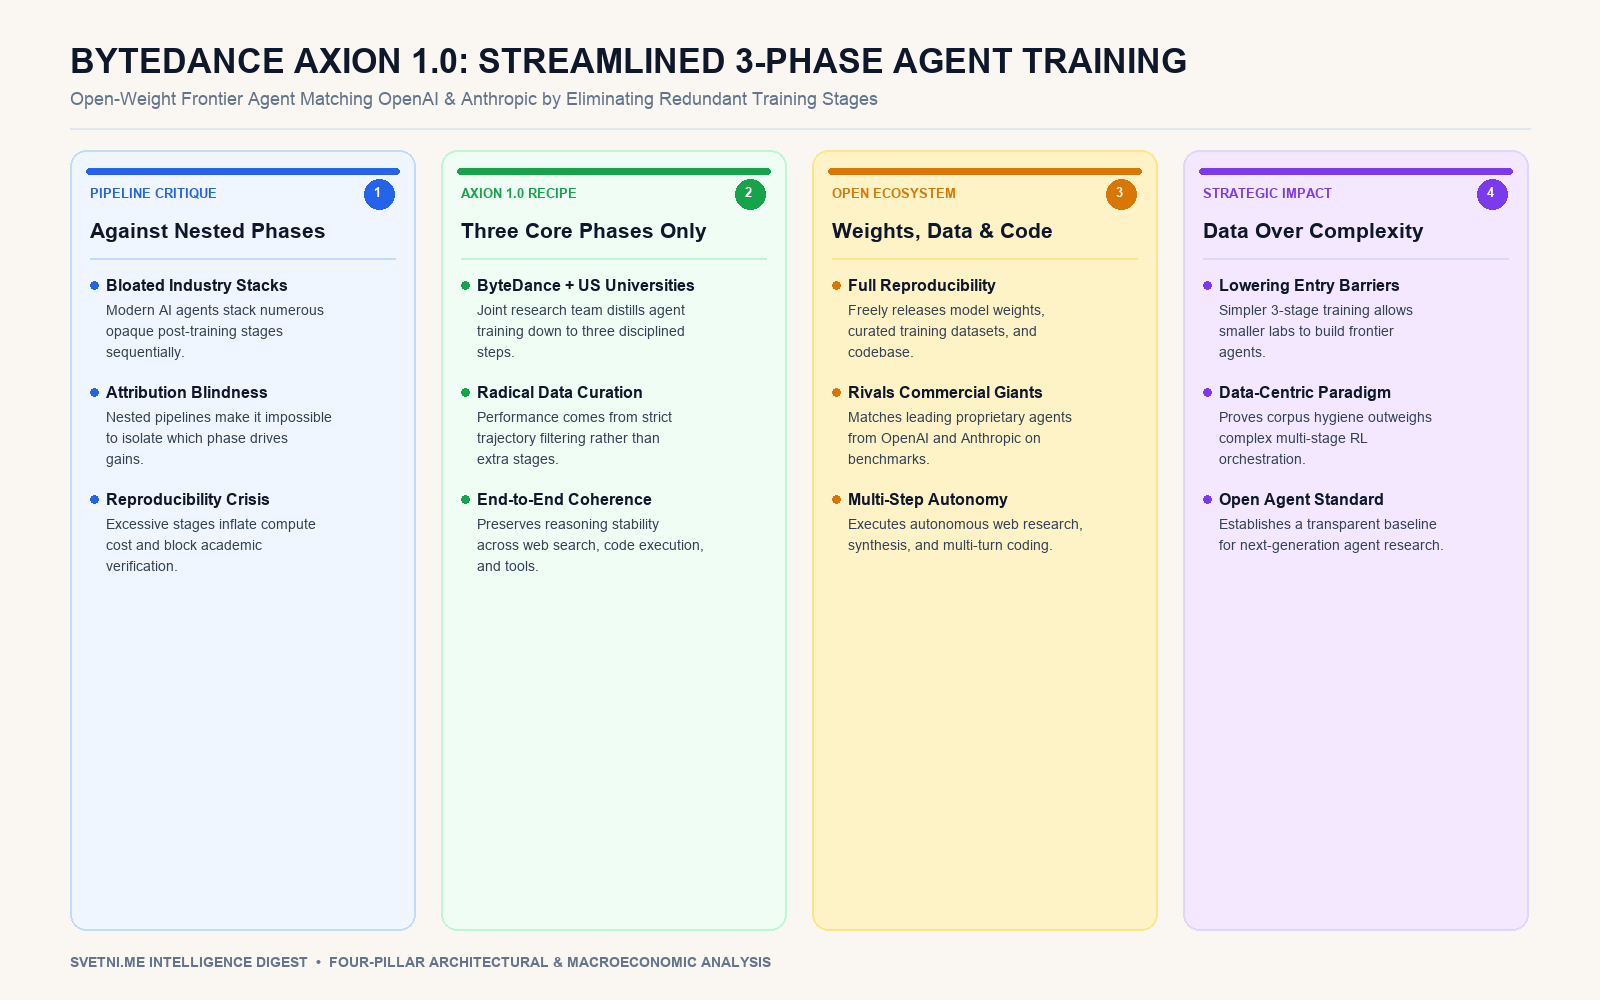
Инфографика: Ключови стълбове и анализ
Кризата на вложените конвейери: Когато никой не знае коя фаза реално помага
От съвременните агентни модели се очаква да извършват самостоятелно проучване в уеб пространството, да пишат и изпълняват програмен код, да извикват външни инструменти и да решават дълги многостъпкови задачи [1]. За да постигнат тези умения, индустриалните лаборатории през последните две години изградиха все по-сложни, многослойно вложени тренировъчни конвейери — натрупвайки десетки последователни фази на междинно дообучение, специализирано инструкционно настройване, отхвърлящо семплиране и множество каскадни цикли на обучение с подкрепление (RL).
Според изследователите от ByteDance и американските университети тази архитектурна претрупаност е довела до два фундаментални проблема в машинното обучение [1]. Първо, при толкова много взаимно преплетени етапи става практически невъзможно да се изолира и измери коя конкретна тренировъчна фаза действително носи подобрение в агентните способности и коя само компенсира артефакти от предходната. Второ, разходите за изчислителни ресурси и инженерна оркестрация растат лавинообразно, правейки независимото научно възпроизвеждане на резултатите непосилно за академичните институции.
Рецептата на Axion 1.0: Три фази и радикален фокус върху курацията на данни
За да опровергае мита за задължителната многофазова сложност, съвместният екип изчиства тренировъчния процес до само три ясно дефинирани и строго контролирани стъпки, върху които изгражда модела Axion 1.0 [1]. Вместо да добавят нови алгоритмични надстройки и корекционни цикли, учените насочват целия си инженерен ресурс към безкомпромисното качество, филтриране и структуриране на тренировъчните траектории.
Резултатът от тази трифазна дисциплина е модел, който демонстрира висока стабилност при автономно търсене в интернет, синтез на първични източници и изпълнение на код. В стандартните индустриални изпитания за агентни системи Axion 1.0 постига резултати, напълно конкурентни на водещите затворени комерсиални модели от OpenAI и Anthropic, доказвайки, че чистотата на информационния сигнал в данните има много по-голяма тежест от броя на тренировъчните фази [1].
Пълна отвореност за възпроизводима наука: Тегла, данни и код
За разлика от много корпоративни анонси, които публикуват единствено крайните параметри на модела без информация за процеса на неговото създаване, проектът Axion 1.0 залага на пълна научна прозрачност [1]. Екипът предоставя за свободно изтегляне не само финалните тегла на модела, но и курираните тренировъчни данни, както и целия софтуерен стек за провеждане на трите фази на обучение.
Тази откритост позволява на независими изследователи и по-малки лаборатории директно да инспектират как точно са конструирани агентните траектории, да възпроизведат обучението от нулата и да адаптират трифазната методология към специализирани индустриални домейни без нужда от гигантски сървърни ферми.
Системни и стратегически импликации: Завръщането към центрирания върху данните изкуствен интелект
Публикацията на ByteDance и американските академични партньори около Axion 1.0 изпраща силно отрезвяващо послание към глобалната индустрия за изкуствен интелект. През последните години сложните многофазови конвейери за следтренировъчна обработка (post-training) се използваха от големите технологични корпорации като своеобразен защитен ров — внушавайки, че само организации със стотици инженери по RL оркестрация могат да обучат надеждни ИИ агенти.
Доказателството, че само три прецизни тренировъчни фази, подкрепени от висококачествена курация на данни, са достатъчни за изравняване с комерсиалните флагмани на OpenAI и Anthropic, радикално снижава бариерата за навлизане на пазара. Когато целият пакет — модели с отворени тегла, курирани данни и тренировъчен код — е свободно достъпен, конкурентното предимство се измества от тайните многостъпкови рецепти към способността на организациите да събират и верифицират автентични, висококачествени данни от реални работни процеси. В дългосрочен план тази стандартизация и опростяване на обучението ще ускори иновациите в цялата отворена екосистема и ще направи разработката на специализирани автономни агенти по-бърза, по-предсказуема и многократно по-евтина.