Скритите водни знаци на Claude: Как работи SynthID-Text и защо публичната проверка остава заключена
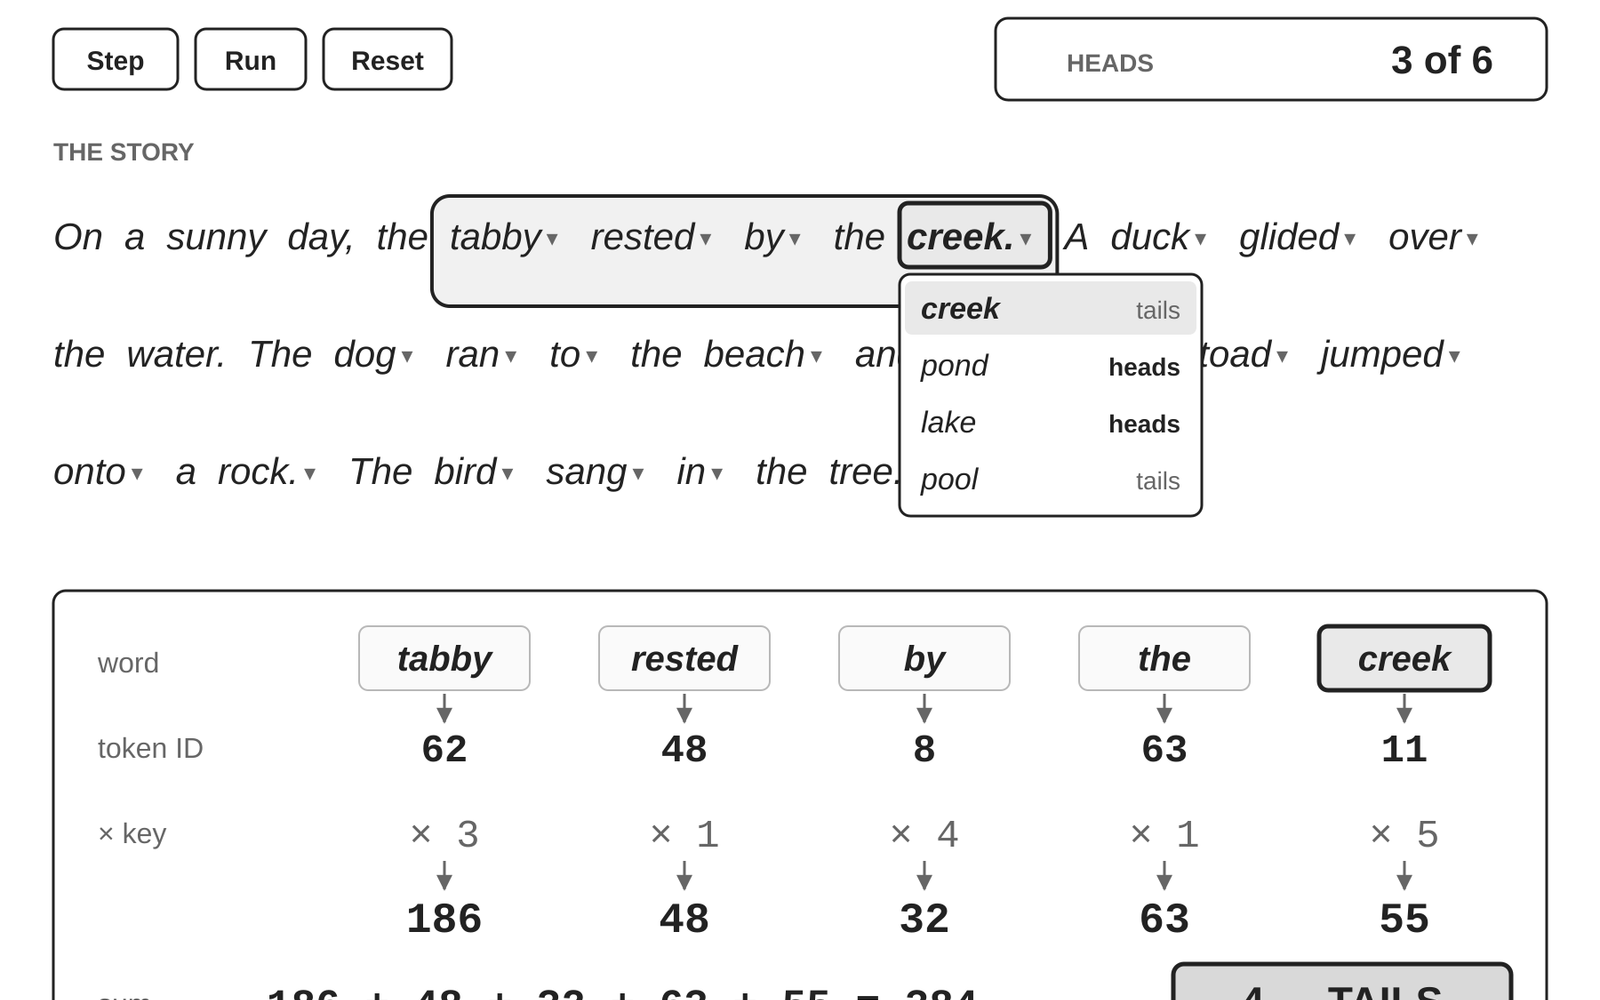
Източник: O'Reilly Radar – Интерактивен симулатор „Be the Watermark“, демонстриращ изчисляването на детерминирани хвърляния на монета върху прозорец от 5 токена и секретен ключ за откриване на воден знак
Според технически анализ, публикуван в O'Reilly Radar, почти всеки текст, генериран днес от моделите Claude на компанията Anthropic, съдържа невидим машинночетим воден знак, който обаче не може да бъде проверен свободно от крайните потребители [1]. Въвеждането на криптографско маркиране на синтетичен текст цели да ограничи неконтролираното наводняване на интернет с нискокачествено автоматизирано съдържание („slop“), но официалният регулаторен двигател зад мярката е Законът за изкуствения интелект на ЕС (EU AI Act), който задължава доставчиците да маркират генерираното от ИИ съдържание по машинно разпознаваем начин.
Според официалната документация за поддръжка на Anthropic всички най-нови модели на компанията, както и част от по-старите версии, вече вграждат текстови водни знаци във всяка платформа и интерфейс, където се използва Claude, в световен мащаб. Докато Google прилага текстов воден знак в приложението Gemini още от 2024 г., а през октомври 2026 г. OpenAI обяви добавянето на подобен механизъм за текстовете от ChatGPT и Codex на територията на Европейския съюз, нито една от водещите лаборатории не предоставя публичен детектор за проверка на текст – дори порталът synthid.com на Google проверява единствено изображения, видео и аудио, но не и текстови пасажи [1].
Архитектура на генерацията: Токени, вероятности и ролята на изпълнителната среда (Runner)
За да се разбере как един воден знак се вгражда в изхода на големите езикови модели (LLM), не е необходимо да се анализират вътрешните трансформаторни блокове, а само входно-изходният конвейер и неговият последен етап [1]. Моделите никога не обработват директно азбучни букви, а работят изцяло с числови идентификатори на токени (token IDs) от фиксиран предварително дефиниран речник:
Токенизация и числови речници: Всеки модел разполага с фиксиран речник от думи и части от думи. Например ранният модел GPT-2 на OpenAI от 2019 г. има речник от точно 50 257 токена. Когато входният текст съдържа думата
" strawberry"с водещ интервал, токенизаторът я преобразува в един-единствен токен с номер41236. Ако обаче"strawberry"стои в самото начало на текста без интервал пред нея, токенизаторът я разделя на три отделни части от речника:st,rawиberry.Контекстен прозорец и вероятностно разпределение: Масивът от числови идентификатори на токени постъпва в контекстния прозорец на модела. Работата на самата невронна мрежа приключва с изчисляването на вероятност за всеки отделен токен от речника да бъде следващата дума в текста, като сумата от всички вероятности е точно 100%. При един и същ контекстен прозорец моделът винаги връща едни и същи детерминирани вероятности.
Изпълнителната среда (Inference Runtime / Runner): Самият модел никога не избира конкретна дума. Изборът на следващ токен се извършва от отделна програма – изпълнителната среда за инференция (runner). Именно тя хвърля „заровете“ и избира токен на случаен принцип пропорционално на изчислените вероятности, след което го добавя към контекстния прозорец за следващата стъпка. Всяко вграждане на текстов воден знак се осъществява изцяло вътре в този runner модул [1].
Класическият метод със „зелен списък“ (Green List) и модифициране на вероятностите
Най-интуитивният подход за скриване на статистически сигнал в работата на изпълнителната среда е разделянето на речника на две групи и лекото повишаване на вероятностите за едната група преди хвърлянето на заровете. Този механизъм е известен като метода на „зеления списък“ (green list), формулиран през 2023 г. от Джон Кирхенбауер и неговите колеги от Университета на Мериленд в научния труд „A Watermark for Large Language Models“ [1, 2].
Преди да избере следващата дума, изпълнителната среда дава числен тласък (boost) на вероятностите на всички токени от фаворизирания „зелен списък“, докато останалите токени в „червения списък“ намаляват своя относителен дял, за да се запази общата сума от 100%. В анализа на O'Reilly Radar този ефект се илюстрира чрез миниатюрен модел с речник от пет думи (cat, tree, the, by и sat), който предсказва следващия токен след думата the, когато tree и by попадат в зеления списък за тази позиция [1]:
cat (червен списък): Първоначалната вероятност от 56.3% спада на 37.9% след пренормализирането.
tree (зелен списък): Първоначалната вероятност от 20.7% се повишава след тласъка до 37.9%, изравнявайки се с водещия кандидат cat.
the (червен списък): Вероятността намалява от 12.6% на 8.4%.
by (зелен списък): Вероятността се увеличава от 7.6% на 13.9%.
sat (червен списък): Вероятността спада от 2.8% на 1.9%.
Тъй като фиксиран зелен списък би довел до забележимо повторение на едни и същи думи, изпълнителната среда генерира нов зелен списък за всяка следваща позиция, като комбинира секретен криптографски ключ с идентификатора на непосредствено предхождащия токен. При проверка детекторът не се нуждае от самия езиков модел, а само от токенизатора и секретния ключ: ако зеленият списък обхваща половината речник, в обикновен човешки текст около 50% от токените ще бъдат „зелени“ по случайност, докато в маркиран текст техният дял е статистически значимо по-висок [1, 2].
Какво всъщност използва Claude: Алгоритъмът SynthID-Text и турнирното хвърляне на монета
От Anthropic официално потвърждават, че водният знак в Claude представлява адаптация на SynthID-Text – метод, разработен от Google DeepMind, публикуван в списание Nature през 2024 г. и използван в приложението Gemini [3, 4]. Подобно на зеления списък, SynthID-Text работи изцяло в изпълнителната среда (runner), но вместо да изкривява вероятностите на модела, той променя единствено източника на псевдослучайност, използван за избор между думите кандидати [1, 4].
Вместо да модифицира вероятностното разпределение, изпълнителната среда хвърля заровете няколко пъти, извличайки малък набор от думи кандидати за следващата позиция. За всеки кандидат системата извършва детерминирано „хвърляне на монета“ (ези или тура), чийто резултат зависи от секретния ключ, самия кандидат и няколкото думи непосредствено преди него. Runner модулът избира кандидат, чиято монета е показала „ези“ (heads). Ако контекстът е толкова еднозначен, че всички изтеглени кандидати са една и съща дума, реална алтернатива няма и водният знак не променя текста – сигналът се записва само в позициите, където моделът е имал реален избор между синоними или близки конструкции [1, 3].
За да онагледи математиката зад този процес, авторът на предстоящата книга на O'Reilly Be the Model представя интерактивната симулация „Be the Watermark“, базирана на речник от 75 думи (където номерът на токена е неговата азбучна позиция от 0 до 74) и 5-цифрен секретен ключ 3 1 4 1 5. За всяка дума след първите четири в текста системата умножава идентификаторите на текущата дума и четирите предходни думи по петте цифри на ключа:
При проверка на думата creek в края на петсловния прозорец
tabby, rested, by, the, creek, съответните идентификатори на токени са62,48,8,63и11.Умножени по цифрите на секретния ключ (
3,1,4,1,5), произведенията дават сумата186 + 48 + 32 + 63 + 55 = 384.Правилото на детектора определя последна цифра от
0до4като „тура“ (tails), а от5до9като „ези“ (heads); тъй като384завършва на4, думата creek дава „тура“.В началния разказ от 32 проверяеми позиции (първите четири думи „On a sunny day“ нямат четири предходни токена и не се проверяват) само 14 хвърляния са „ези“, което отговаря на случаен немаркиран текст, докато при замяна на синоними от падащите менюта до достигане на поне 60% „ези“ (20 от 32) детекторът активира индикатора „Watermark detected“ [1].
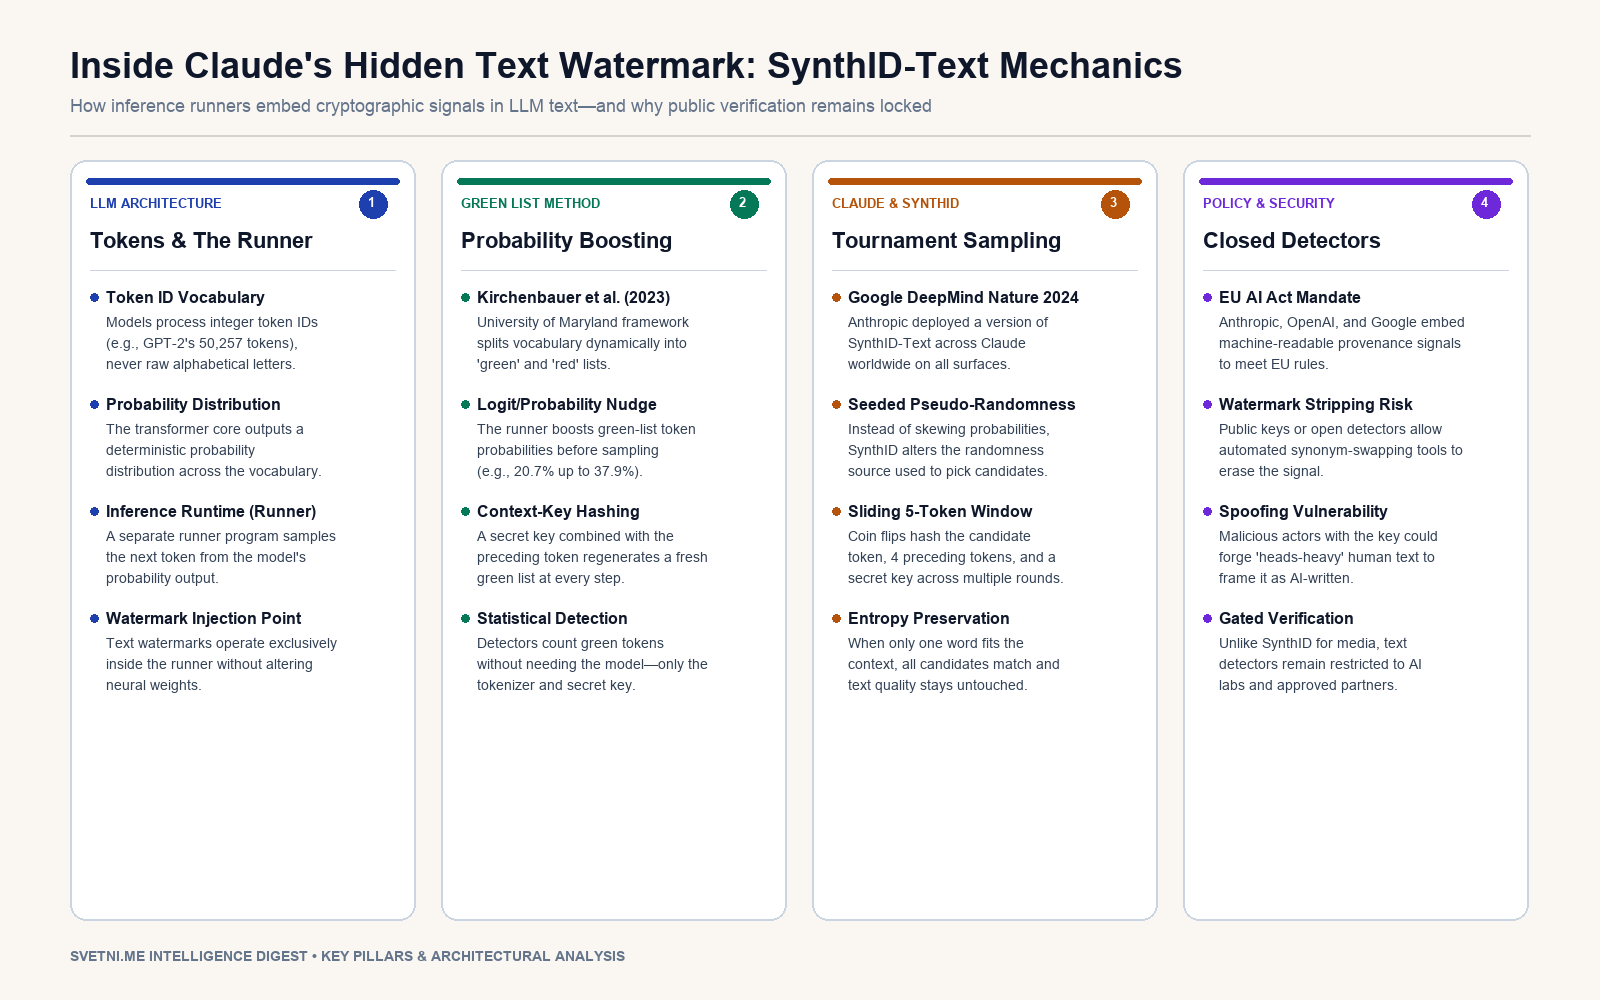
Инфографика: Ключови стълбове и анализ
Криптографска асиметрия, уязвимости към заличаване и регулаторната дилема около детекторите
Докато учебната симулация използва азбучни индекси и проста аритметична сума, реалната производствена имплементация на SynthID-Text в Claude и Gemini оперира с много по-голям секретен ключ, смесва ключа и токените чрез криптографска хеш функция, провежда няколко рунда на турнирни хвърляния на монета за всяка дума и използва специализирани детектори, обучени върху маркиран и обикновен текст за конкретния ключ [1, 3]. Въпреки тази математическа устойчивост аналитичният разбор разкрива фундаментална структурна причина защо Anthropic, OpenAI и Google държат както ключовете, така и текстовите си детектори заключени за широката публика:
Ефектът на каскадния прозорец при редактиране: Тъй като всяко хвърляне на монета зависи от текущата дума и четирите токена преди нея, замяната на една-единствена дума променя автоматично сумите и резултатите за следващите четири думи в изречението. В посока от ляво надясно единственият начин да се коригира нежелана „тура“ върху фиксирана функционална дума без синоним (като the или water) е да се промени някоя от предхождащите я думи в прозореца.
Статистическа зависимост от дължината на текста: При кратък пасаж от едва 32 независими хвърляния на монета вероятността да се паднат поне 60% „ези“ по чиста случайност е около 1 към 9, което прави късите текстове ненадеждни за категорична атрибуция. Едва при стотици последователни думи вероятността подобно отклонение да възникне случайно спада до пренебрежимо малки стойности.
Уязвимост към автоматизирано изчистване (Watermark Stripping): Ако компаниите направят своите секретни ключове публични или предоставят неограничен детектор, всеки разработчик би могъл да създаде добавка за текстов редактор, която идентифицира кои думи носят „ези“ и автоматично ги заменя със синоними, връщащи „тура“, заличавайки напълно водния знак от генерирания от ИИ текст.
Риск от фалшифициране и компрометиране на човешки текст (Spoofing): Същата симетрия работи и в обратна посока – злонамерен участник, разполагащ с ключа или с отворен оракул за проверка, може умишлено да подбере думи с висок дял на „ези“ в изцяло написан от човек текст, за да го представи фалшиво като генериран от Claude. Именно този нерешен баланс между изискванията на EU AI Act за машинночетима проследимост и криптографската защита срещу манипулация оставя проверката на текстови водни знаци привилегия само на големите ИИ лаборатории и тесен кръг одобрени от тях организации [1].
Източници
[1]: Claude Watermarks Your Words, and You Can’t Check Them (Yet) - O'Reilly Radar
[2]: A Watermark for Large Language Models - arXiv (University of Maryland)
[3]: Scalable watermarking for identifying large language model outputs - Nature (Google DeepMind)
[4]: Claude Text Watermark Announcement - Anthropic