Инженерният екип на Hostinger разкри защо компресирането на MoE модели чупи продукционни приложения въпреки високите бенчмаркове
Източник: Hostinger Engineering Blog / Архитектурен анализ на компресирането на Mixture-of-Experts модели в продукционна среда
В подробен инженерен доклад от 20 ноември 2026 година изследователският екип за изкуствен интелект на Hostinger публикува резултатите от мащабно продукционно изследване върху методите за компресия на ИИ модели с архитектура Mixture-of-Experts (MoE) при пет реални бизнес задачи [1]. Тъй като при MoE моделите всяка специализирана подмрежа („експерт“) трябва да пребивава постоянно във видеопаметта на графичните ускорители дори когато не се активира за конкретен токен, най-директният подход за намаляване на инфраструктурните разходи е отстраняването на най-рядко използваните експерти. Експериментите на Hostinger обаче показват, че макар двата водещи метода — директно подрязване (pruning) и математическо сливане (merging) — да демонстрират почти идентични резултати върху стандартните академични бенчмаркове, в реална продукционна среда сливането на експерти предизвиква катастрофални сривове в потребителските приложения [1].
Анатомия на трите продукционни срива: Счупени мобилни шаблони, безкрайни цикли и езиково смесване
Екипът на Hostinger е тествал два архитектурно различни отворени модела — стандартния трансформър Qwen3-30B на Alibaba и хибридния Transformer-Mamba модел NVIDIA Nemotron (варианта Nemotron-3.5-Lightning) — върху пет продуктови потока: три кратки класификационни задачи (разпознаване на стилови насоки в уебсайтове, извличане на имена на брандове и категоризация на продукти) и две тежки генеративни задачи (описания на домейни и пълни HTML имейл шаблони) [1]. При премахване на една четвърт (25%) от експертите в Qwen3-30B методът на подрязване запазва 93.6% от оценката за качество на писане, докато методът на сливане пада до едва 62.5% поради три систематични дефекта [1]:
Разрушаване на мобилния HTML дизайн при имейл маркетинга: Инструментът за имейл маркетинг на Hostinger изисква пълен, адаптивен HTML документ с линк за отписване, опакован във валиден JSON обект. При сливане на 25% от експертите в Qwen3-30B цели 40% от генерираните имейл шаблони излизат извън границите на тесен телефонен екран (overflow), спрямо едва 10% при оригиналния модел и около 10% при подрязания модел.
Безкрайни генеративни цикли и удвоен разход на GPU токени: Част от компресираните модели засядат в безкрайно повторение на един и същ текст до достигане на твърдия лимит за дължина. В извадка от 2000 заявки за имейли базовият Qwen3-30B изпада в цикъл само 6 пъти, докато при сливане на половината експерти броят на безкрайните цикли скача на 215 (наблюдавано и при 1 от всеки 7 имейла при Nemotron-3.5-Lightning), което удвоява общия брой генерирани токени и унищожава икономическата цел на компресията.
Хибридно превключване на езици в средата на изречението: При генериране на описания на домейни на 35 потребителски езика инструкциите на английски изискват отговорът да започва с превод на фразата „This domain is...“ (напр. „Domain ini adalah...“ на индонезийски). При сливане на 25% от експертите около 40% от неанглийските отговори на Qwen3-30B запазват английското начало и продължават на целевия език („This domain adalah...“ или „This dominio es...“), спрямо едва 3% при базовия модел, докато Nemotron-3.5-Lightning директно игнорира заявения език и отговаря изцяло на английски.
Математическият сблъсък REAP срещу REAM и слепите петна на академичните бенчмаркове
За да обяснят защо подрязването печели 16 от общо 20 директни сравнения в изследването, инженерите анализират механиката на двата алгоритъма след еднопасово калибриране без дообучение върху няколко хиляди реални разговора [1]. Водещият алгоритъм за подрязване REAP директно изтрива експертите с най-нисък принос за обработката на токените, но оставя оцелелите високоактивни експерти в техния абсолютно оригинален, непроменен вид. За разлика от него алгоритъмът за сливане REAM се опитва да съхрани знанието на слабите експерти, като ги групира около сходни силни експерти и усреднява техните тегла [1]. Именно това математическо усредняване размива прецизните параметри на водещите експерти там, където се изисква безкомпромисна точност — спазване на CSS/HTML правила за мобилен екран, превод на фиксирани начални фрази и контрол за спиране при дълги отговори от около 2700 токена.
Според изследователя от Hostinger Повилас Кведарас стандартните бенчмаркове пропускат тези провали по три причини: те оценяват предимно кратки отговори на английски език, толерират частични съвпадения и измерват само агрегирани средни стойности [1]. В теста за описания на домейни при 25% компресия успеваемостта на английски език остава 98% и при двата метода, но на останалите 34 езика пада до 77% при подрязване и 55% при сливане. Още по-показателно е, че дори при подрязване на 25% от Qwen3-30B общият процент одобрени продуктови категории се променя само с около 1 пункт, но при директно сравнение на отговорите се оказва, че над 20% от продуктите са били преместени в различна категория спрямо оригиналния модел [1]. Единствената надеждна защита срещу синтактични грешки се оказва функцията за структурирани изходи (structured outputs) на инференс енджина vLLM, която принудително налага JSON схема и задържа невалидния JSON близо до нула, докато при неструктурираните имейл шаблони невалидният JSON скача от 1% на 12% при 50% сливане [1].
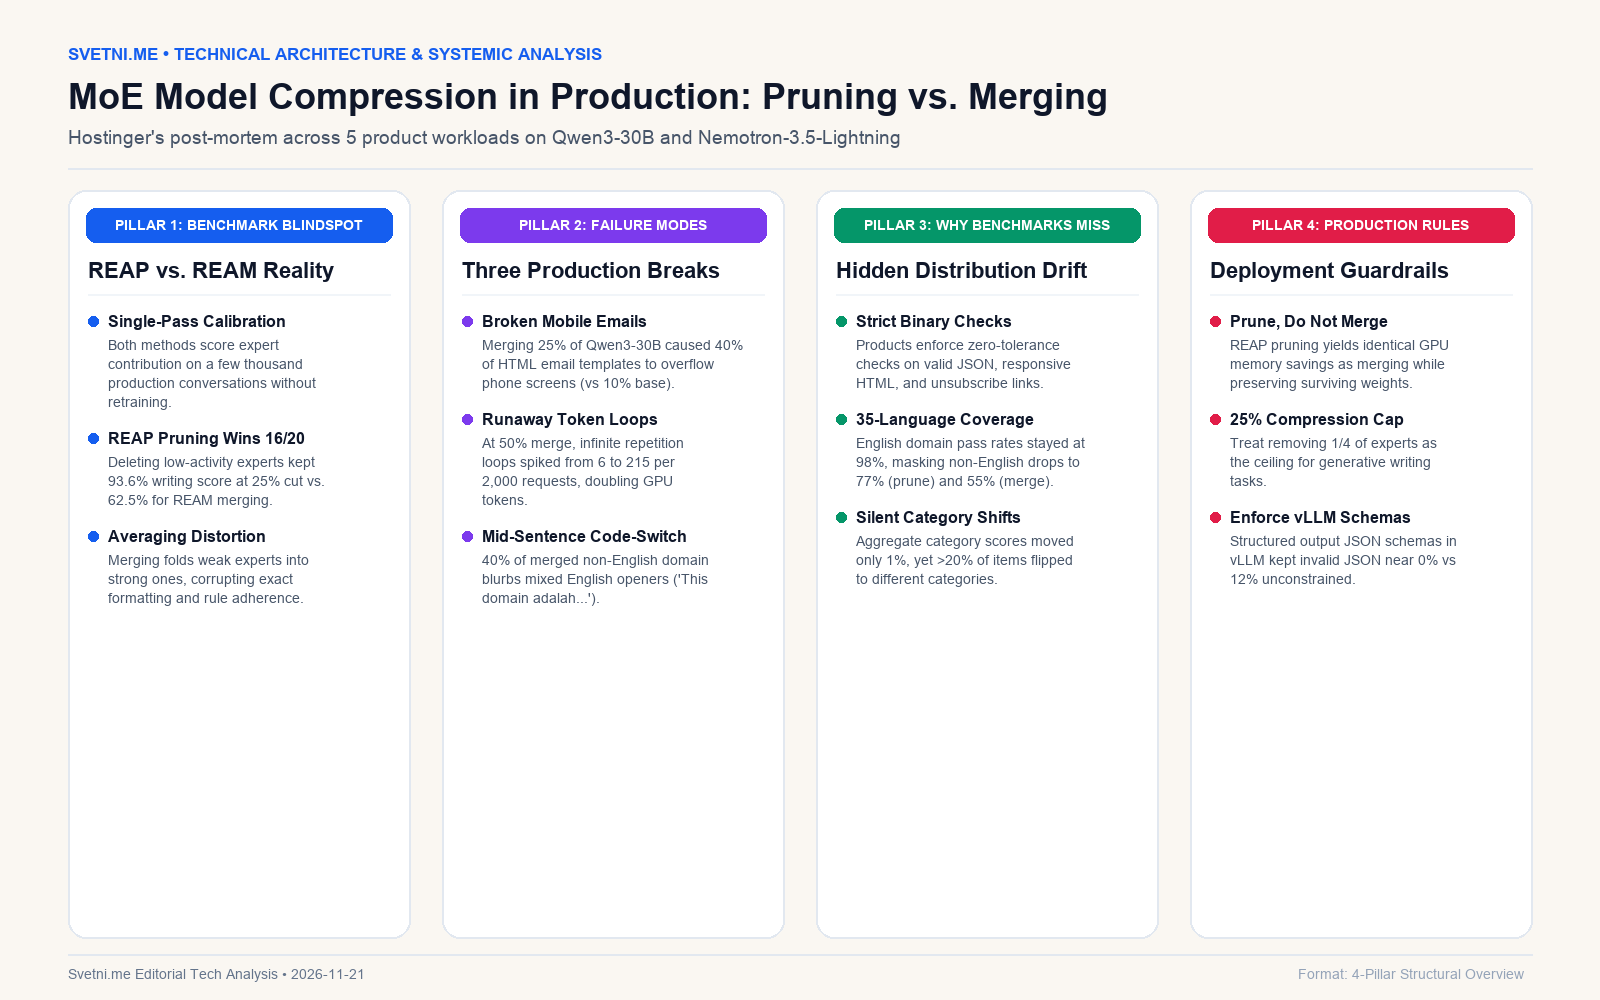
Инфографика: Ключови стълбове и анализ
Системни архитектурни и макроикономически последици: Новите инженерни правила за рентабилен MoE инференс
Публикуваният от Hostinger пост-мортем формулира четири фундаментални оперативни правила за всяка технологична компания, която внедрява компресирани Mixture-of-Experts модели в продукция: избор на чисто подрязване (REAP) пред сливане (REAM) при еднакво спестяване на GPU памет; твърд таван от максимум 25% премахнати експерти за всякакви генеративни текстови задачи; задължително активиране на схеми за структуриран изход във vLLM; и многомерно тестване върху реални многоезични и дългоконтекстни продуктови потоци вместо доверие в академични класации.
От архитектурна гледна точка откритието, че компресираният чрез сливане модел генерира два пъти повече токени заради зацикляне, разкрива критичен парадокс в икономиката на инференса. Когато инженерите се фокусират единствено върху статичния размер на модела във VRAM паметта, те рискуват да компрометират динамичното му поведение при декодиране, превръщайки спестената памет в огромни загуби на изчислително време (GPU compute) и нарушени споразумения за латентност.
В по-широк индустриален контекст изследването на Hostinger доказва, че ерата на универсалните англоезични лидербордове като единствен критерий за избор на модел е приключила. За глобалните SaaS платформи, обслужващи потребители на десетки езици със строги програмни договори за JSON и HTML валидност, истинската стойност на един компресиран модел се определя не от средния му резултат върху абстрактни тестове, а от неговата поведенческа стабилност и предвидимост в граничните случаи на реалния софтуерен продукт.