Hugging Face представя Harness Adapters: обучение с подсилване директно в агентни среди за по-висока точност и до 73% по-малко извиквания на инструменти
Източник: Hugging Face Blog / Официална архитектурна визуализация към публикацията за Harness Adapters
Големите езикови модели обикновено се оптимизират за обща производителност, поради което комбинирането им с конкретна агентна обвивка (agent harness) и специфични инженерни задачи оставя значителен неизползван потенциал по отношение на точността и разхода на ресурси [1]. В официална техническа публикация изследователският екип на Hugging Face представи Harness Adapters — напълно възпроизводима методология за обучение с подсилване (RL), при която моделът Qwen3.8-27B от фамилията Qwen се адаптира директно вътре в целевите агентни среди Pi, OpenCode и Hermes Agent [1].
Резултатите демонстрират едновременно повишаване на точността и драстично свиване на изчислителния разход: докато базовият модел Qwen3.8-27B постига 39% успеваемост на бенчмарка Terminal-Bench 2.1 с агентната среда Pi при среден разход от 2,9 хиляди токена на задача, замразяването на базовите тегла и добавянето на специализиран LoRA адаптер повишава резултата до 55% (pass@1) и намалява средната консумация наполовина — до 1,5 хиляди токена. Наред с трите специализирани адаптера екипът публикува и обединен „супер-адаптер“ с ранг 96, набора от валидирани RL задачи, контейнеризираните среди и плъгина за безопасност в публична колекция в Hugging Face Hub [2].
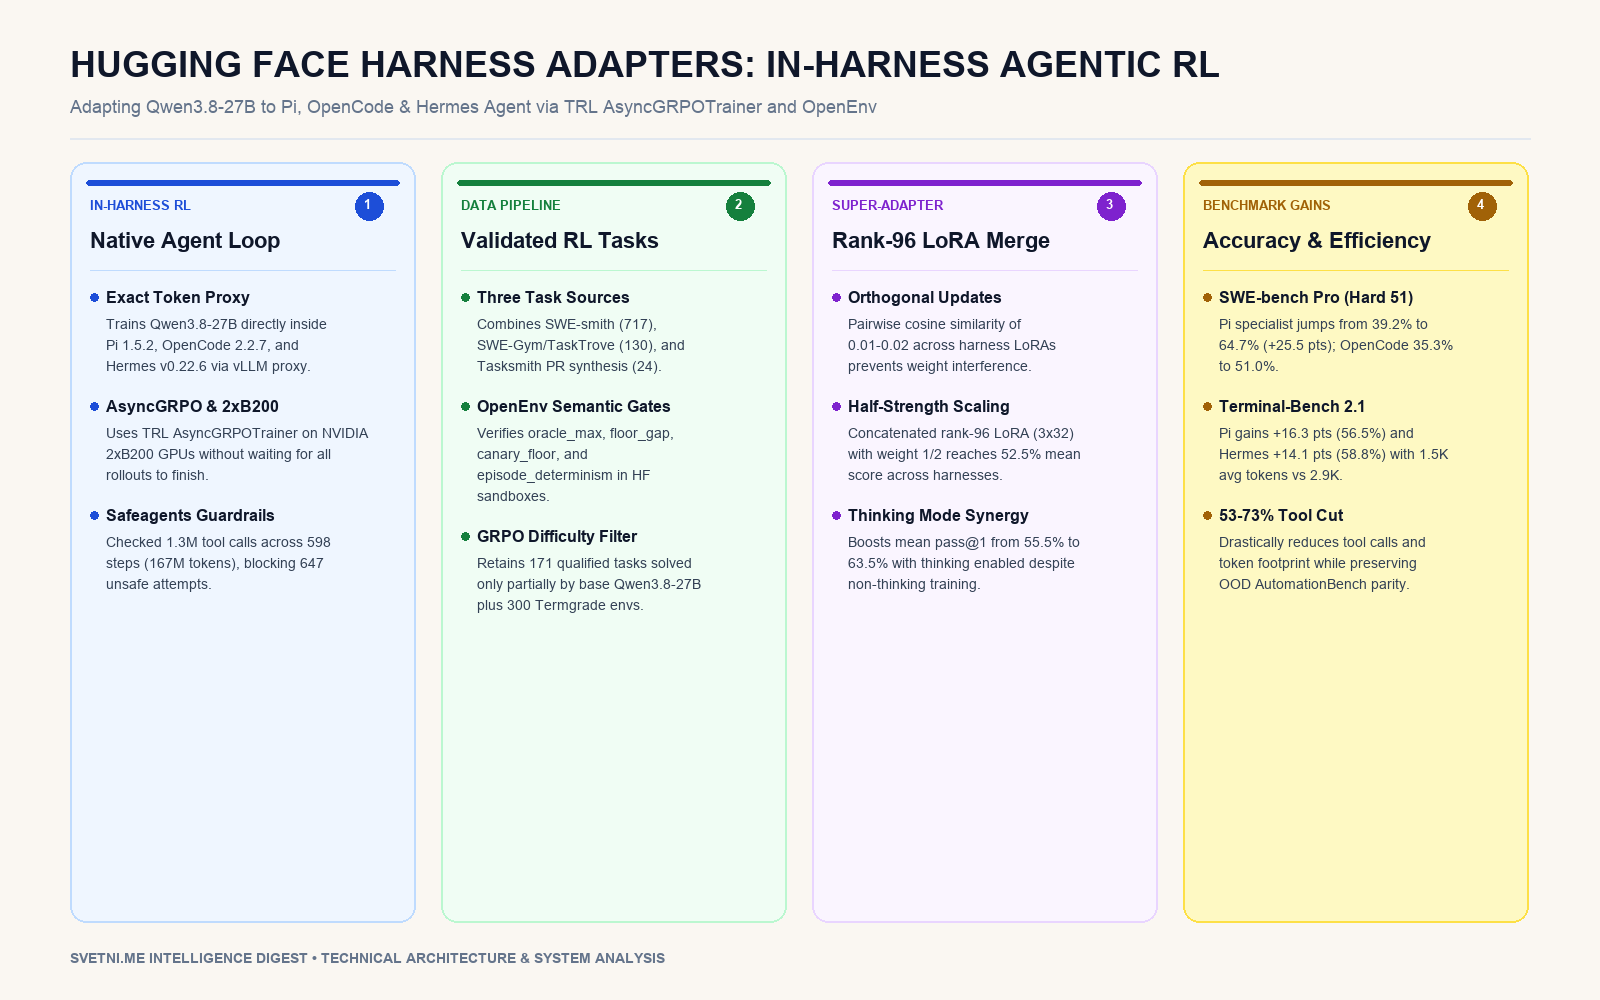
Инфографика: Ключови стълбове и анализ
Обучение директно в реалната агентна обвивка чрез vLLM прокси и AsyncGRPOTrainer
Повечето съществуващи рамки за обучение с подсилване на софтуерни агенти — като verl, SkyRL-Gym, rLLM, slime или ART — изискват пренаписване на агентния цикъл спрямо собствения програмен интерфейс на тренировъчната библиотека. За разлика от тях подходът на Hugging Face използва интеграцията на формата Harbor в OpenEnv и библиотеката TRL (Transformer Reinforcement Learning), за да стартира агентната обвивка в точния й производствен вид вътре в готови Docker изображения с предварително инсталирани версии Pi 1.5.2, OpenCode 2.2.7 и Hermes Agent v0.22.6 [1].
По време на тренировъчните траектории (rollouts) специален прокси слой между агентната обвивка и инференс сървъра vLLM записва точните токени, генерирани от модела в реалната среда. За оптимизацията се използва стабилната версия на AsyncGRPOTrainer от TRL, базирана на алгоритъма GRPO (Group Relative Policy Optimization), чието ключово предимство е асинхронното изпълнение: треньорът не изчаква всички паралелни агентни сесии да завършат напълно, преди да премине към следващата оптимизационна стъпка [1].
Всеки от трите адаптера е обучен върху инфраструктура с два графични ускорителя NVIDIA B200 (2×B200), като единият GPU обслужва vLLM сървъра, а вторият изпълнява градиентната оптимизация с максимално уплътнен параметър --token-budget. Адаптерите са прикачени към всички линейни слоеве (all-linear) при изключен режим на разсъждение (thinking off), а функцията за възнаграждение комбинира бинарната коректност от верификатора с бонус от 0,1 за ефективност при извикване на инструменти. След експерименти със скоростта на обучение (1e-5 не променя точността, а 1e-4 води до колапс на траекториите от 18 на 6 стъпки и ръст на ентропията), екипът установява оптимална стабилност при скорост на обучение 2e-5 [1].
Конвейер за синтез, семантична валидация и филтриране на RL задачи
Ефективното обучение с GRPO изисква задачи с безпогрешен верификатор и подходяща трудност: ако верификаторът приема грешни решения, моделът усвоява дефектно поведение, а ако базовият модел решава дадена задача винаги или никога, относителното сравнение между опитите в групата не генерира обучителен сигнал. За да изгради висококачествен корпус за агентно програмиране (harness-hub/agentic-coding-envs с 871 задачи от 35 хранилища, ограничени до максимум 40 задачи на хранилище), Hugging Face комбинира три източника във формата Harbor [1]:
SWE-smith (717 задачи, 144 квалифицирани): Инжектира синтетични бъгове в реални Python и Go хранилища чрез пренаписване с езиков модел или мутация на оператори, използвайки съществуващите тестове като верификатор.
SWE-Gym от пакета TaskTrove (130 задачи, 27 квалифицирани): Преобразува реални докладвани проблеми (GitHub issues) и техните слети корекции в интерактивни задачи.
Tasksmith от Repo2RLEnv (24 задачи от 30 слети pull заявки в 10 Python хранилища, 22 квалифицирани): Насочен синтез на задачи за специфични умения като HTTP стрийминг, файлови операции и сериализация, при който еталонното решение и валидна алтернатива трябва да преминат тестовете, а некоригираният код и известно грешно решение — да се провалят.
Всяка задача преминава първо през филтър за метаданни, който премахва дубликати, оценъчни множества и всички хранилища, присъстващи в целевите бенчмаркове (253 задачи). След това чрез командата openenv validate --sandbox hf-sandbox в изолирани Hugging Face Jobs се изпълняват четири семантични проверки: еталонното решение да получава максимална награда (semantic.oracle_max), липсата на действие да получава отчетливо по-нисък резултат (semantic.floor_gap), нито един „канарчен“ тест да не надвишава базовия праг (semantic.canary_floor) и повторното изпълнение да е напълно детерминистично (runtime.episode_determinism). От 1127 кандидата в Hub проверката преминават 858 задачи [1].
Следващата стъпка е филтърът за трудност с базовия модел Qwen3.8-27B (4 или 8 опита на задача): от 442 оценени задачи моделът решава 151 при всеки опит и 120 нито веднъж, оставяйки 171 „квалифицирани“ задачи, които се решават само понякога. Четири контролни тренировки по 50 стъпки върху 8×H200 GPU доказват, че обучението само върху валидирани и квалифицирани по трудност задачи е решаващо за реалния прогрес. Финалната тренировъчна смес обединява 750 задачи от harness-adapters и 300 задачи от termgrade, подредени така, че всяка стъпка да смесва максимален брой различни софтуерни хранилища. По време на общо 598 тренировъчни стъпки (78 114 примера или 167 милиона обучени токена) инструментът за сигурност safeagents е проверил 1,3 милиона извиквания на инструменти и е блокирал 647 рискови опита, чиято честота спада устойчиво в хода на обучението [1].
Ортогонално сливане в супер-адаптер и резултати върху SWE-bench Pro и Terminal-Bench 2.1
След обучението на трите специализирани адаптера изследователите анализират техните тегловни обновления слой по слой и установяват, че косинусовото сходство между всеки две матрици е едва 0,01–0,02. Това означава, че всяка агентна среда е насочила модела в почти ортогонална посока в параметричното пространство, което позволява сливането им без взаимна деструктивна интерференция [1].
Екипът конкатенира трите LoRA адаптера по размерността на ранга (combination_type="cat" в PEFT), създавайки единен супер-адаптер с ранг 96 (3 × 32), който прилага формулата w * (ΔW_pi + ΔW_hermes + ΔW_opencode) [3]. При тестване на три стойности за скалиращото тегло w върху всички 89 задачи от Terminal-Bench 2.1 се установява, че пълната сума (w = 1) скъсява прекомерно траекториите (до 13,4 извиквания на инструменти спрямо 49,2 при базовия модел) и връща Pi на базовото му ниво (40,2%), докато средното аритметично (w = ⅓, 49,2% среден резултат) разводнява ефекта. Оптималният баланс се постига при половин сила на обновленията (w = ½), която достига 52,5% средна успеваемост във всички три среди при средно 25,9 извиквания на инструменти [1].
Във финалната оценка върху пълния Terminal-Bench 2.1 (89 задачи, лимит от 1 час и 100 стъпки) и най-трудните 51 задачи от SWE-bench Pro (лимит от 2 часа, 100 стъпки и 131 072 токена) всички адаптери превъзхождат категорично базовия модел [1]:
Специализирани адаптери (при изключен режим на разсъждение): На SWE-bench Pro (hard 51) адаптерът за Pi скача от 39,2% на 64,7% (+25,5 процентни пункта), за Hermes — от 29,4% на 43,1%, а за OpenCode — от 35,3% на 51,0%. На пълния Terminal-Bench 2.1 адаптерът за Pi добавя +16,3 пункта (до 56,5%), Hermes бележи ръст от +14,1 пункта (до 58,8%), а OpenCode добавя +6,0 пункта общо и +13,6 пункта върху 66-те задържани задачи, при 53% до 72% по-малко извиквания на инструменти.
Супер-адаптер и синергия с режима на разсъждение (thinking mode): При изключено разсъждение супер-адаптерът подобрява базовия модел във всички шест комбинации от среда и бенчмарк (среден
pass@1от 39,5% на 49,0%, с 53–73% по-малко извиквания на инструменти и 44–60% по-малко генерирани токени). Най-впечатляващият резултат се наблюдава при активиране на режима на разсъждение (thinkingна нивоxhigh): макар да е обучен изцяло без разсъждение, супер-адаптерът повишава средната точност от 55,5% на 63,5%, печелейки в пет от шестте двойки (включително +16 пункта под Hermes до 60,8% и +20 пункта под OpenCode до 66,7% на SWE-bench Pro) и изравнявайки шестата (74,0% под Pi), като същевременно съкращава извикванията на инструменти с 31–48%.Трансфер между среди и извън дистрибуцията (OOD): Когато специализираният адаптер за Pi се стартира в OpenCode, той изравнява собствения адаптер на OpenCode на Terminal-Bench 2.1 (54,0% срещу 52,4%), а под Hermes запазва около две трети от подобрението (56,1% срещу 58,8%) при ~45% спад в извикванията на инструменти. При тест извън софтуерното инженерство върху 300 бизнес задачи от AutomationBench със собствен агентен цикъл адаптерите запазват базовото ниво (Pi постига 27,0%, OpenCode — 25,3%, супер-адаптерът — 23,7% спрямо 23,0% за базовия модел), което доказва, че обучението не разгражда общите способности на модела.
Архитектурни и икономически импликации: феноменът „изтичане на разсъждения“
При детайлен одит на генерираните траектории (публикувани в хранилището harness-hub/harness-adapters-trajectories) изследователите на Hugging Face откриват фундаментален поведенчески феномен, който наричат „изтичане на разсъждения“ (reasoning leakage). Докато базовият модел Qwen3.8-27B в режим без разсъждение генерира извикванията на инструменти почти директно, без предхождащ текст, обучените чрез RL адаптери се научават да извеждат кратки текстови фрагменти преди всяко извикване на инструмент (например кратки самопроверки от типа „нека проверя...“), чрез които моделът ефективно възстановява част от аналитичния капацитет на своя режим за разсъждение при минимален разход на токени [1].
В по-широк индустриален и макроикономически контекст методологията Harness Adapters променя парадигмата за внедряване на автономни софтуерни агенти в производството. Вместо организациите да разчитат на скъпи универсални модели с огромен разход на токени за дълги вериги на мислене или да пренаписват производствените си агентни обвивки за нуждите на RL библиотеки, обучението на леки LoRA адаптери директно чрез прокси пред инференс сървъра позволява свиване на оперативните разходи за инференс и латентност с над 50% до 70%. Способността на три ортогонално обучени адаптера да се сливат линейно в единен супер-адаптер, който работи и върху производни модели от екосистемата като Swift-1.5, показва, че модулната адаптация към конкретния инструментален интерфейс се превръща в самостоятелен и високорентабилен слой от жизнения цикъл на корпоративния изкуствен интелект [1].