Изследователи на Nvidia твърдят, че огромните контекстни прозорци са задънена улица, и предлагат модели с кратки бележки
Източник: The Decoder / Архитектурна илюстрация за контекстните прозорци при езиковите модели
Съвременните големи езикови модели вече могат да поглъщат цели романи и огромни софтуерни хранилища в една-единствена заявка, но изследователски екип на Nvidia доказва, че това разширяване често е излишно, бавно, скъпо и податливо на грешки, съобщава The Decoder [1]. В серия от експериментални тестове учените демонстрират, че комбинацията от периодични обобщения и целенасочено търсене по ключови думи постига същата точност като пълния контекстен прозорец, но при малка част от изчислителната цена, и предлагат нов клас архитектури, работещи с „кратки бележки“ (short notes) вместо с гигантски суров контекст [1].
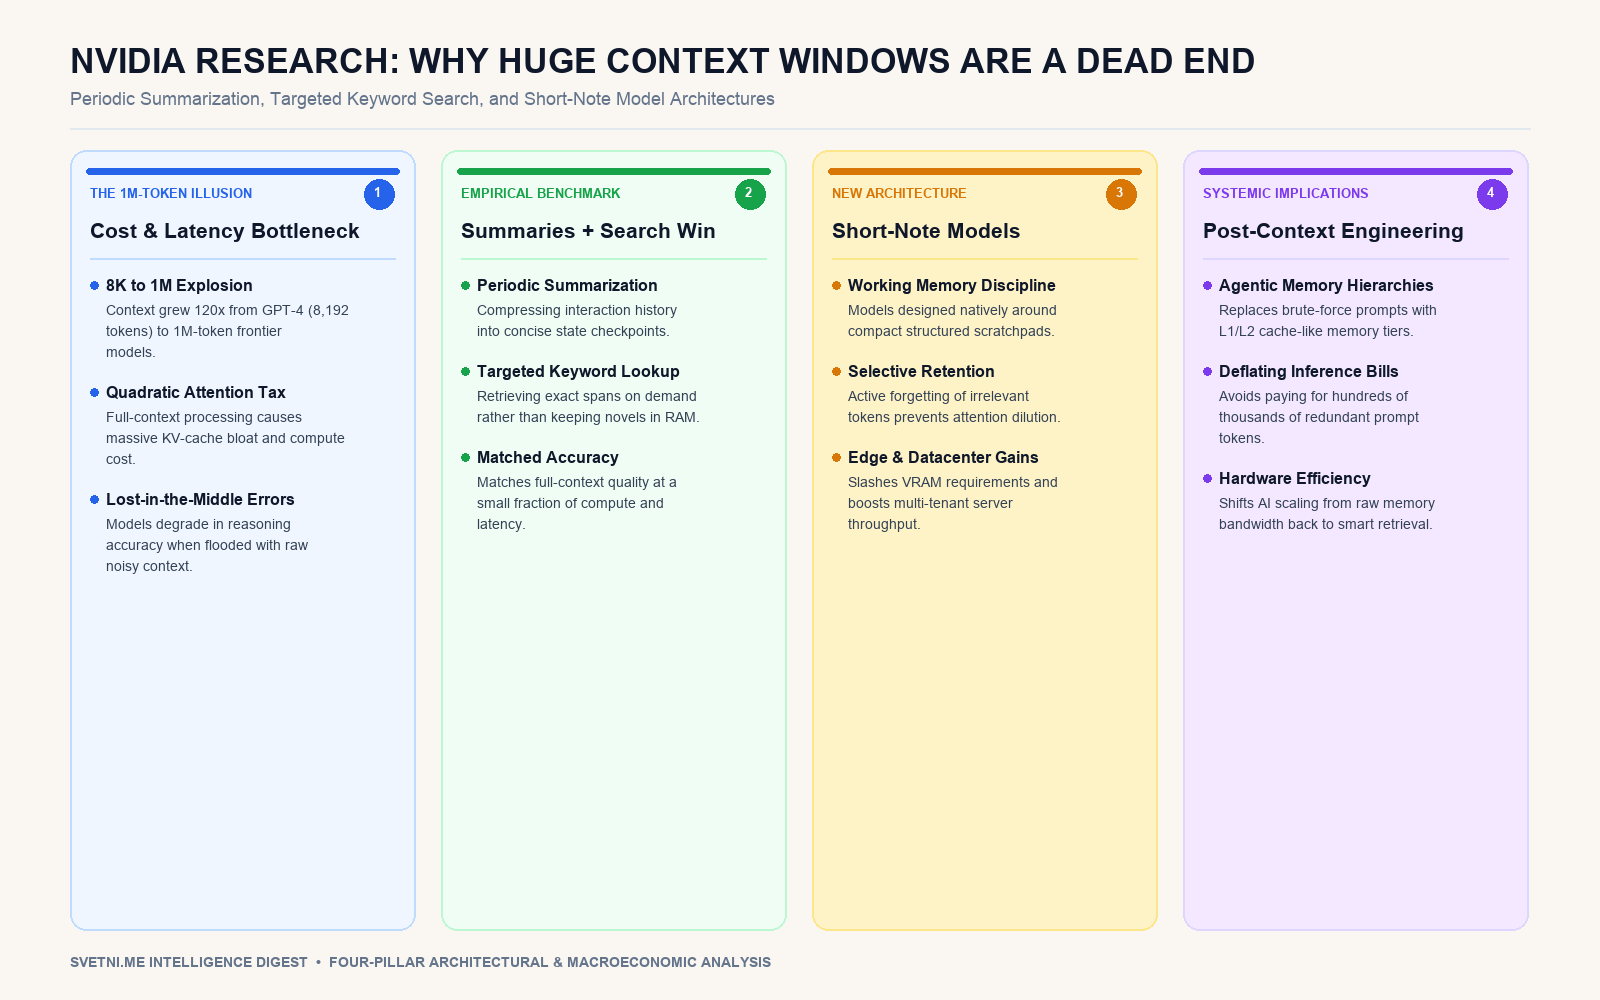
Инфографика: Ключови стълбове и анализ
От 8 192 до 1 милион токена: Илюзията за безкрайната работна памет
Контекстният прозорец представлява оперативната работна памет на езиковия модел — всичко, което невронната мрежа държи активно пред себе си в момента на генериране на отговор [1]. През последните три години този показател претърпя над стократно разширяване: докато GPT-4 стартира през март 2023 г. с базов прозорец от 8 192 токена, днешните фронтиерни системи като GPT 5.6 Sol обработват около 1 милион токена наведнъж — обем, близо 120 пъти по-голям и достатъчен да побере целия текст на епопеята „Война и мир“ на Лев Толстой [1].
Изследователите на Nvidia обаче подчертават, че механичното изсипване на стотици хиляди токени в промпта носи тежки скрити наказания. Поради квадратичната сложност на механизма за самовнимание O(n²) и експоненциалното раздуване на паметта за KV-кеша, всяка нова дума в гигантския прозорец изисква все повече изчислителни операции и видеопамет. Още по-сериозен е когнитивният дефект: когато моделът е наводнен с огромно количество нерелевантен или остарял контекст, вниманието му се разсейва, което води до повече логически грешки и пропускане на критични детайли в средата на документа.
Периодични резюмета и целенасочено търсене срещу пълния контекст
За да проверят дали моделите действително се нуждаят от достъп до всеки суров токен от историята на дадена задача, екипът на Nvidia сравнява директно работата с пълен контекстен прозорец срещу двустепенна стратегия за управление на информацията [1]. При алтернативния подход системата периодично компресира натрупаната история в кратки, структурирани резюмета и използва бързо търсене по ключови думи (targeted keyword search), за да извлича само конкретните пасажи, необходими за текущата стъпка.
Резултатите от тестовете са категорични: в преобладаващата част от практическите сценарии периодичните обобщения, комбинирани с точкови справки, се представят също толкова добре, колкото и пълният контекст от стотици хиляди токени [1]. При това хибридният метод намалява драстично латентността за генериране на първия токен (Time-To-First-Token) и свива разходите за облачен инференс в пъти.
Към нов клас модели, проектирани около кратки бележки
Въз основа на тези емпирични резултати изследователите на Nvidia предлагат фундаментална промяна в дизайна на бъдещите езикови архитектури [1]. Вместо индустрията да продължава надпреварата за 2-милионни и 10-милионни контекстни прозорци, екипът очертава концепцията за нов клас компактни модели, обучени нативно да работят с кратки бележки (short-note models).
Тези модели функционират подобно на опитен човешки изследовател, който не се опитва да наизусти цялата библиотека едновременно, а поддържа подреден работен бележник с текущите хипотези, ключовите факти и указатели към външни източници. Чрез активно освобождаване на работната памет от вече обработените междинни стъпки моделът запазва максимална острота на вниманието върху активния проблем.
Архитектурни и икономически последици: Краят на грубата сила в управлението на агентната памет
Заключението на изследователите от Nvidia е особено показателно, тъй като идва от компанията, чийто бизнес модел печели най-пряко от продажбата на висококапацитетни графични ускорители с огромна HBM памет за обслужване на гигантски KV-кеш структури. Когато дори водещите хардуерни архитекти признават, че раздуването на контекстния прозорец от нивата на GPT-4 до милиони токени е икономически и алгоритмично неефективна задънена улица, това сигнализира за предстояща смяна на парадигмата в цялата софтуерна индустрия.
За разработчиците на дългоживеещи автономни агенти и корпоративни системи с големи езикови модели това откритие променя правилата на системното инженерство. Вместо да плащат колосални суми за повторно изпращане на стотици хиляди токени лог-файлове и документация при всяка стъпка на агента, модерните платформи ще преминат към йерархична архитектура на паметта — аналогична на L1/L2 кеша, оперативната RAM памет и дисковото хранилище в класическите процесори. Съчетаването на модели за кратки бележки с прецизно индексирано търсене не само ще свали себестойността на инференса с порядъци, но и ще позволи на сложни агентни системи да работят дни и седмици без деградация на логическата точност.