OpenAI затегна защитите на GPT-6.2 Astra и Sol срещу дестилация на модели, сваляйки успешните атаки от 54% на 0.2%
Източник: The Decoder / Илюстрация на защитата срещу дестилация на модели и извличане на вътрешни разсъждения
Според технически репортаж на The Decoder [1] и официалния доклад за сигурност на OpenAI [2], компанията е внедрила радикално подсилена архитектура за защита срещу неразрешена дестилация на модели и извличане на вътрешни вериги на разсъждение в най-новите си системи GPT-6.2 Astra и GPT-6.2 Sol. Във вътрешни автоматизирани стрес-тестове успеваемостта на атаките, които се опитват да извлекат защитените логически стъпки от предходни заявки в сесията, се срива от 54.0% при предходното поколение GPT-6 Astra до едва 0.2% при GPT-6.2 Astra [1]. Паралелно с това успешните пробиви срещу активни заявки в реално време намаляват от 22.9% на 0.9%, като лабораторията вече пренася избрани защитни механизми обратно и към базовия модел GPT-6 Astra [1].
Двуслойна защитна архитектура: Изолация на ниво заявка и блокиране на кръстосано четене
Техническата защита на разсъждаващите модели оперира едновременно на микрониво (индивидуални API извиквания) и на макрониво (координирани кампании за извличане на синтетични данни) [1]. На ниво отделна заявка инженерният стек комбинира целенасочено следтренировъчно обучение за устойчивост срещу враждебни инструкции със специализирани входни и изходни класификатори, които инспектират както потребителските съобщения, така и параметрите при извикване на външни инструменти (tool calls) [2].
Критичен елемент от новата инфраструктура е въвеждането на твърди програмни бариери в API слоя, които категорично забраняват на по-стари или по-слабо защитени модели да четат криптираните блокове със защитени разсъждения, генерирани в рамките на същата разговорна нишка [1]. По този начин се затваря един от най-експлоатираните вектори при адаптивното black-box red-teaming тестване, при който атакуващите превключваха модела в средата на сесията, за да накарат по-уязвим вариант да декодира и обобщи скрития мисловен процес на флагманския модел [2].
Адаптивен Red-Teaming и масови санкции срещу координирани мрежи за дестилация
За да измери реалната устойчивост на GPT-6.2 Astra срещу автоматизиран индустриален шпионаж, екипът по сигурността на OpenAI е провел агресивни симулации, агрегирани върху шест независими атакуващи модела в режим на адаптивно black-box тестване [1]. В тази конфигурация атакуващите агенти динамично пренаписват своите промптове след всеки отказ, опитвайки се да заобиколят семантичните филтри и да реконструират междинните токени на разсъждение (Chain-of-Thought) [2]. Спадът на показателя Attack Success Rate (ASR) до под един процент доказва, че моделът успява да отдели вътрешното си планиране от финалния публичен отговор дори при многостъпкови провокации.
Срещу мащабните автоматизирани кампании за кражба на интелектуална собственост OpenAI прилага поведенческа телеметрия, която идентифицира разпределени ферми от акаунти, генериращи синтетични тренировъчни корпуси за обучение на конкурентни модели „ученици“ [2]. В резултат на тези проверки компанията деактивира между няколко хиляди и десетки хиляди злоупотребяващи акаунти всяка седмица [1]. Аналогични мерки предприема и основният конкурент Anthropic, който също блокира десетки хиляди акаунти в борбата срещу систематичните атаки за дестилация, отчитайки между 90% и 99% успеваемост при пресичането на опитите за извличане на вътрешни разсъждения и призовавайки за координиран отговор от индустрията и регулаторите [1].
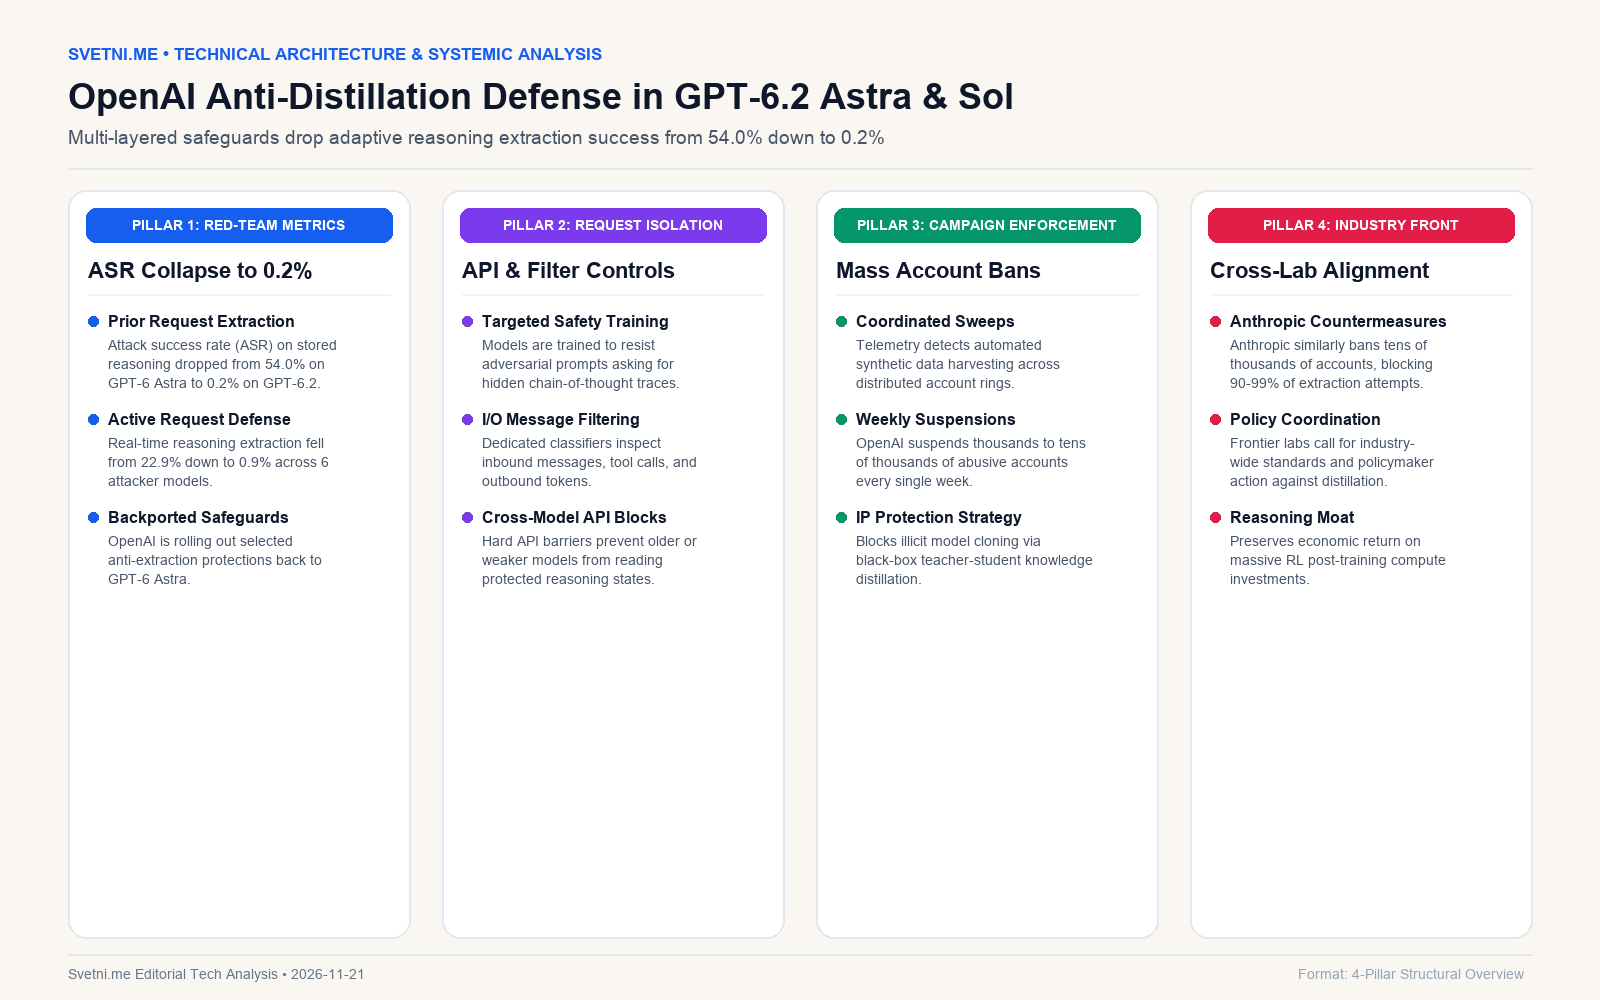
Инфографика: Ключови стълбове и анализ
Системни архитектурни и макроикономически последици: Защитата на веригите на разсъждение като нов индустриален ров
Превръщането на вътрешните вериги на разсъждение в строго охранявана търговска тайна бележи фундаментална структурна промяна в икономиката на изкуствения интелект през 2026 година. Докато при класическите авторегресивни модели основният капитал беше концентриран в суровия предтренировъчен корпус, при съвременните разсъждаващи архитектури като GPT-6.2 Astra и Sol конкурентното предимство се крие в скъпоструващите процеси на обучение с подсилване (Reinforcement Learning) и траекториите за верификация на решенията. Ако външен атакуващ може свободно да извлече милиони такива мисловни траектории чрез евтини API заявки, той е в състояние да обучи конкурентен модел чрез директна дестилация за нищожна част от милиардните капиталови разходи на първоначалния създател.
От архитектурна гледна точка въвеждането на строга криптографска и логическа изолация между вътрешното състояние на разсъждение и видимия изход променя начина, по който корпоративните разработчици проектират агентни системи. Налагането на API блокове срещу четене на мисловната история от по-стари модели означава, че мултиагентните оркестратори вече не могат да третират междинните разсъждения като обикновен споделен текст между разнородни модели, а трябва да разчитат на стандартизирани, капсулирани обекти на състоянието.
В макроикономически план синхронизираните действия на OpenAI и Anthropic за ежеседмично заличаване на десетки хиляди акаунти очертават нова геополитическа и корпоративна разделителна линия. Тъй като водещите американски лаборатории затварят прозореца за лесна black-box дестилация, лабораториите от втория ешелон и проектите с отворени тегла ще бъдат принудени да инвестират в собствени изчислителни клъстери за генериране на синтетични данни и верификация от първи принципи, вместо да паразитират върху API интерфейсите на фронтиерните доставчици.