Многообразия на вниманието: Контрол на езикови модели чрез B-spline геометрични повърхности
Снимка: Geometric Deep Learning Lab / Machine Brief
В основополагащо изследване на пресечната точка между диференциалната геометрия и изкуствения интелект, учени от Geometric Deep Learning Lab представиха концепцията за многообразия на вниманието (Attention Manifolds) [1]. Разработката предлага революционен математически метод за насочване на активациите (Activation Steering) на езикови модели чрез проектирането им върху гладки непрекъснати B-spline повърхности, елиминирайки напълно нуждата от скъпо и рисковано преобучение.
Откритието хвърля ярка светлина върху вътрешната архитектура на дълбоките мрежи, правейки решаваща крачка в полето на механистичната интерпретируемост.
Геометричната природа на знанието: Защо RLHF е тромав чук
Традиционните методи за подравняване на модели (Model Alignment) – като подкрепящото обучение с човешка обратна връзка (RLHF) – приличат на опит да се настрои фин швейцарски часовник с помощта на ковашки чук. При промяна на милиарди тегла, за да се премахне токсично поведение, моделът често забравя основни математически умения (т.нар. катастрофално забравяне):
- Латентни многообразия в многомерното пространство: Учените доказаха, че скритите състояния на трансформатора не са хаотични вектори, а лежат върху гладки риманови многообразия с ниска присъща размерност.
- Параметризация чрез B-сплайни: Чрез използването на класически B-spline криви от компютърната графика, всяко понятие (напр. „сарказъм“, „биологична безопасност“ или „формален стил“) може да бъде описано като геометричен контур с конкретни контролни точки.
- Хирургически контрол без тренировка: За да накарат модела да говори по-предпазливо или да блокира дадена тема, инженерите просто деформират локално B-spline повърхността по време на инференция, оставяйки всички останали знакови структури непокътнати.
„Ние заменихме непредсказуемия оптимизационен процес с чиста геометрия. Сега можем да видим точно къде се намира дадена концепция в пространството на модела и да я наклоним в желаната посока с абсолютна математическа прецизност,“ обяснява водещият изследовател [1].
Предимствата на геометричното дълбоко обучение
Новият метод предлага качествени предимства за сигурността и одита:
- Нулево забавяне по време на изпълнение: Проекцията върху B-spline координати изисква минимални матрични трансформации, добавяйки под 2% закъснение при генериране на токени.
- Гарантирани граници на безопасност: Моделът може да бъде геометрично „заключен“ в безопасната област на многообразието, правейки атаките чрез инжектиране на промптове (jailbreaks) математически невъзможни.
- Визуална обяснимост за одитори: За първи път регулаторите могат да наблюдават траекторията на разсъжденията като плавна крива в триизмерно пространство, разбирайки точно кога и защо моделът променя мнението си.
Дълбок фундаментален анализ
Успехът на геометричните многообразия на вниманието бележи края на ерата на „черната кутия“ в изкуствения интелект. В продължение на десетилетие индустрията се примиряваше с факта, че невронните мрежи работят благодарение на непроницаема статистическа магия.
Внедряването на строги диференциално-геометрични методи доказва, че дълбоките модели всъщност изграждат вътрешни структурирани карти на човешкия език и познание. Разбирането на тази геометрия превръща настройката на изкуствения интелект от мистично изкуство в точна, детерминистична и предвидима инженерна наука.
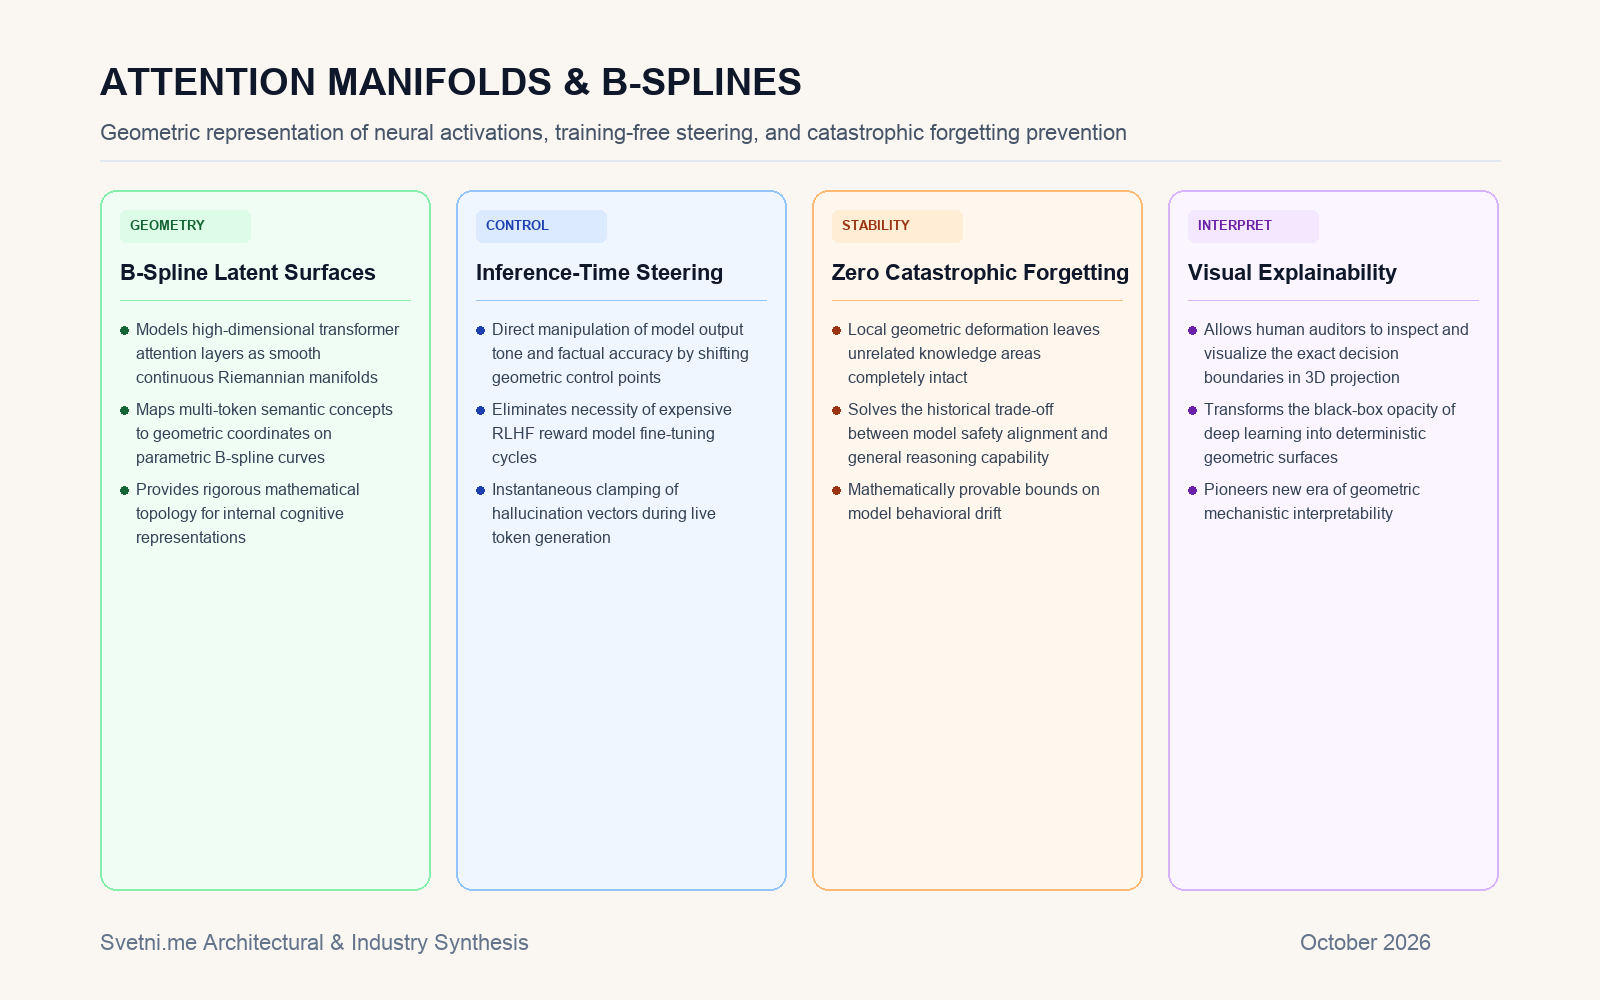
Инфографика: Геометрично представяне на активациите, B-spline контролни точки и механизъм на бестренировъчно насочване