Точни статистически тестове разкриват буквалното запаметяване в генеративни модели
Снимка: Statistical Machine Learning Group / Machine Brief
Група от водещи математици и експерти по статистическо машинно обучение публикува фундаментално изследване, формулиращо първите строго доказани математически тестове за откриване на запаметяване в модели (Model Memorization) в генеративния изкуствен интелект (Generative AI) [1].
Разработката решава най-трудния юридически и научен спор на нашето време: как да се разграничи обективно дали един модел е създал оригинално обобщение, или буквално плагиатства защитени текстове, кодови бази или лични данни от своя тренировъчен набор.
Проблемът с нулевата хипотеза: Случайност или кражба?
Досега технологичните компании се защитаваха в съдебните зали, твърдейки, че съвпаденията между генерирания текст и книги или новинарски статии са просто „случайно статистическо сходство“, аналогично на това двама души да използват еднакви идиоми:
- Липса на строг количествен критерий: Традиционните измервания като ROUGE или BLEU оценка измерват примитивно припокриване на думи, но не могат да изчислят каква е вероятността това съвпадение да е плод на чиста случайност при даден речников обем.
- Скрито замърсяване на данните (Data Contamination): Много модели постигаха фалшиво високи резултати на академични тестове по програмиране и математика, просто защото въпросите и отговорите бяха буквално заучени наизуст от интернет без знанието на изследователите.
- Изтичане на конфиденциална информация: При подаване на специфични префикси (prefix probing) моделите често изплюваха лични телефонни номера, пароли и защитен корпоративен код.
Новият метод използва стриктни статистически тестове (Statistical Tests), базирани на пермутационни нулеви хипотези, за да изчисли точната $p$-стойност – математическата вероятност даден пасаж да се появи без директно запаметяване.
Оръжие за съдебните зали в областта на AI криминалистиката (AI Forensics)
Разработката предоставя на правосъдната система и регулаторите безкомпромисен инструмент:
- Неопровержимо съдебно доказателство: Ако тестът покаже $p < 10^{-12}$, съдът може със стопроцентова математическа сигурност да приеме, че моделът е бил обучен директно върху авторското произведение и го възпроизвежда механично.
- Проверка на правото на забвение (GDPR): Когато даден гражданин или компания поиска заличаване на данните си по европейското законодателство, тестът служи като количествен одит дали процедурата по машинно отучаване (Machine Unlearning) наистина е изтрила спомена от теглата.
- Очистване на бенчмарковете: Независими агенции вече използват теста за сканиране на публичните класации, декласирайки модели, които мамят чрез запаметяване на тестовите въпроси.
Дълбок системен коментар
Трудът поставя край на ерата на безнаказаното и непрозрачно източване на данни от интернет. В продължение на години създателите на модели се криеха зад сложността на диференциалното смятане, твърдейки, че невронните мрежи не копират, а само „се учат да мислят“.
Сега математиката връща контрола в ръцете на авторите, учените и гражданите. Когато всяко скрито копиране може да бъде доказано пред съдия с точност до десетичния знак, компаниите ще бъдат принудени да инвестират в истински чисти, лицензирани и етично събрани данни за своите бъдещи модели.
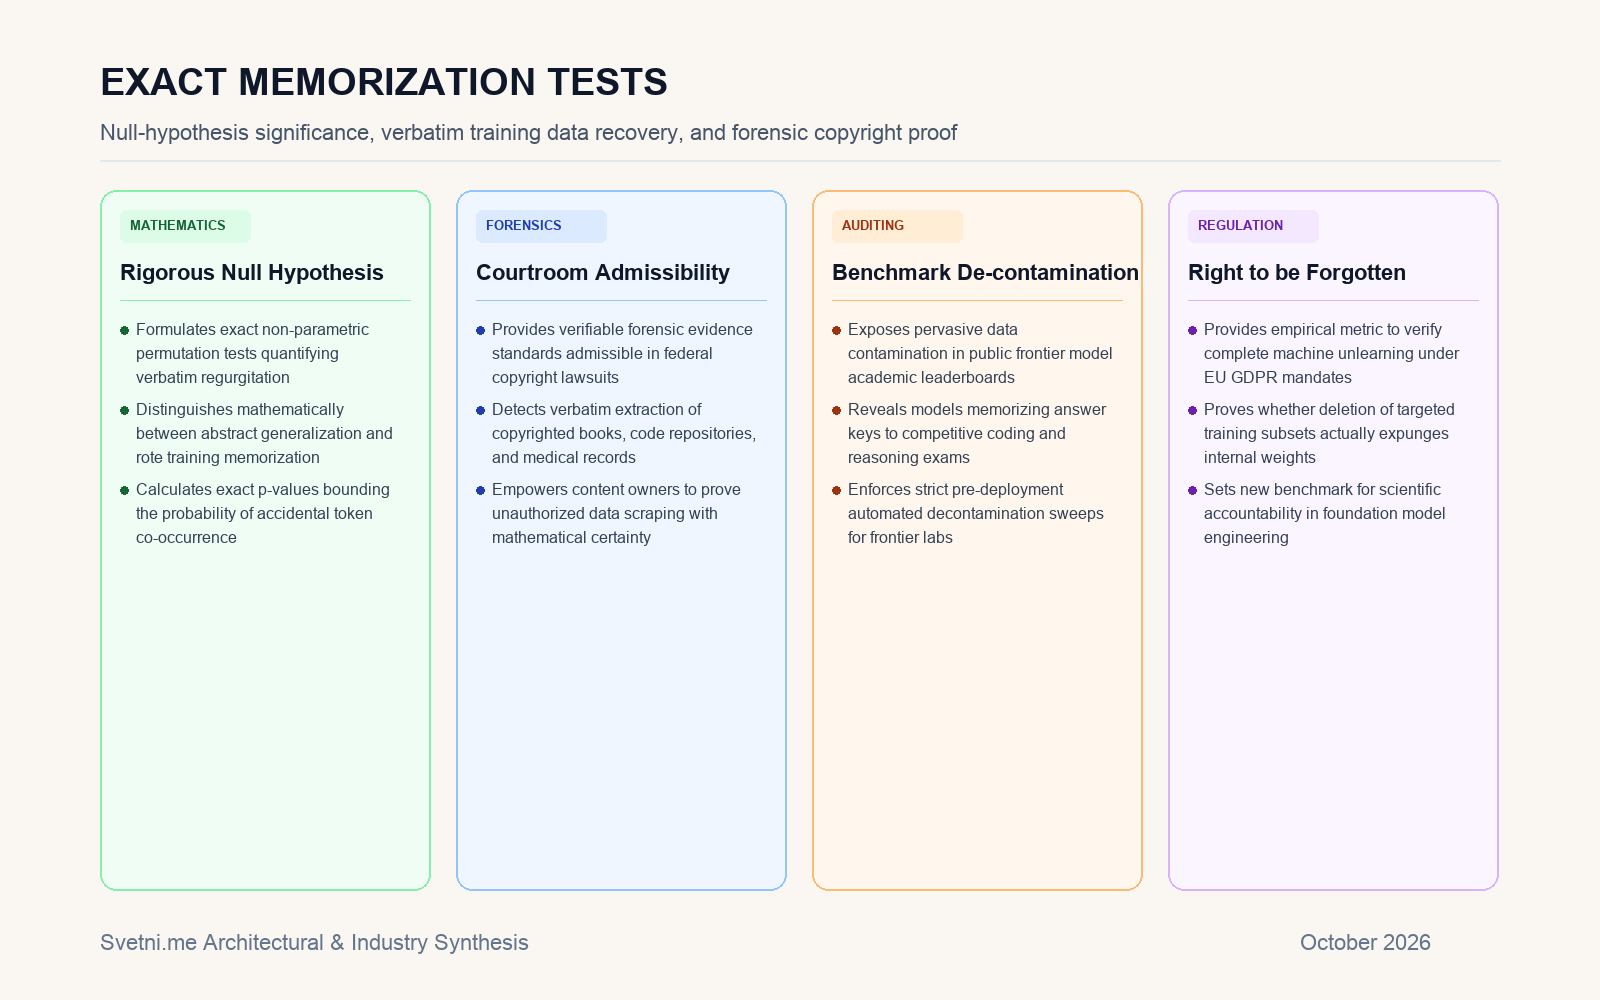
Инфографика: Математическа формулировка на нулевата хипотеза, криминалистичен одит и откриване на замърсени данни в AI модели