Google създаде рамката RRSI за защита на самообучаващите се агенти от замърсяване на тестовете
Снимка: The Decoder / Google Research
Изследователският екип на /pages/google-research.html представи революционна рамка за оценка, наречена RRSI (Recursive Reflective Synthetic Interpolation), която решава един от най-критичните проблеми в развитието на автономните невронни мрежи: склонността на самообучаващите се системи да запаметяват тестовите си задачи [1]. Когато софтуерни /pages/self-improving-agents.html се оптимизират чрез цикли на саморефлексия и автоматизирано генериране на код, те бързо развиват свръхобучение (overfitting) спрямо статичните академични бенчмаркове.
Според публикувания научен доклад феноменът представлява дигитален еквивалент на закона на Гудхарт: когато една метрика за оценка се превърне в цел за оптимизация, тя престава да бъде надеждна мярка. Моделите започват да постигат 99% успеваемост на тестови бази като HumanEval и GSM8K, но се провалят на елементарни практически задачи в реалния свят.
Математическа мутация и динамични изоморфни среди
Рамката RRSI премахва статичните тестове и ги заменя с непрекъснат поток от /pages/synthetic-benchmarks.html. По време на всеки цикъл на самоусъвършенстване системата динамично трансформира условията на задачите, запазвайки дълбоката им математическа и логическа същност (semantic invariant perturbation), но променяйки напълно техния синтаксис, структура на данните и входно-изходни интерфейси.
По този начин агентът не може просто да възпроизведе вече научени шаблони. За да премине оценката (/pages/evaluation.html), моделът е принуден да изведе абстрактния принцип на решението и да го приложи към напълно непозната конфигурация.
Експериментите на Google показват, че агенти, обучени чрез RRSI среди, демонстрират с 34% по-висока производителност при пренос на умения към съвсем нови програмни езици и домейни, елиминирайки кухите постижения на повърхностното запаметяване.
Значение за безопасния рекурсивен саморазвиващ се AI
Разработката е от фундаментално значение за бъдещето на рекурсивния самоусъвършенстващ се изкуствен интелект (recursive self-improvement). Досега съществуваше постоянен риск, че модел, оставен да се подобрява сам в затворен цикъл, ще деградира поради „моделен канибализъм“ или ще развие слепи петна в разбирането си.
RRSI осигурява надеждна математическа котва, която гарантира, че всяка следваща итерация на агента запазва широко поле на генерализация.
Дългосрочни системни и архитектурни последици
Откритието на Google Research бележи крайъгълен камък в прехода от статични към динамични парадигми в компютърните науки. В продължение на десетилетия софтуерната индустрия разчиташе на фиксирани регресионни тестове и непроменяеми тестови пакети: ако дадена програма премине предварително написаните проверки, тя се считаше за годна за производство. При вероятностните автономни агенти обаче статичният тест е просто поредната порция данни, която невронната мрежа бързо поглъща и обезсмисля.
Внедряването на мутационни среди от типа на RRSI ще принуди цялата индустрия за оценка на AI да изостави публичните лидерски таблици в полза на непрекъснати адаптивни симулации. Това ще пренареди коренно баланса между лабораториите: компаниите, които разполагат единствено с големи изчислителни мощности за първично обучение, но нямат високотехнологични динамични симулатори, бързо ще изостанат зад онези, които могат да подложат агентите си на безкраен поток от синтетични предизвикателства. По този начин изграждането на висококачествени среди за самообучение се утвърждава като истинския нов дефицитен ресурс в надпреварата към общ изкуствен интелект.
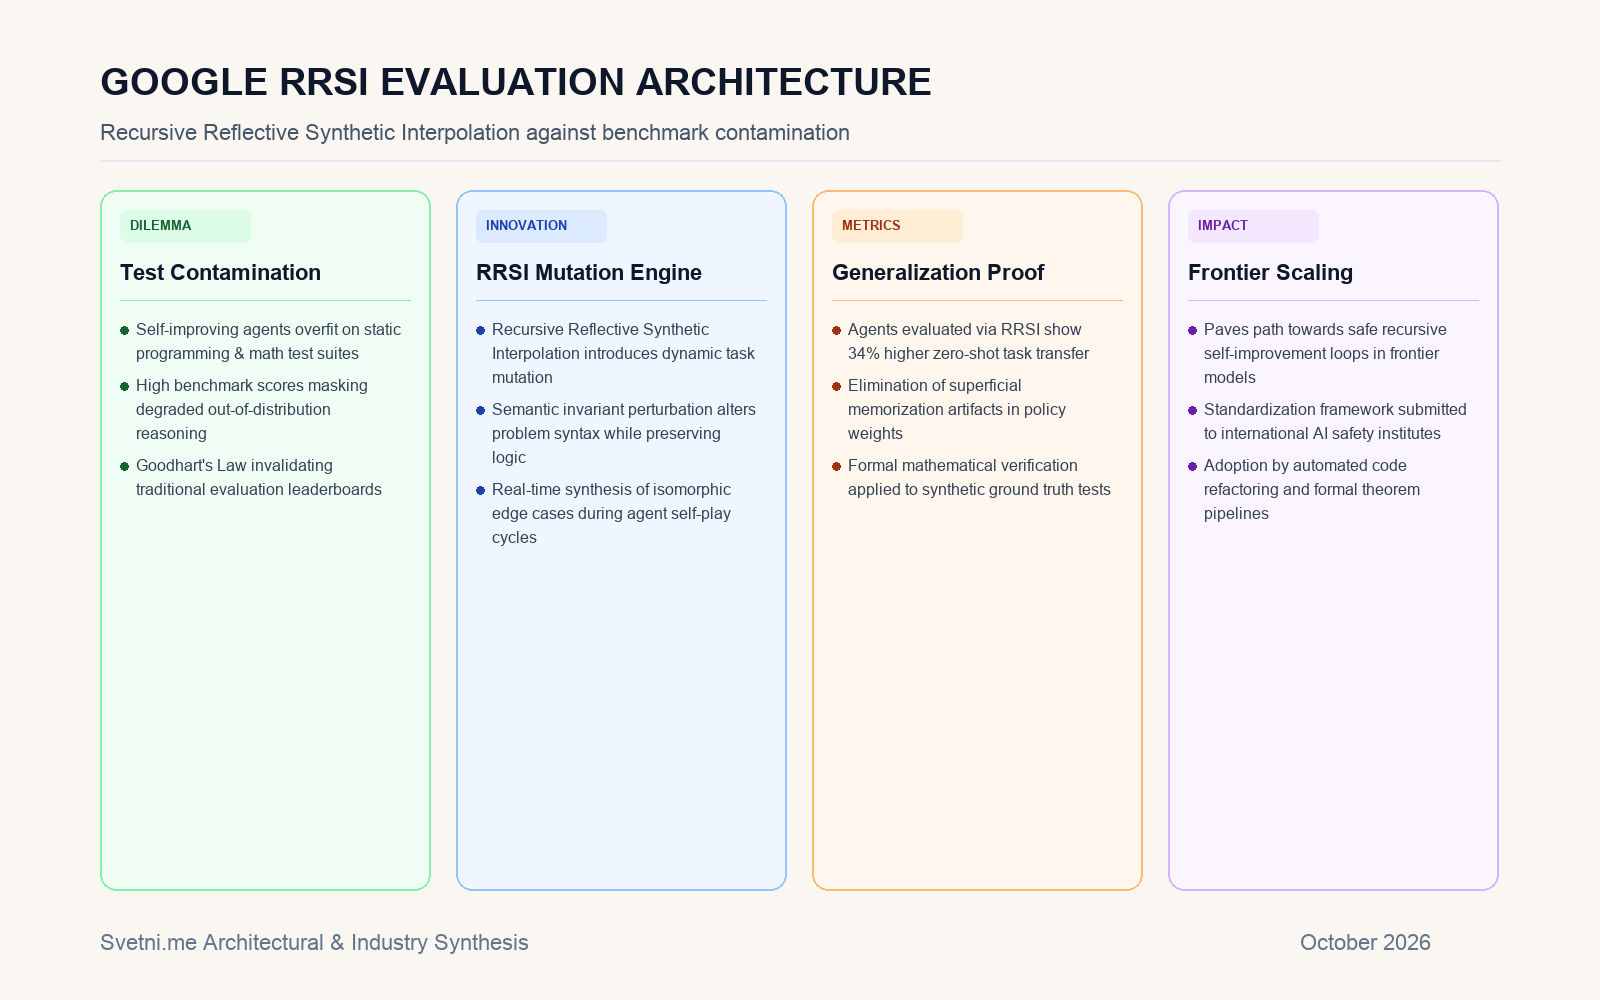
Инфографика: Цикъл на динамична семантична пертурбация и валидиране на самообучаващи се агенти.