Suno представи Speech: единен дифузионен модел за естествена реч и динамичен музикален съпровод
Снимка: The Decoder / Suno
Лидерът в генеративния музикален синтез /pages/suno.html направи важна технологична крачка отвъд традиционните песни, представяйки новата си архитектурна функционалност, наречена Speech [1]. Разработката обединява в единен генеративен процес синтеза на естествена човешка реч (/pages/voice-ai.html) и създаването на динамично синхронизиран инструментален съпровод в рамките на цялостната генерация на звук (/pages/audio-generation.html).
Досега създаването на озвучено съдържание (като аудиокниги, подкасти или кинематографични трейлъри) изискваше сложен многоканален монтаж: първо се генерира дикторският глас през един софтуер, след което звуков инженер подбира фонова музика и ръчно настройва нивата на звука (ducking), за да не заглуши музиката гласа на актьора.
Единно латентно пространство и емоционална синхронизация
Иновацията на Suno стъпва върху усъвършенствани /pages/diffusion-models.html, които третират речта и музиката не като отделни аудио файлове, а като преплетени траектории в едно общо непрекъснато латентно пространство.
По време на единния изчислителен цикъл моделът анализира емоционалния заряд на текста:
- Когато дикторът повишава тон или говори с напрежение, оркестровият съпровод автоматично добавя динамични перкусии и повишава кресчендото.
- При интимни, шепнещи пасажи или драматични паузи, музиката плавно се оттегля във фонов амбиентен пласт, съобразявайки се с темпото на човешкото дишане.
Системата извежда пространствен бинаурален звук с висока резолюция при 48 kHz, създавайки усещане за автентична студийна продукция в областта на иновативния /pages/music-ai.html.
Индустриални приложения и нови творчески формати
Възможностите на Suno Speech откриват огромен пазар за интерактивни развлекателни формати. Разработчиците на видеоигри вече експериментират с динамични неигрови персонажи (NPC), които могат да разказват уникални истории на играча, акомпанирани от адаптивен саундтрак, променящ се спрямо решенията на сцената.
Издателите на аудиокниги също виждат потенциал за драстично съкращаване на производствените разходи, позволявайки хиляди класически и нови литературни произведения да получат високобюджетно звуково оформление за частица от досегашната цена.
Дългосрочни системни и макроикономически последици
Пробивът на Suno със Speech демонстрира края на ерата на тясно специализираните едноцелеви невронни мрежи. Бъдещето на генеративните медии принадлежи на единните модални пространства, в които понятията за „глас“, „музика“, „шумов ефект“ и „емоция“ са просто различни координати на една хармонична математическа функция.
Тази дълбока интеграция обаче ще нанесе нов съкрушителен удар върху традиционната индустрия на звуковия дизайн и дублажа. Хиляди студийни звукорежисьори, композитори на фонова музика и актьори ще се окажат изправени пред конкуренцията на алгоритъм, който създава кинематографично озвучаване за секунди по текстов сценарий. Това неизбежно ще засили натиска от страна на творческите синдикати за въвеждане на задължителни квоти за човешко участие и криптографски стандарти за защита на оригиналните гласови тембри в развлекателната индустрия.
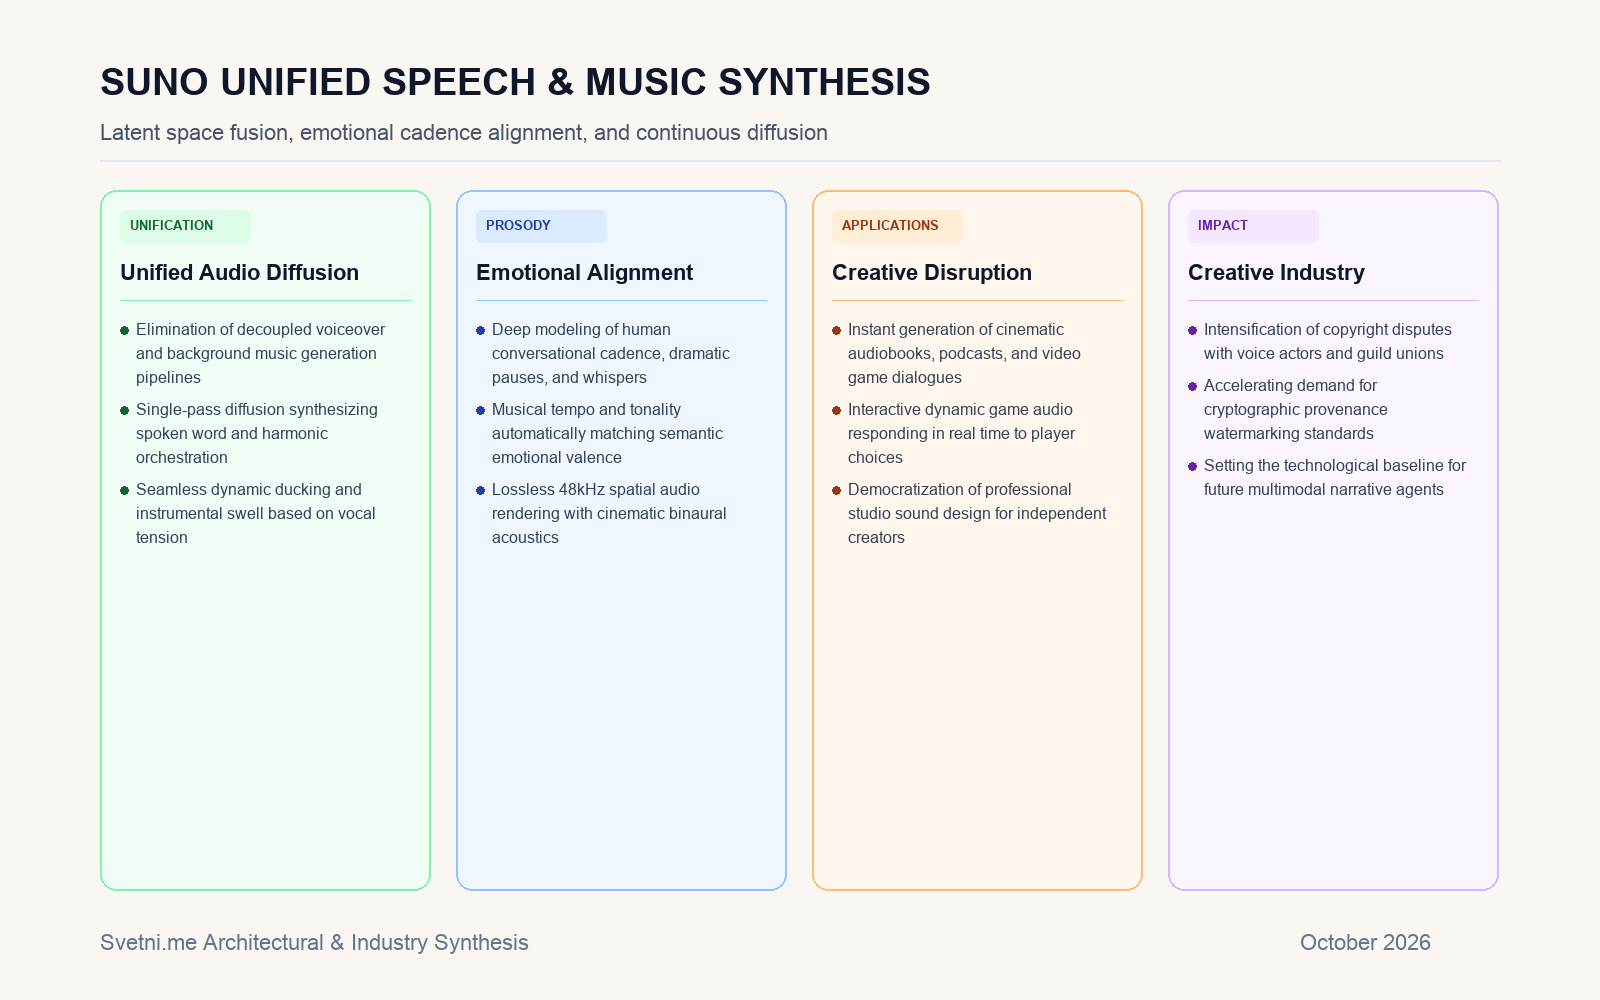
Инфографика: Архитектура на общото латентно пространство за синхронизация на реч и динамичен аранжимент.