OpenAI допусна грешка при превода на математика в код при опита за доказателство на Навие-Стокс
Снимка: New Scientist / SEI
Опитът на изследователи от OpenAI да обявят пробив в решаването на вековния проблем за гладкостта на уравненията на Навие-Стокс претърпя сериозен крах, след като независим анализ разкри фатална грешка в машинния превод на математическите концепции в софтуерен код [1].
Според публикация в списание New Scientist, моделът е допуснал концептуална грешка при трансформирането на непрекъснати диференциални уравнения в изпълними алгоритмични структури, нарушавайки фундаментални физически гранични условия [1].
Пропастта между непрекъснатото смятане и дискретния код
Уравненията на Навие-Стокс, формулирани през XIX век, описват движението на вискозни флуиди и са един от седемте Проблема на хилядолетието с награда от един милион долара от математическия институт „Клей“. Въпросът дали решенията остават винаги гладки и лишени от безкрайни скорости (сингулярности) в триизмерното пространство е сред най-трудните в математическия анализ.
В своя ръкопис OpenAI претендираше за конструктивно доказателство, получено чрез сложен изчислителен пайплайн. Детайлният преглед на дискретната математика обаче показа, че моделът е използвал схема за крайни разлики, която е математически нестабилна.
Вместо да докаже свойства на непрекъснатото диференциално поле, моделът на практика е анализирал изкуствен дискретен модел, в който енергията на флуида не се запазва на границите на изчислителната решетка.
Капанът на числените методи и плаващата запетая
Случаят илюстрира класическа опасност в областта на числените методи и научните изчисления (scientific computing). Когато сложни математически концепции се превеждат в програмен код, стандартните типове с плаваща запетая (float64) внасят микроскопични грешки при закръгляване.
За езиковия модел генерираният код е изглеждал съвършено елегантен: синтактично верен, компилиращ се без грешки и преминаващ стандартните тестове за конвергенция. В действителност обаче „гладкостта“ на решението е била просто артефакт от изкуствено числено разсейване (numerical dissipation), породено от грешната дискретизация.
Архитектурен и методологичен анализ: Уроци за AI в точните науки
Провалът на опита с Навие-Стокс маркира важни граници пред използването на невронни мрежи в теоретичната наука. Големите езикови модели са великолепни статистически генератори на правдоподобен научен текст, но страдат от фундаментална слепота към скритите физически инварианти.
Когато един модел генерира код за симулация, той не „разбира“ законите за запазване на масата и импулса — той просто предсказва кодови токени, които статистически съпътстват научните трудове.
За да бъдат машинните доказателства надеждни в бъдеще, научната общност ще трябва да изолира LLM от директно писане на непроверени числени скриптове. Единственият сигурен път е интеграцията с формални системи за верификация, където всяко гранично условие се дефинира като строга теорема с аксиоматична проверка.
Инцидентът показва, че в теоретичната физика и висшата математика няма преки пътища: бързината на невронните мрежи не може да замени желязната строгост на аналитичното доказателство.
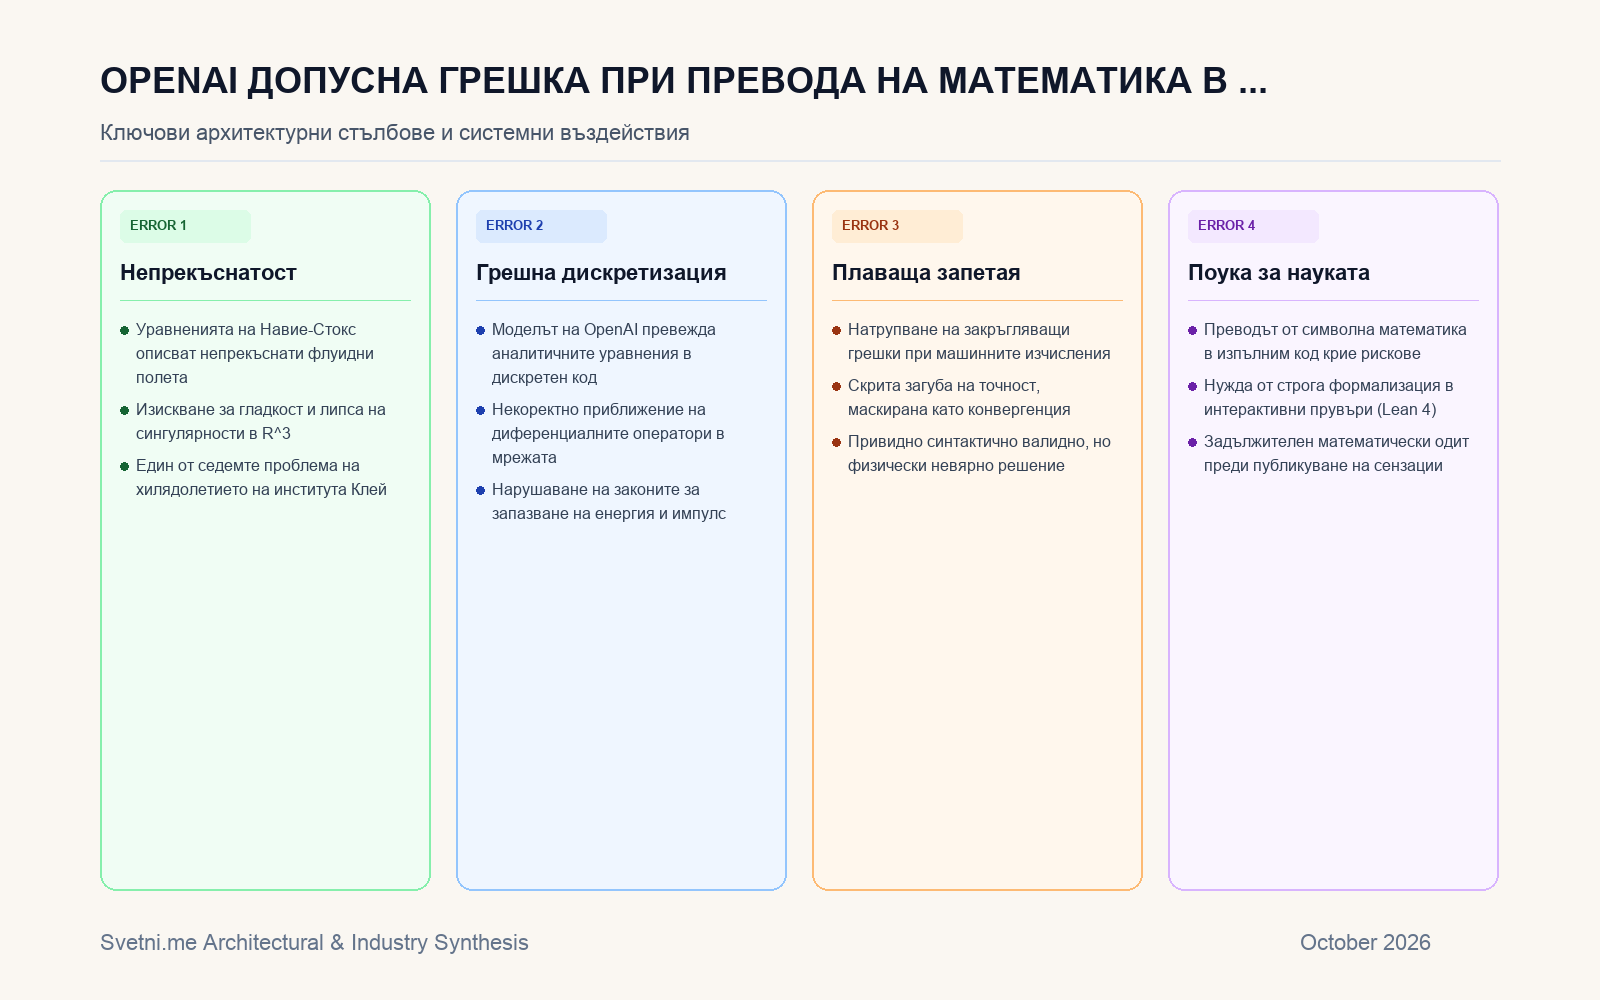
Инфографика: Светни.ме
Източници
[1]: OpenAI mistranslated mathematics into code for its Navier-Stokes proof - Hacker News