DeepSeek пуска с отворен код DeepInfer: Високопроизводителен енджин за моделни изводи
Източник: The Decoder / DeepSeek
Китайската изследователска лаборатория DeepSeek обяви официалното пускане с отворен код на DeepInfer – специализирания високопроизводителен енджин за моделни изводи (inference), който стои зад рекордната скорост и изключително ниските цени на нейните най-популярни езикови модели [1]. Проектът предоставя на глобалната общност пълния набор от нискоlevel оптимизации за паралелно изпълнение, управление на паметта и GPU ядра.
Публикуването на DeepInfer в GitHub предизвика огромен интерес сред системните инженери, тъй като разкрива точните архитектурни механизми, позволили на DeepSeek да сведе разходите за обслужване на токъни до частица от цените на западните конкуренти.
Архитектурен триумф: Multi-Head Latent Attention и FP8 ядра
Основното предимство на DeepInfer се крие в нативната му оптимизация за Multi-Head Latent Attention (MLA) – патентования механизъм за внимание на DeepSeek. При стандартното многоглаво внимание (MHA) размерът на Key-Value (KV) кеша нараства линейно с дължината на контекста и броя на паралелните заявки, бързо изчерпвайки скъпата памет с висока честотна лента (HBM) на графичните ускорители.
DeepInfer компресира ключовете и стойностите в компактно латентно подпространство с нисък ранг, което се декомпресира „в движение“ директно в бързата споделена памет (SRAM) на чипа. Това съкращава обема на KV кеша с над 70%, позволявайки обслужването на гигантски партиди от заявки (batch sizes) без забавяне.
В допълнение, енджинът включва прецизно ръчно оптимизирани GPU изчислителни ядра, написани на Triton и CUDA, които поддържат смесена прецизност във формат FP8 и експериментален FP4. За разлика от стандартните решения, които губят точност при квантизация на вниманието, DeepInfer прилага адаптивно мащабиране на теглата по микро-блокове, постигайки двукратно увеличение на пропускателната способност без деградация на отговорите.
Разрушаване на икономическите бариери пред широкомащабния AI
Отвореният код на DeepInfer нанася мощен удар по досегашния бизнес модел на доставчиците на изчислителна инфраструктура. Досега оптимизираният софтуер за оптимизация на изводите при големи смесици от експерти (MoE) беше запазена марка на затворените облачни платформи или изискваше комплексни лицензи за корпоративни решения като TensorRT-LLM на Nvidia.
С DeepInfer всеки университет, независима изследователска лаборатория или облачен доставчик може да разгърне мащабен клъстер с модели от класа на DeepSeek-V3 и да постигне производителност на ниво световни технологични лидери. Това ускорява комодитизацията на базовия изчислителен слой: когато софтуерът за изводи стане свободен и максимално ефективен, премията за марж на облачните доставчици започва да се топи.
В дългосрочен план ходът на DeepSeek утвърждава нова парадигма в полупроводниковата екосистема. Оказва се, че върховата производителност на изкуствения интелект вече не зависи единствено от закупуването на най-скъпия силиций от следващо поколение, а от дълбокото математическо и алгоритмично съгласуване между софтуерния енджин и физическата архитектура на паметта.
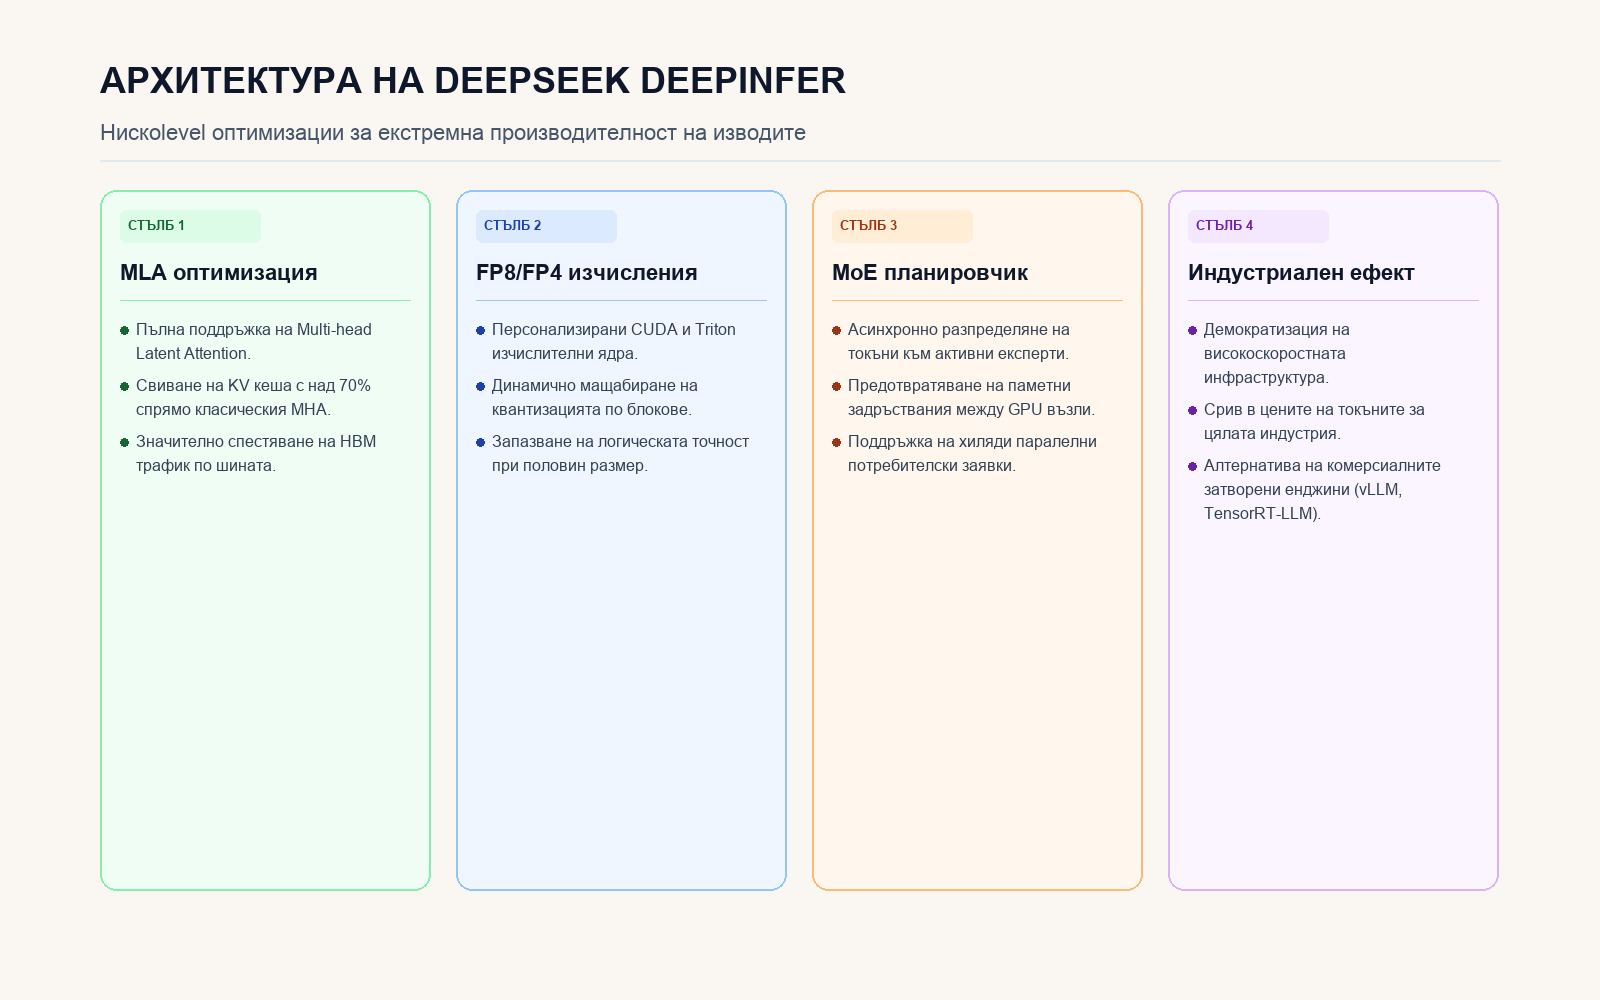
Четири ключови стълба на софтуерните оптимизации и пазарния ефект на енджина DeepInfer.
Източници
- The Decoder. (2026-10-20). Deepseek open-sources the inference engine that powers its fastest and cheapest AI model. The Decoder AI Tech. https://the-decoder.com/deepseek-open-sources-the-inference-engine-that-powers-its-fastest-and-cheapest-ai-model/
- DeepSeek AI GitHub Repository. (2026-10-20). DeepInfer: High-Throughput Low-Latency Inference Engine for MLA and MoE Architectures. GitHub. https://github.com/deepseek-ai/DeepInfer