Деидентификация в голям мащаб: Как Airbnb защитава личните данни на милиони потребители при обучение на AI
Източник: The Airbnb Tech Blog / Medium
Инженерният екип на глобалната туристическа платформа Airbnb разкри архитектурата на своята мащабна система за автоматизирана деидентификация на текст, която пречиства милиони неструктурирани разговори, потребителски отзиви и тикети за поддръжка преди използването им за обучение на модели за машинно обучение [1]. Според публикацията в The Airbnb Tech Blog системата гарантира стриктна защита на личните данни без да разрушава семантичния контекст, необходим на невронните мрежи.
Хибридно разпознаване на именувани обекти (NER) на десетки езици
В платформа като Airbnb чувствителната информация (PII) рядко следва стандартен шаблон: потребителите споделят имена, телефонни номера, кодове за врати, пароли за Wi-Fi и точни адреси на десетки различни езици, често с правописни грешки или съкращения. Обикновените регулярни изрази (regex) пропускат контекстните данни или маскират твърде агресивно обикновени думи.
За да постигне висока чувствителност (recall), Airbnb комбинира детерминистични правила за структурирани идентификатори (кредитни карти, имейли, телефони) с фино настроени многоезични трансформър модели за обработка на естествен език (NLP), които разпознават имена и локации в контекст.
Интелигентно заместване със семантични токени
Вместо да заменя всички чувствителни данни с един и същ блок [REDACTED], което обърква големите езикови модели за това кой говори на кого в дълъг диалог, конвейерът на Airbnb прилага консистентни типови заместители като [GUEST_NAME_1], [HOST_NAME_1] или [DOOR_CODE].
Системата се изпълнява разпределено в инфраструктурата за облачни изчисления на компанията, обработвайки милиарди токени дневно с ниска латентност както за пакетно обучение, така и за RAG потоци в реално време.
Приватността на данните като фундаментален слой на корпоративните AI фабрики
Опитът на Airbnb демонстрира, че най-ценният актив на всяка голяма потребителска платформа — нейните собствени исторически комуникации — не може да бъде използван безопасно за обучение на генеративен AI без индустриален клас деидентификация. При известен риск езиковите модели да запаметяват и възпроизвеждат дословно лични данни от тренировъчния корпус, предварителното саниране на текста е единствената надеждна защита срещу регулаторни глоби по GDPR и загуба на потребителско доверие.
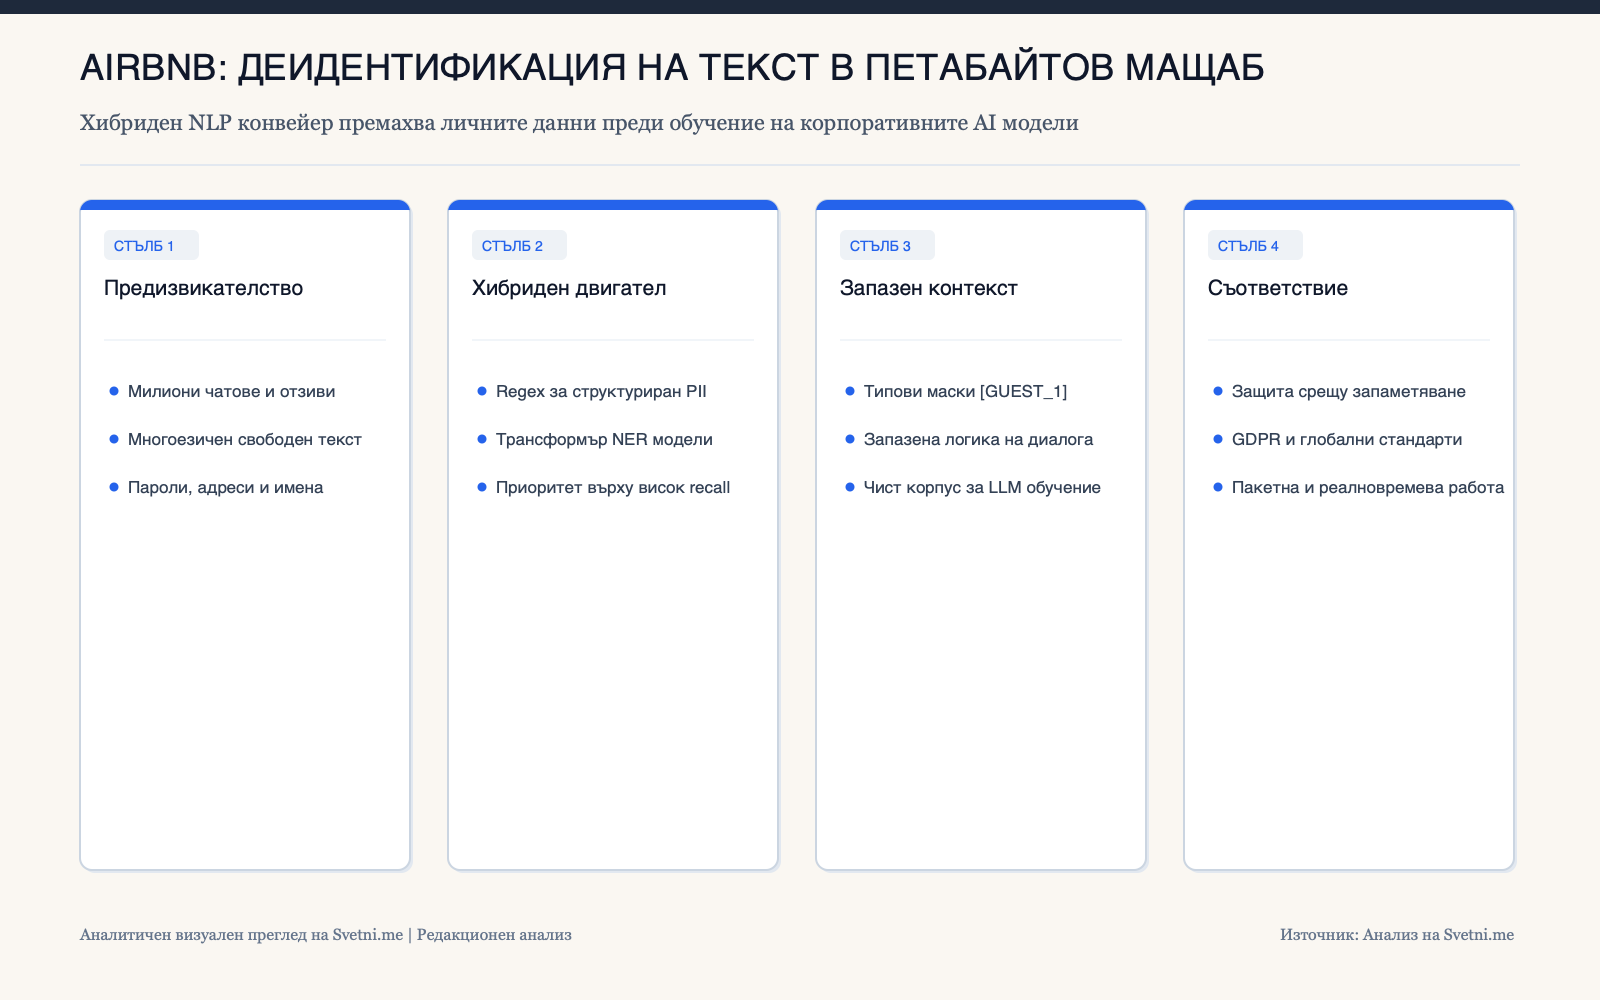
Инфографика: Аналитичен преглед на Svetni.me