Alibaba пуска Qwen4-Max: MoE модел с 2,4 трилиона параметъра, конкуриращ Opus 5.5 и GPT-6 на много по-ниска цена
Източник: The Decoder / Alibaba Cloud
Китайският технологичен гигант Alibaba представи своя нов флагмански модел Qwen4-Max, който влиза в пряка битка с водещите световни системи Claude Opus 5.5, GPT-6 и Kimi K3.1 Pro, но при многократно по-ниска цена за изчисление [1]. Според техническия анализ в The Decoder новата итерация от фамилията Qwen използва ултра-разредена архитектура от тип „смес от експерти“ (Mixture-of-Experts — MoE).
Архитектурна ефективност: 2,4 трилиона общи срещу 71 милиарда активни параметъра
Въпреки че общият капацитет на Qwen4-Max достига внушителните 2,4 трилиона параметъра, фино гранулираният маршрутизиращ механизъм активира само 71 милиарда параметъра при обработката на всеки отделен токен (коефициент на разреденост под 3%). Това позволява на модела да съхранява огромно енциклопедично и програмно знание в паметта, докато изчислителната цена на единица инференс остава съпоставима с тази на среден по размер плътен модел.
В публикуваните бенчмаркове за програмиране (SWE-bench Verified), математическа логика и многоезично агентно изпълнение Qwen4-Max изравнява или леко надминава GPT-6 и Kimi K3.1 Pro, като отстъпва минимално единствено на Claude Opus 5.5 в сложните дълги софтуерни задачи.
Ценова война на пазара на облачни API услуги
Alibaba Cloud позиционира Qwen4-Max агресивно с цени за входни и изходни токени, които са между 65% и 80% по-ниски от тарифите на американските лаборатории за техните флагмански модели.
Тази ефективност е пряк резултат от системните оптимизации в китайските лаборатории в Китай, принудени да извличат максимална производителност от ограничените наличности на полупроводников хардуер.
Ултра-разредените MoE модели като оръжие за ценова дефлация
Дебютът на Qwen4-Max потвърждава, че архитектурната иновация при маршрутизирането на експертни подмрежи (fine-grained MoE) се превръща в основен фактор за конкурентоспособност при големите езикови модели. Когато модел с трилионен мащаб може да се изпълнява с изчислителния отпечатък на 70-милиардна мрежа, високите маржове на западните API доставчици стават неустойчиви.
Това ще ускори глобалната дефлация на цените на интелигентността и ще засили натиска върху корпоративните ИТ директори да оценяват моделите по съотношението цена-производителност за конкретен работен поток.
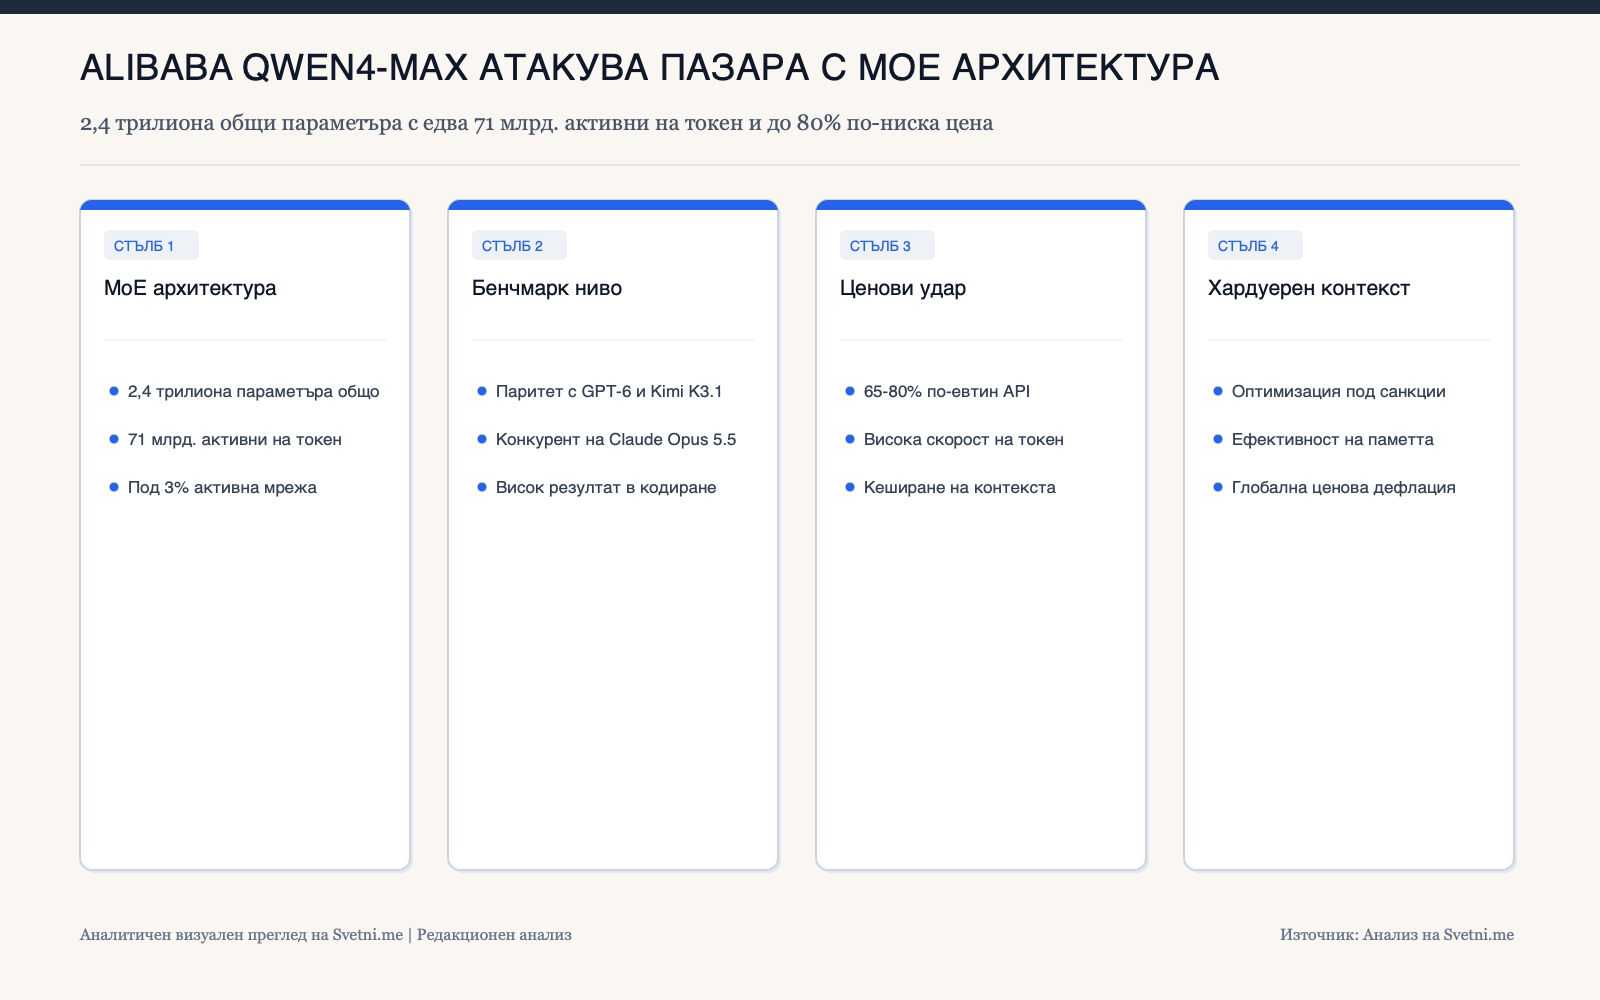
Инфографика: Аналитичен преглед на Svetni.me