Мащабен анализ на 27 280 агентни сесии: 64% от разходите за инференс отиват за неуспешни опити
Източник: Runta / FrontierHarness Eval
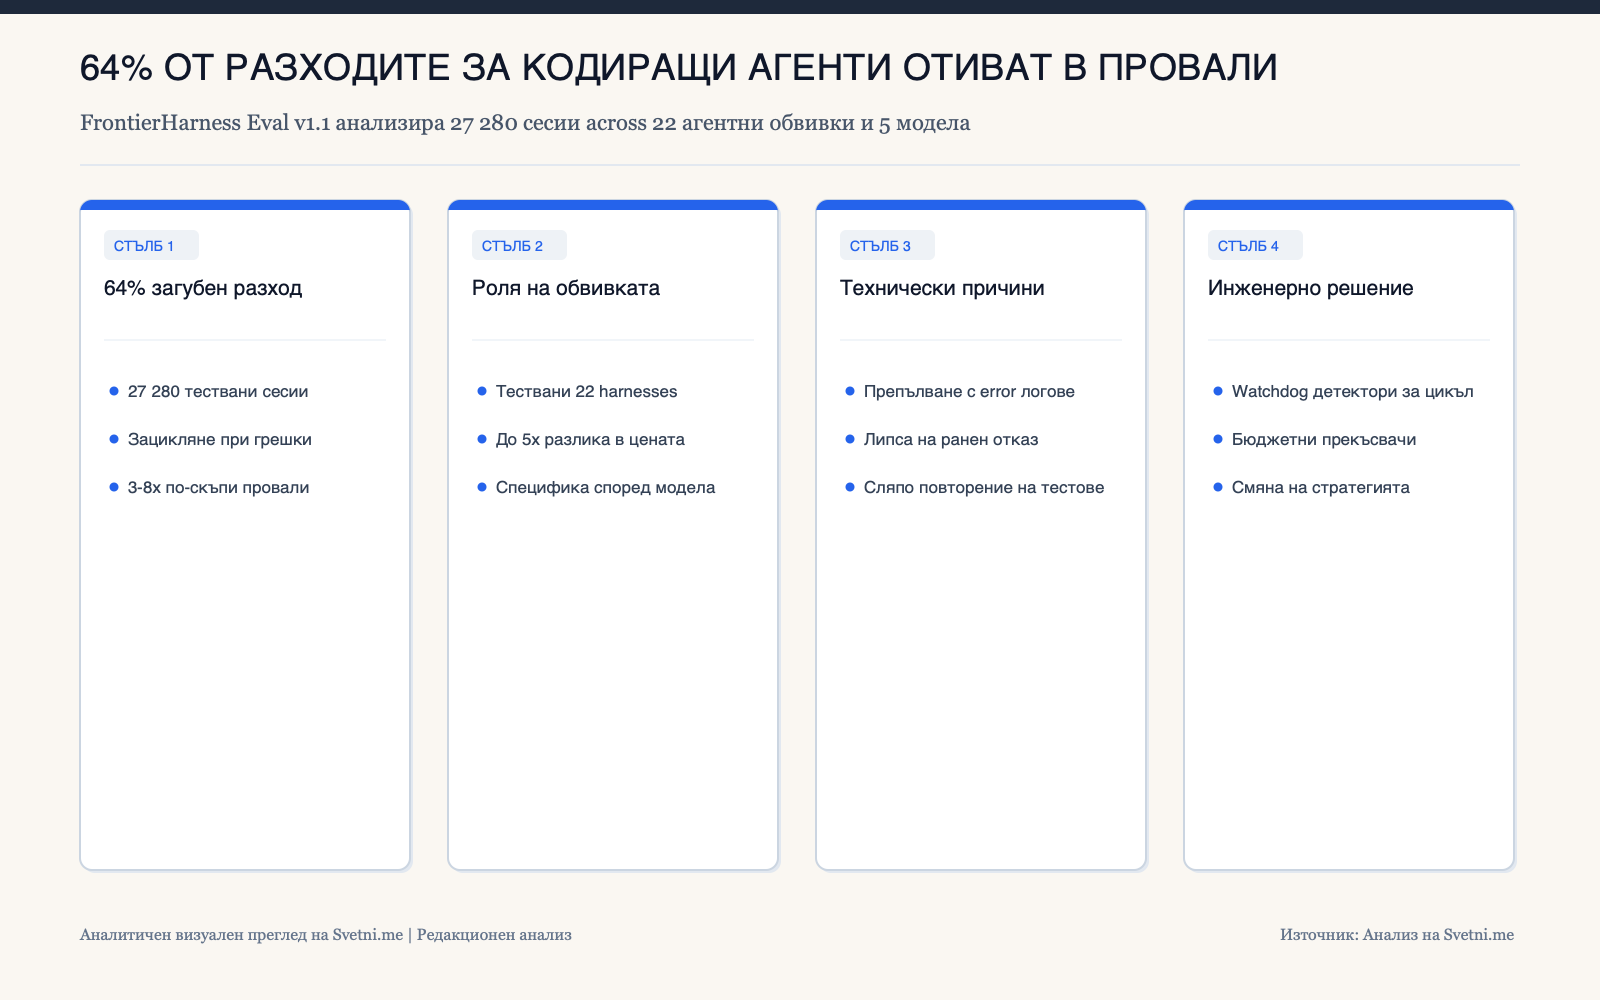
Емпирично проучване на платформата Runta, обхващащо 27 280 реални изпълнения на автономни кодиращи AI агенти, разкрива стряскаща икономическа неефективност: цели 64% от общите разходи за инференс са отишли за сесии, които в крайна сметка са се провалили [1]. Според доклада за бенчмарка FrontierHarness Eval v1.1 проблемът се крие във взаимодействието между базовия модел и управляващата го агентна обвивка (harness).
Методология: 22 агентни обвивки срещу 5 водещи модела
Екипът на Runta е тествал 22 различни софтуерни обвивки (harnesses) в комбинация с 5 водещи големи езикови модела върху едни и същи 62 инженерни задачи, повторени по четири пъти. Резултатите от тези бенчмаркове показват, че когато един агент тръгне по грешна архитектурна следа, той рядко се предава бързо.
Вместо това неуспешните сесии влизат в дълги цикли на компилиране, четене на огромни логове с грешки и повторно генериране на код, консумирайки от 3 до 8 пъти повече токени от успешните сесии, преди да достигнат лимита за време или стъпки.
Огромни ценови разлики при един и същ базов модел
Едно от най-важните открития за софтуерното инженерство е, че изборът на агентна обвивка променя радикално цената на задачата дори при фиксиран модел. Най-скъпата обвивка е струвала между 1,8 и 5,0 пъти повече на решена задача от най-евтината при използване на абсолютно същия LLM.
Освен това нито една обвивка не се е оказала универсален победител: обвивката с най-добра възвръщаемост за моделите на Anthropic се е представяла посредствено с моделите на OpenAI и обратно.
Ранното прекратяване на обречени траектории като приоритет за FinOps
Данните от FrontierHarness Eval v1.1 обясняват защо компании като Salesforce са принудени да въвеждат спешни токен бюджети. Когато близо две трети от облачната сметка за AI програмиране се изгарят в обречени на провал цикли, оптимизацията на единичната цена на токен е второстепенна.
Истинският пробив в FinOps за кодиращи агенти ще дойде от интелигентни надзорни модели (watchdog classifiers), способни да разпознават симптомите на зацикляне още на третата итерация и да спират или рестартират агента с чист контекст.
Инфографика: Аналитичен преглед на Svetni.me