Транслация на KV-кеша: Как инженерите от Hostinger научиха различни AI модели да споделят работна памет
Източник: Hostinger Blog / Hostinger Research
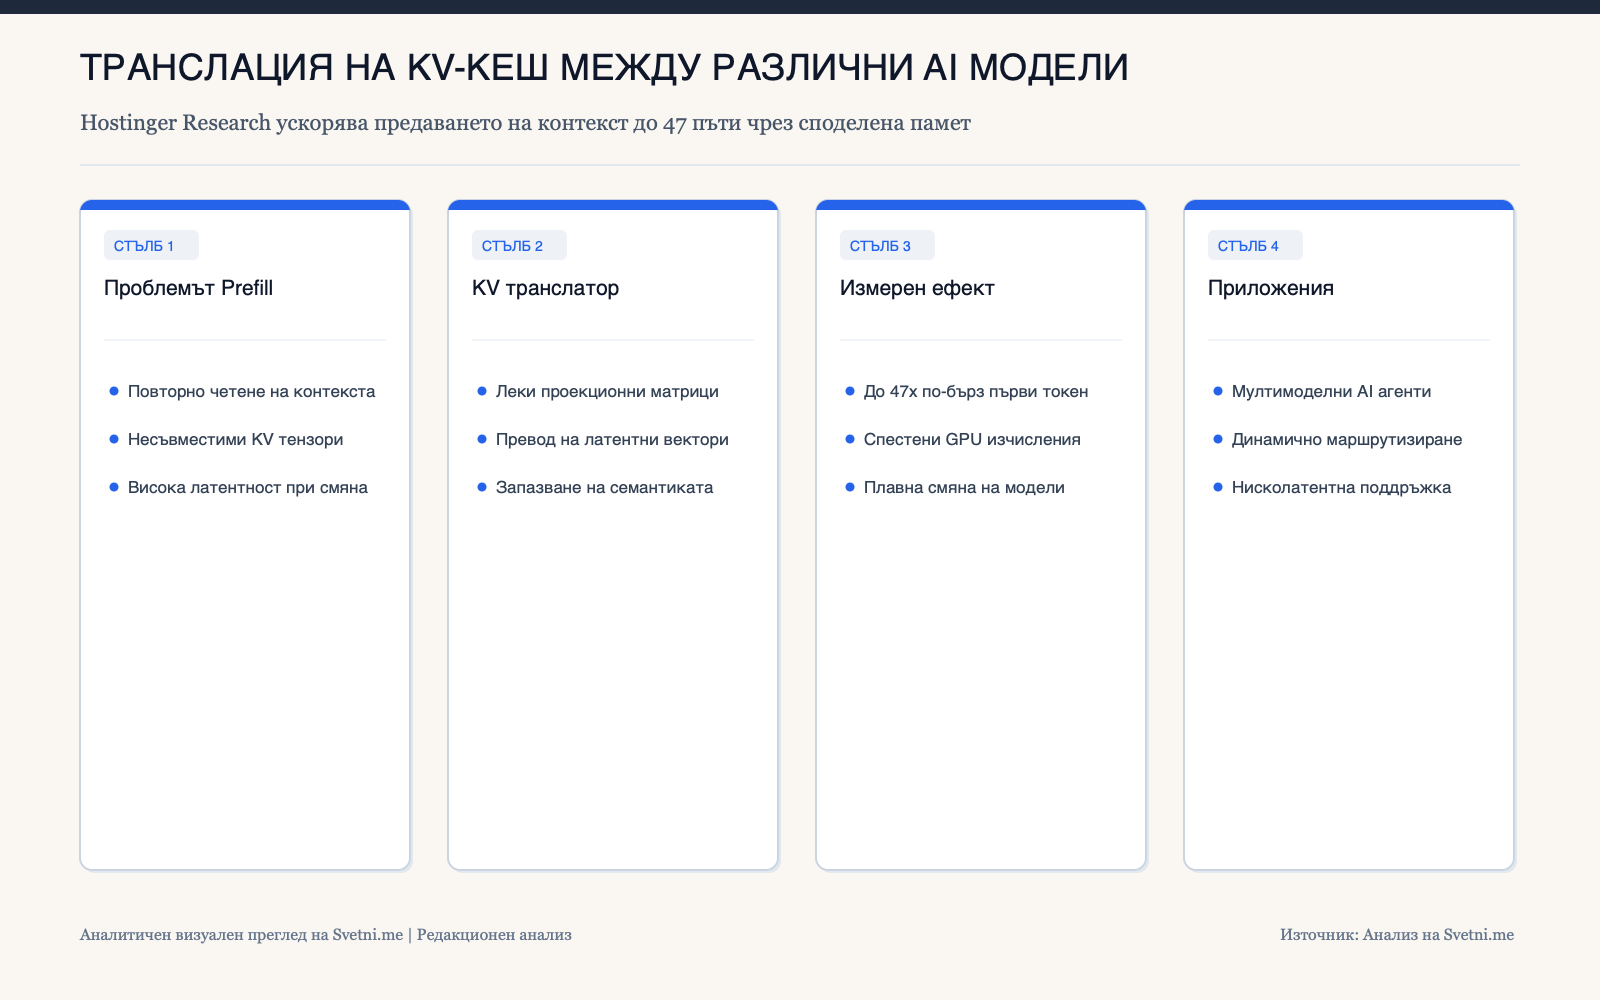
Изследователското звено Hostinger Research представи иновативен метод за транслация на KV-кеша (KV-cache), който позволява на един голям езиков модел директно да поеме разговора и работната памет на друг модел с различна архитектура, започвайки да генерира отговор до 47 пъти по-бързо [1]. Според публикацията в инженерния блог на компанията пробивът елиминира нуждата от повторно преизчисляване на целия текстов контекст при смяна на модела.
Проблемът с „амнезията“ при многомоделна маршрутизация
В съвременните продукционни системи за AI агенти рутинните запитвания се обслужват от бързи и малки модели, но при поява на сложен технически въпрос разговорът се прехвърля към голям разсъждаващ модел. Тъй като всеки модел има собствено векторно пространство в своята трансформър архитектура, вторият модел не разбира вътрешните състояния (Key-Value тензорите) на първия.
Поради това системата е принудена да изпрати целия натрупан лог от хиляди токени като суров текст и да изчака тежката фаза на предварително запълване (prefill), което забавя първия токен с десетки секунди.
Леки проекционни адаптери за директно преобразуване на паметта
Екипът на Hostinger обучава компактни линейни и нелинейни проекционни матрици (транслатори), които картографират латентното пространство на ключовете и стойностите от изходния модел директно във формата на целевия модел.
По този начин при предаване на щафетата целевият модел получава вече готовия преведен KV-кеш и прескача фазата на prefill, намалявайки латентността на инференс до 47 пъти при дълги контексти с минимална загуба на точност.
Споделената латентна памет като основа за рояци от хетерогенни агенти
Транслацията на KV-кеша решава едно от най-големите системни тесни места в оркестрацията на мултиагентни системи. Досега естественият човешки език служеше като единствения, но изключително бавен протокол за комуникация между модели от различни фамилии (напр. от Qwen към Llama или Mistral).
Възможността за директен пренос на компресирани тензорни състояния между различни модели превръща хетерогенните AI клъстери в единна изчислителна система със споделена оперативна памет.
Инфографика: Аналитичен преглед на Svetni.me