Lambda внедрява оптика със съвместно опаковане на NVIDIA в AI клъстер с над 10 000 GPU
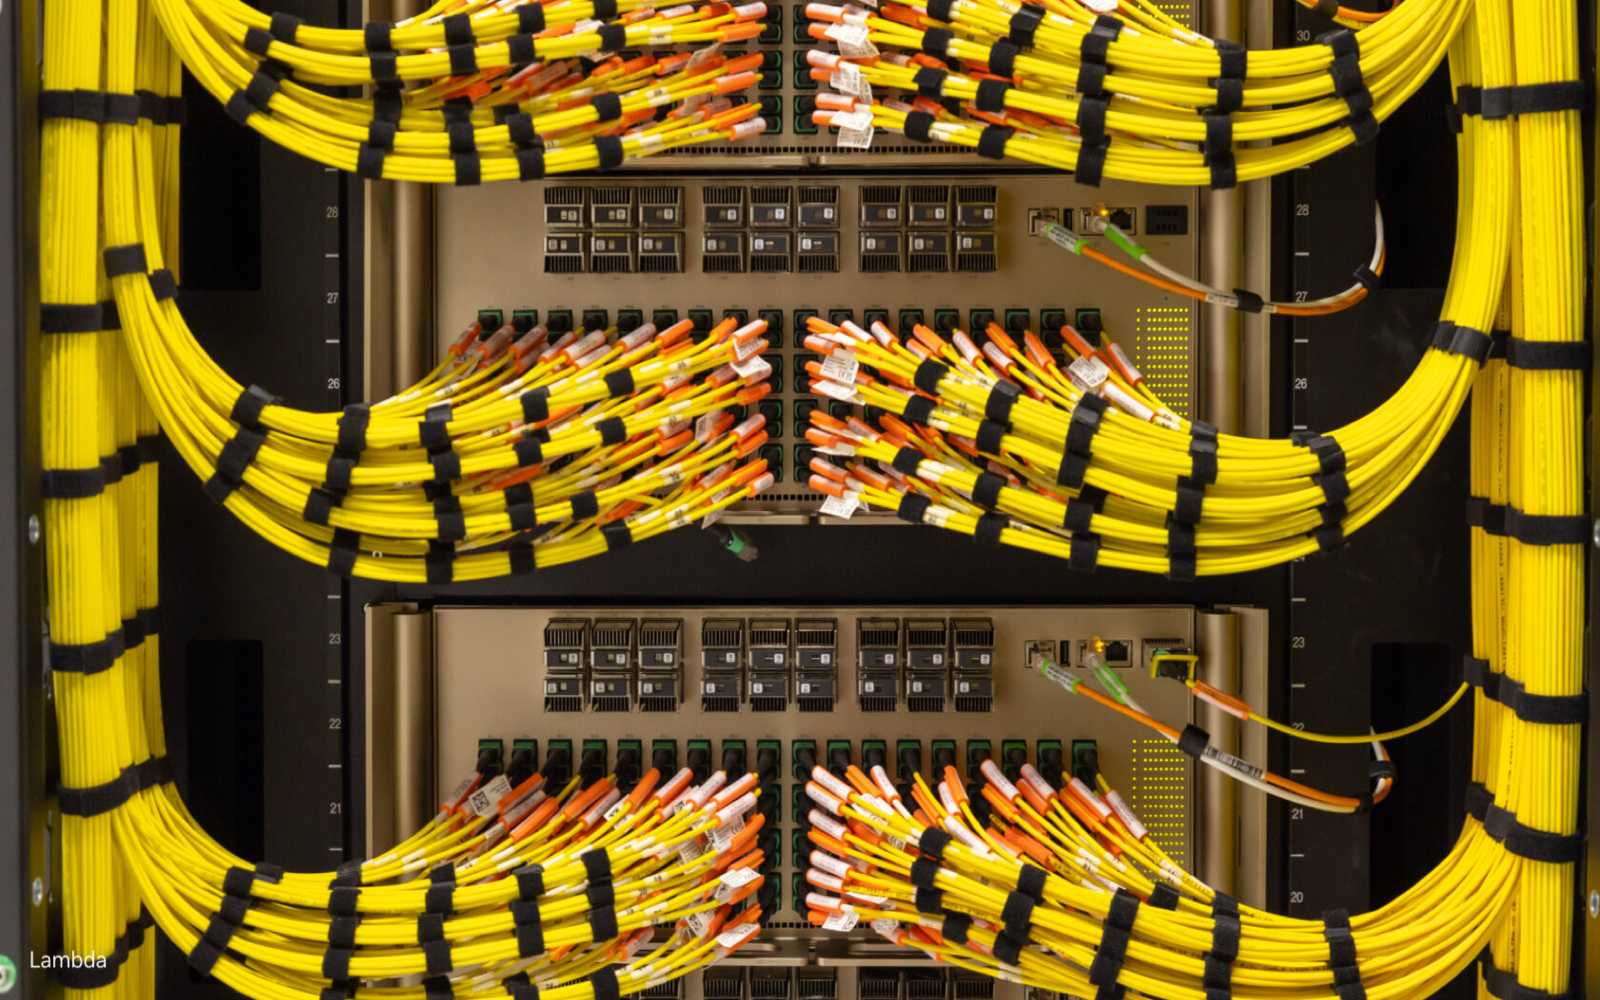
Източник: Lambda / NVIDIA Blog (снимка от мрежова инсталация в клъстера на Lambda)
Според публикация в блога на NVIDIA [1] облачният доставчик Lambda използва комутатори NVIDIA Photonics със съвместно опакована оптика (CPO) за свързване на стелажи NVIDIA GB300 NVL72 с над 10 000 GPU. Целта са по-малък разход на енергия, по-висока устойчивост и по-дълго средно време между прекъсвания (MTBI) в AI фабрика от такъв мащаб. Lambda обявява внедряването като първото мащабно в света, а в собственото си съобщение уточнява, че GPU са Blackwell Ultra, а площадката е в Квебек [2].
Защо мрежата е ключова за енергийната ефективност
Обучението на AI модел изисква хиляди GPU да работят заедно през бърза, ефективна и устойчива мрежа. Според NVIDIA при голямо обучение една прекъсната връзка може да спре хиляди графични процесори, а при агентен инференс едно мрежово прекъсване води до каскадни закъснения при много агенти. Всяко прекъсване струва време, а всеки ват, похарчен за мрежа, е ват, който не е наличен за изчисления [1].
Как работи съвместно опакованата оптика
Технологията, свързана със силициевата фотоника, замества класическите щекерни (pluggable) трансиъвъри с оптични двигатели, монтирани директно в корпуса на комутатора. Според NVIDIA това дава до 5 пъти по-добра енергийна ефективност и до 15 пъти по-висока надеждност спрямо конвенционалната щекерна оптика, като се ползват и 4 пъти по-малко лазери, т.е. по-малко компоненти, които могат да откажат [1].
Електрическият път се скъсява от инчове на милиметри, което намалява загубите на сигнал. Отпадат и ретаймер чиповете, което намалява както потреблението, така и броя на частите по сигналния път [2].
Конфигурацията на Lambda
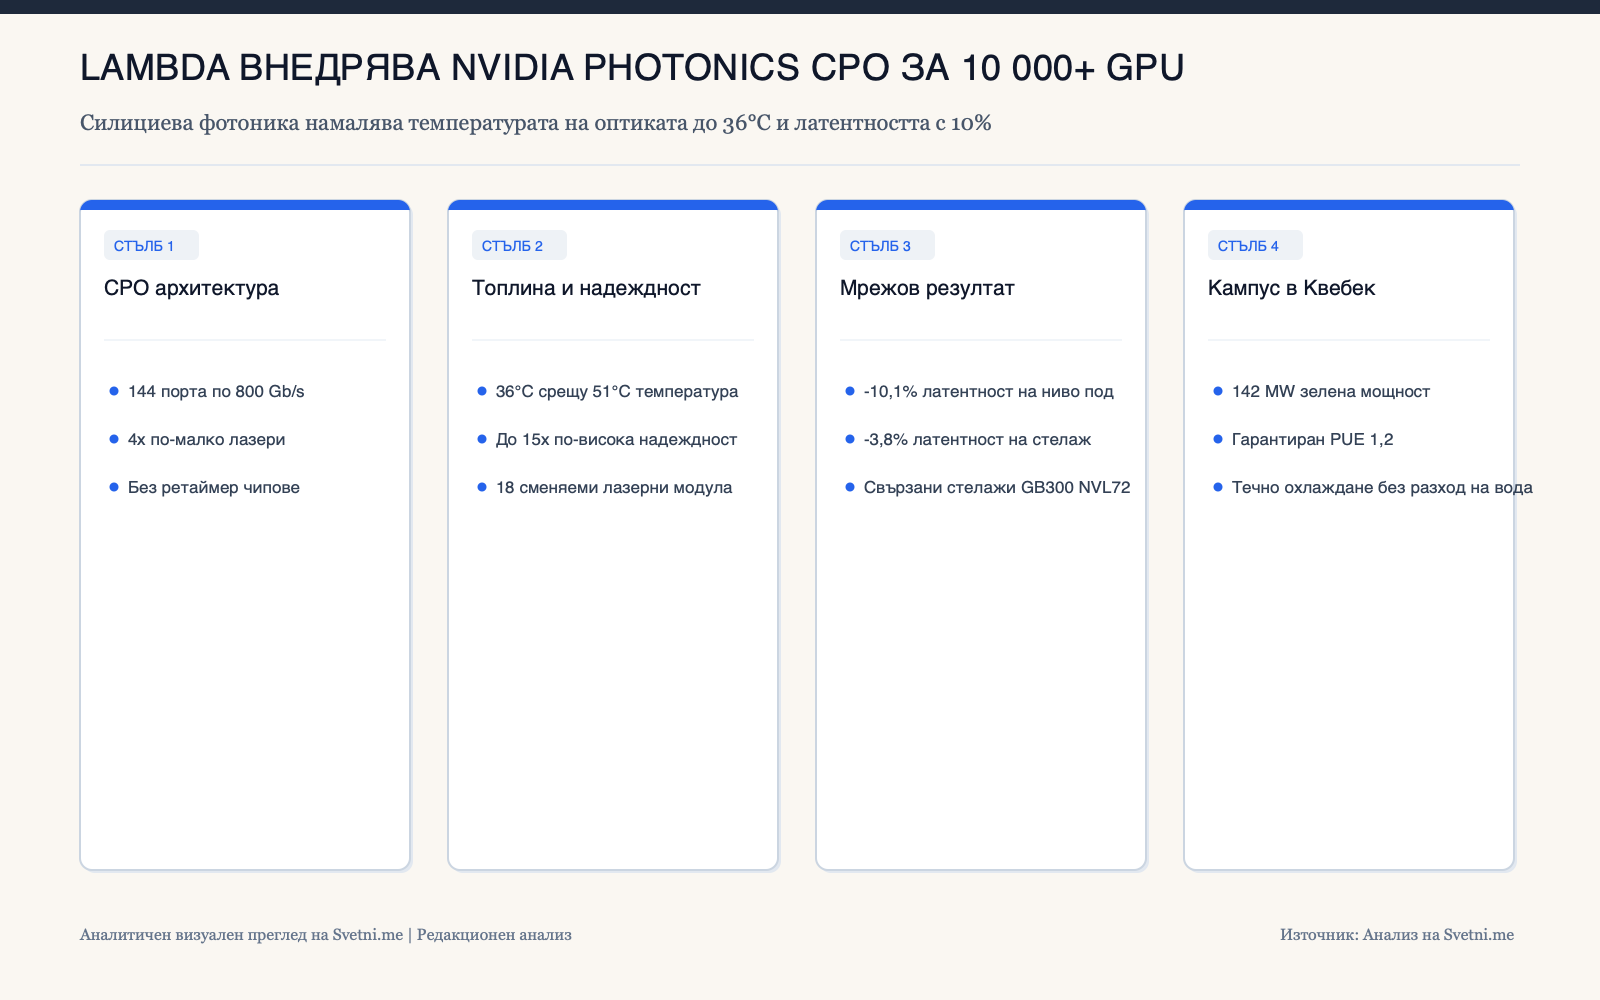
Внедряването използва комутатори NVIDIA Photonics със 144 порта по 800 Gb/s всеки. Течно охлаждане отвежда топлината от чипа на комутатора и оптичните двигатели. Всеки комутатор има 18 сменяеми външни източника на светлина, които захранват оптичните двигатели. Техници могат да сменят светлинните модули на място, докато при традиционната щекерна оптика при отказ на лазер трябва да се подмени целият модул [1].
Измерените резултати
При тестове на Lambda мрежовата латентност намалява с около 4% на ниво стелаж и с до около 10% на ниво под (pod). По-точните стойности от съобщението на компанията са 3,8% при стелаж и 10,1% при под, като разликата расте с мащаба. Пропускателната способност остава същата като при конвенционалната оптика във всички конфигурации (стелаж, мащабируема единица и под) [2].
Компанията отчита медианна температура на оптиката 36°C срещу 51°C при конвенционалните щекерни модули и по-стабилна целост на сигнала. NVIDIA свързва по-хладната и по-стабилна оптика с до 15 пъти по-висока надеждност, която помага обученията да не се прекъсват [2].
Енергийно ефективен кампус
Според съобщението на Lambda кампусът в Квебек работи със 142 MW осигурен капацитет от почти 100% възобновяема енергия, позволява безплатно (свободно) охлаждане до 80% от годината и има гарантиран PUE 1,2 без потребление на технологична вода за охлаждане на сървърите. Внедряването ще бъде представено в специалното обръщение на NVIDIA на SC26 [2].
Анализ: мрежата като фактор в енергийния баланс на AI инфраструктурата
Този раздел съдържа редакционна интерпретация на публикуваните данни. Изводите са на редакцията и не са твърдения на NVIDIA или Lambda.
Фиксиран бюджет на мощността
Кампус с 142 MW е ограничен от осигурения си капацитет. В такава рамка ватовете, които мрежата не използва, не изчезват, а остават налични за изчисления; точно това твърди и NVIDIA с фразата за ват, който не е наличен за изчисления. Затова ефективността на мрежовия слой е енергиен въпрос на ниво кампус, а не само на ниво комутатор. Приложената в материала цифра „до 5 пъти“ е обща заявка на NVIDIA за технологията, а не резултат, измерен от Lambda в този клъстер. Lambda публикува измервания за латентност, температура и пропускателна способност, но не и за потребление на ток.
Надеждността като производителност
Лазерите са сред компонентите, които отказват. Подходът с 4 пъти по-малко лазери и с 18 сменяеми светлинни източника на комутатор променя сервизния модел: вместо подмяна на цял модул при отказ се сменя само източникът на светлина. При обучение върху над 10 000 GPU, където по думите на NVIDIA една прекъсната връзка спира много процесори, всеки избегнат инцидент превръща мрежовата надеждност в повече полезни GPU часове. Именно това е аргументът в цитата на Гилад Шайнер от NVIDIA.
Топлинна архитектура
Разликата от 15°C в медианната температура на оптиката (36°C срещу 51°C) показва, че разместването на оптиката към корпуса на комутатора е свързано с топлинния дизайн. В конфигурацията на Lambda течното охлаждане обхваща и чипа, и оптичните двигатели. Така мрежовото оборудване не е периферия към охлаждането на изчислителните стелажи, а част от същата топлинна система. Съчетанието с кампус със свободно охлаждане до 80% от годината и PUE 1,2 показва, че ефективността се търси на няколко нива едновременно: чип, комутатор, стелаж и сграда.
Мащабът на доказателствата
Данните идват от тестове на самия доставчик и от материал на производителя на технологията. Става дума за едно внедряване на един кампус, а в източниците няма цени, разходи на ват или сравнение с други производители. Колко от ползите ще се запазят при други топологии и по-големи клъстери, предстои да се види. Затова днешният резултат е най-добре да се чете като доказателство за осъществимост в голям мащаб, а не като окончателна оценка на технологията.
Системният извод
Ако мрежата се приема за енергиен ресурс, а не само за комуникационен, оптимизацията на AI инфраструктурата излиза извън чиповете. Конкуренцията между доставчиците на AI облак ще се води и по това колко полезна изчислителна работа получават от всеки мегават и от всеки час без прекъсване, а не само по броя GPU. Съобщението на Lambda показва, че оптиката, охлаждането и избраният кампус се оптимизират заедно.
Инфографика: Ключови стълбове и анализ