Езиковите модели вече могат сами да презаписват собствените си тегла чрез разсъждение без градиенти и повторно обучение
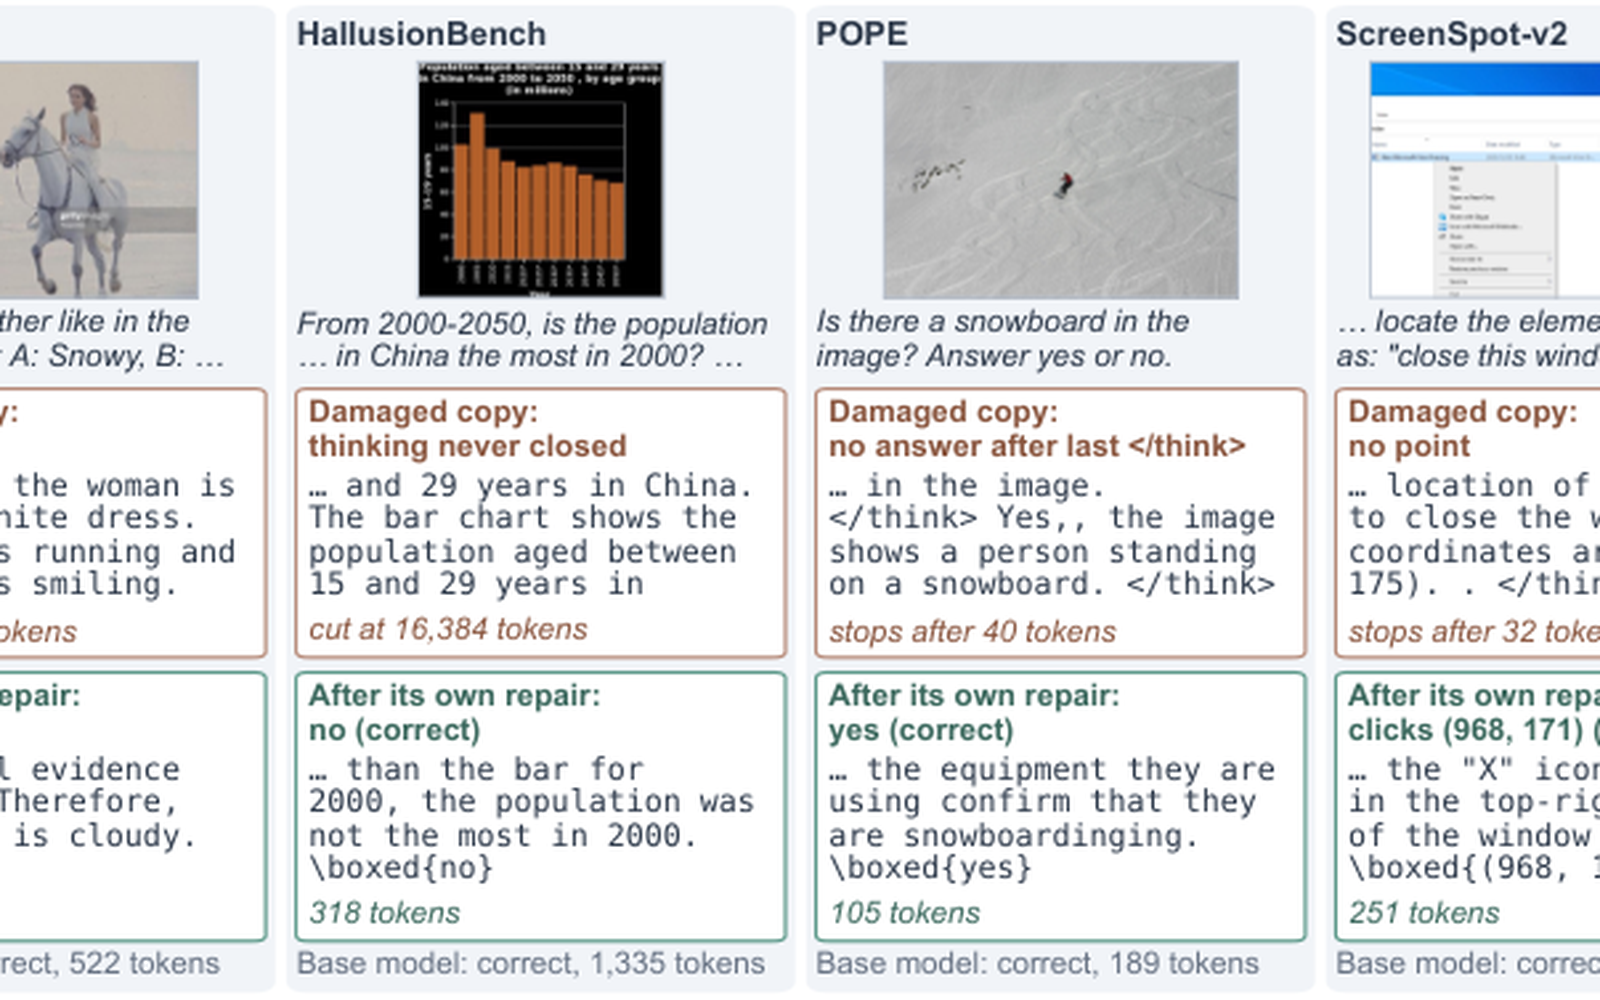
Източник: arXiv:2611.21885 / Експериментална визуализация на самомодифициране и възстановяване на теглата при 27B модел
Ново фундаментално изследване, публикувано в научното хранилище arXiv (arXiv:2611.21885) от екип учени с водещи автори Дзядзюн Фан, Нийл Хе, Чанги Янг и Ге Лю, демонстрира за първи път как отворен езиков модел с 27 милиарда параметъра може самостоятелно да диагностицира грешките си и директно да презаписва собствените си параметрични тегла единствено чрез логическо разсъждение — без изчисляване на градиенти, без обратно разпространение на грешката (backpropagation) и без външен тренировъчен цикъл [1]. Авторите наричат тази трета парадигма „самопрезаписване“ (self-rewriting), при която самият модел действа като свой собствен оптимизатор по време на инференс [1, 2].
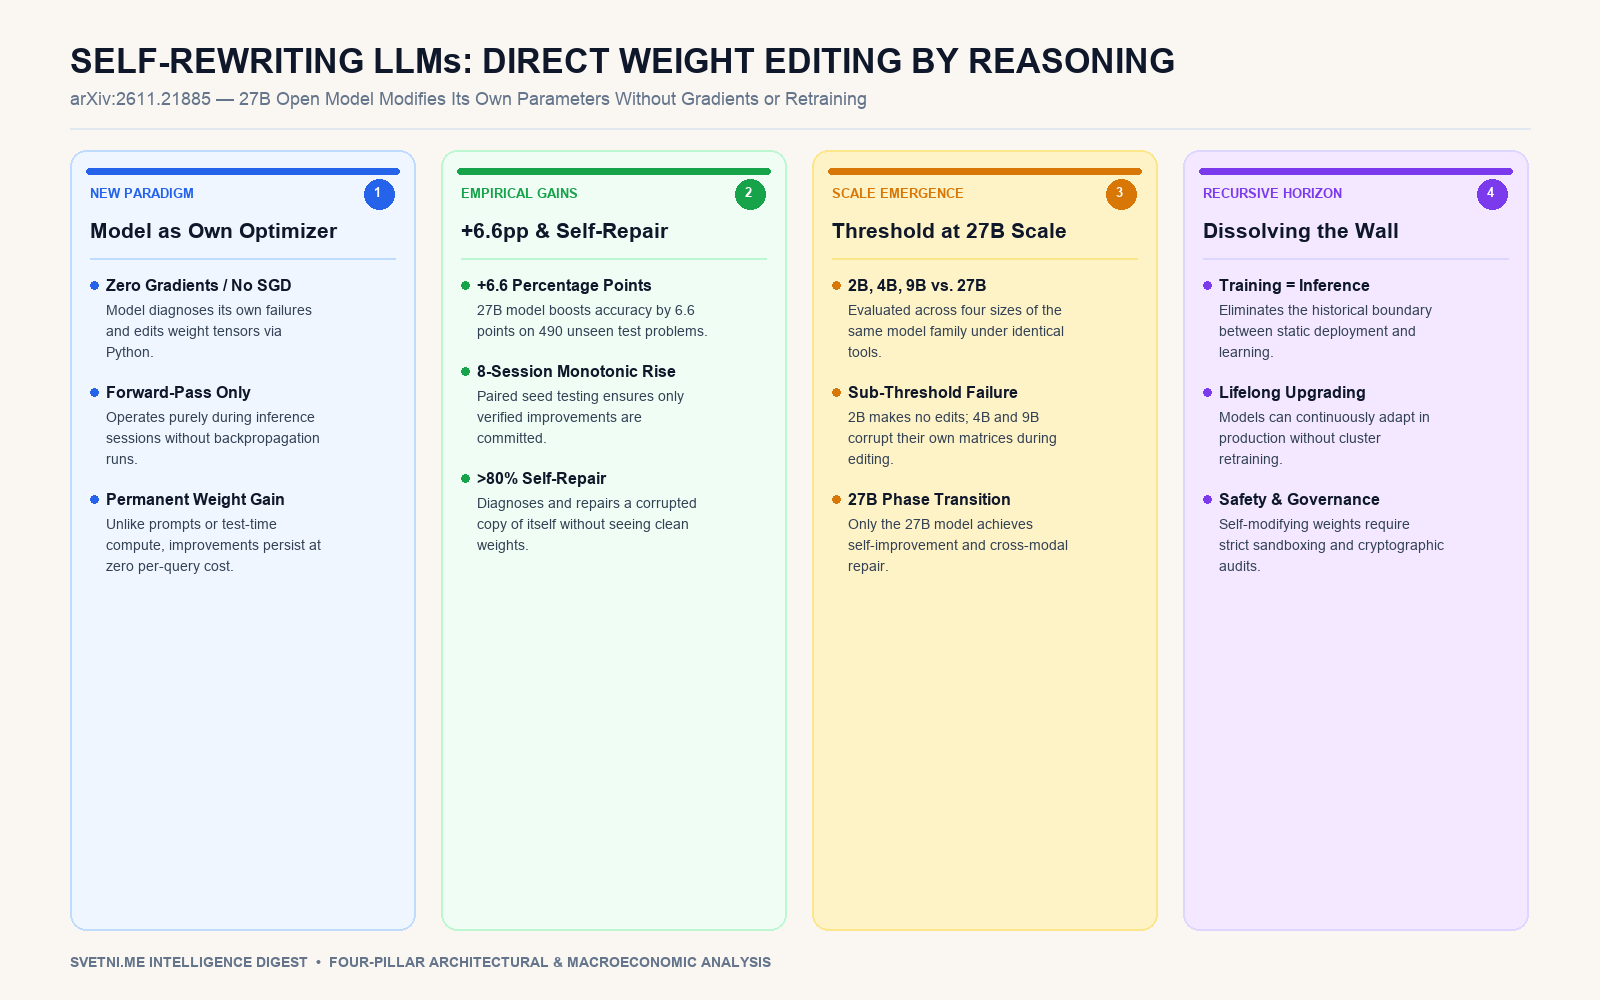
Инфографика: Ключови стълбове и анализ
Отвъд замразените тегла: Моделът като собствен оптимизатор в Python сесия
Традиционно всички големи езикови модели се обучават веднъж върху огромни изчислителни клъстери, след което техните параметри се замразяват преди внедряване [1]. Досега подобряването на вече пуснат модел изискваше или нов скъп тренировъчен цикъл с градиентни оптимизатори, или временни надстройки по време на инференс (промпт инженерство, външни скелети и допълнително време за разсъждение), чийто ефект изчезва веднага след края на сесията. Макар в предходни експерименти голям фронтиерен модел да е успявал да редактира теглата на много по-малък модел отвън, тук за първи път моделът редактира самия себе си [2].
В експерименталната постановка на самопрезаписващите се модели на един отворен 27-милиарден модел се предоставя достъп до собствените му теглови тензори в интерактивна Python среда, заедно с оценените му отговори върху тренировъчни задачи и възможността да стартира самия себе си [1, 2]. Всички градиенти и външни оптимизатори са строго блокирани. Моделът инспектира скритите си състояния (hidden states) и изходните матрици на блоковете за внимание и MLP слоевете, формулира хипотеза за причината за грешките си, записва нови числени стойности директно в тензорите си и провежда т.нар. „сдвоен тест“ (paired test) върху едни и същи генераторни семена (seeds), за да потвърди обективно дали редакцията подобрява работата му, преди да я запази [2].
+6,6 процентни пункта по-висока точност и самовъзстановяване на повредено копие
Емпиричните резултати показват, че моделът реално надминава първоначалната си версия: собствената му редакция на теглата повишава точността му с 6,6 процентни пункта върху 490 напълно непознати тестови задачи в предварително фиксиран сдвоен тест [1, 2]. Още по-впечатляваща е устойчивостта на процеса във времето — тъй като моделът валидира всяка промяна върху практически задачи и записва само редакциите, които доказано работят, в рамките на осем последователни сесии на самопрезаписване неговата точност расте монотонно от сесия към сесия [1].
Изследователите подлагат 27-милиардния модел и на екстремен тест за самовъзстановяване, аналогичен на повреден робот, който трябва да се поправи сам без резервни чертежи [1]. На модела се подава увредено копие на собствените му тегла, което не може да реши почти нито една задача, като му се казва единствено, че някои стойности са компрометирани, без да му се позволява да чете оригиналните здрави тегла. Чрез анализ на аномалиите в активациите си моделът самостоятелно локализира повредата в матриците, презаписва дефектните параметри и възстановява над 80 процента от оригиналната си точност върху шест визуални бенчмарка с изображения, които никога не е виждал по време на ремонта [1, 2].
Емерджентно свойство на мащаба: Прагът при 27 милиарда параметъра
Ключово научно откритие в труда е, че способността за самопрезаписване възниква рязко с увеличаването на мащаба на невронната мрежа [1, 2]. Екипът провежда идентични експерименти със същите инструменти и задачи върху четири модела от една и съща архитектурна фамилия с размер 2 милиарда (2B), 4 милиарда (4B), 9 милиарда (9B) и 27 милиарда (27B) параметъра [2].
Резултатите очертават ясен фазов преход: най-малкият 2B модел не успява да извърши никаква редакция, докато моделите с 4B и 9B параметъра правят неточни промени, които разрушават собствената им функционалност [1, 2]. Единствено 27-милиардният модел притежава достатъчно дълбока мета-когнитивна способност и управление на токенния си бюджет, за да диагностицира прецизно параметричните си дефекти, да проведе серия от верификационни тестове и успешно да подобри както собствените си тегла, така и повреденото си копие.
Заличаване на стената между обучение и инференс: Пътят към рекурсивното самоусъвършенстване
Изследването в arXiv поставя под въпрос една от най-дълбоките догми в съвременното машинно обучение — че разделението между фазата на обучение (training) и фазата на изпълнение (inference) е фундаментално свойство на изкуствения интелект. Както подчертават авторите, „стената между обучението и инференса е ограничение на нашите инструменти, а не свойство на интелигентността“ [1]. За разлика от скалирането на изчисленията по време на тест (test-time scaling), което изисква допълнителен разход на енергия и време при всеки отделен въпрос, самопрезаписващите се модели записват наученото директно в теглата си чрез обикновени прави пасове (forward passes), правейки подобрението перманентно и без никакъв допълнителен разход при последващи отговори — пробив с огромно значение за оптимизацията на инференса.
В дългосрочен архитектурен и системен план тази демонстрация представлява първата емпирична стъпка към истинско рекурсивно самоусъвършенстване. Модел, който подобно на човешкия мозък не разделя ученето от практическото мислене, може да продължи да се модернизира през целия си експлоатационен живот директно в продукционна среда, без нужда от по-голям модел-учител, без промпт инженерство и без скъпи цикли на претрениране. Същевременно способността на големите езикови модели сами да модифицират теглата си поставя изцяло нови изисквания пред киберсигурността и управлението на ИИ: бъдещите автономни системи ще се нуждаят от строги криптографски одити на тегловите версии и изолирани верификационни среди, за да се гарантира, че самопрезаписването винаги остава в границите на зададените правила за безопасност.