OpenAI намали цената на най-добрия си модел за разсъждения с 20%: пробив в компресията на KV-кеша и инференс ефективността
Източник: Wikimedia Commons / SARA Computing
Водещата лаборатория за изкуствен интелект OpenAI обяви незабавно 20-процентно намаление на цените за входящи и изходящи токени на своя флагмански модел за сложни разсъждения [1]. Ценовата корекция обхваща както разработчиците през приложния програмен интерфейс (API), така и корпоративните абонати, като е резултат от серия дълбоки архитектурни пробиви в оптимизацията на инференса, компресията на KV-кеша и агресивното динамично пакетиране на заявки върху клъстери от модерни полупроводници.
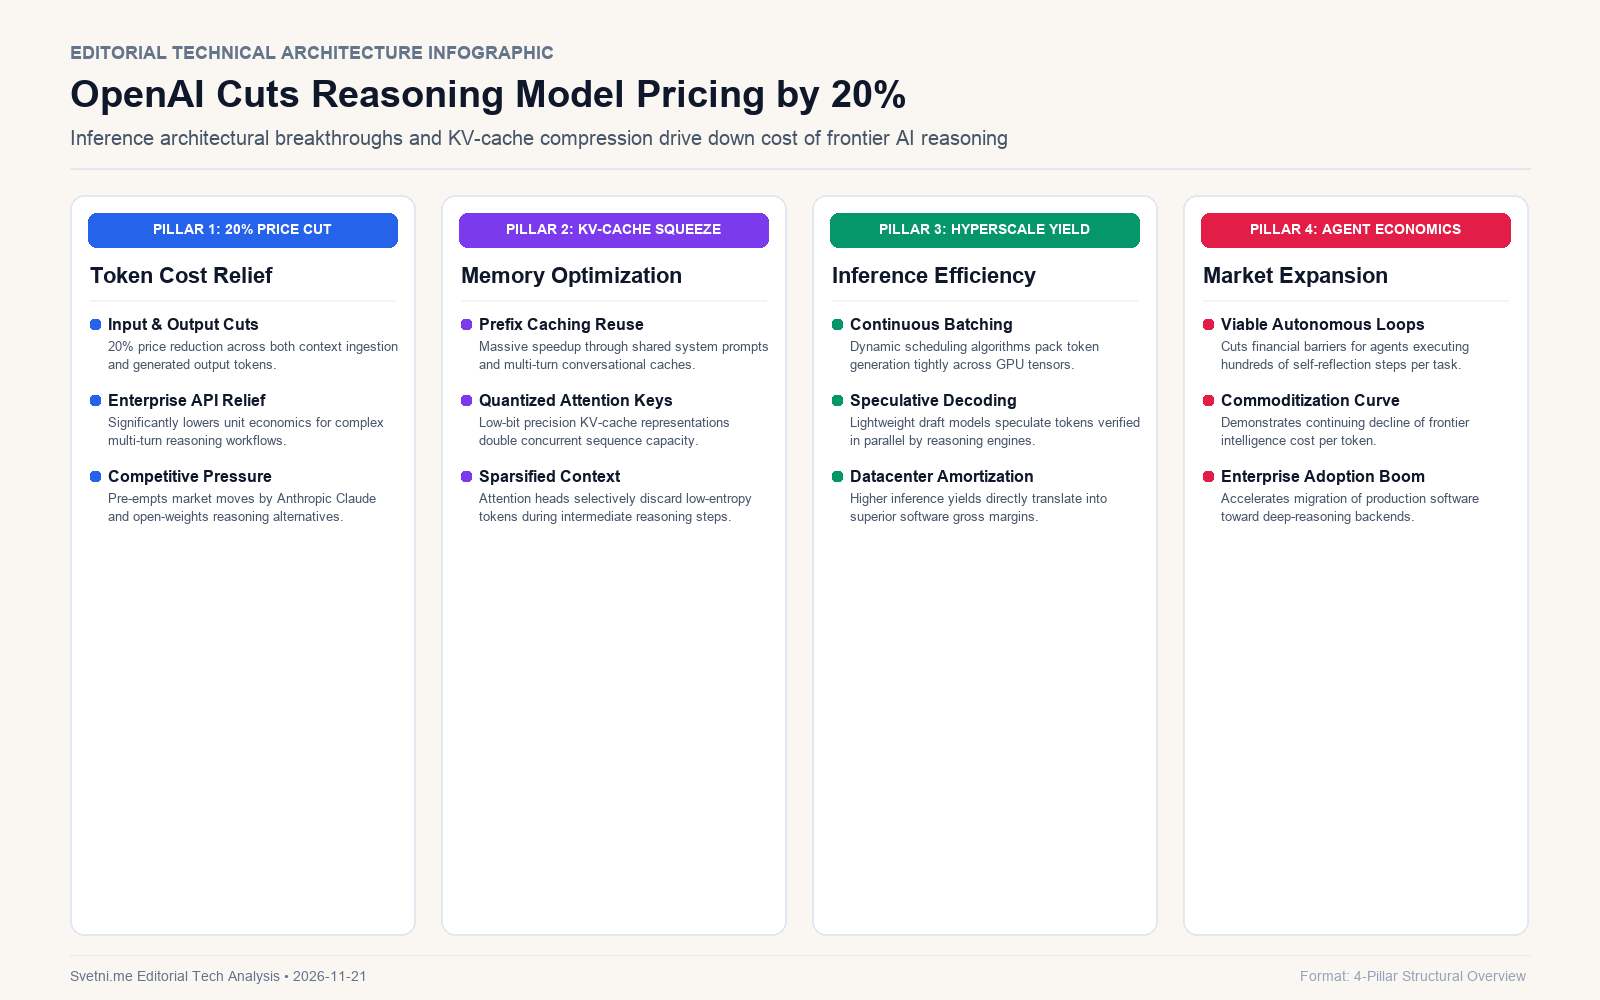
Инфографика: Ключови стълбове и анализ
Архитектурните двигатели на намалението: Квантуване на вниманието и преизползване на префикси
Съвременните фронтиерни модели за разсъждения изискват безпрецедентни изчислителни ресурси, тъй като генерират обширни скрити вериги от мисли (chain-of-thought) преди формулирането на крайния отговор [1]. Основният тесен фланг в дейта центровете бе колосалната памет, заемана от ключовете и стойностите (Key-Value Cache) на многослойния механизъм за внимание.
Инженерите на OpenAI постигнаха пробив чрез въвеждане на прецизно нискобитово квантуване на KV-кеша (Int4 и FP8 без загуба на математическа точност при разсъжденията) и усъвършенствана технология за повторно използване на префикси (Prefix Caching). Това позволи многократно съкращаване на заеманата памет на графичните процесори и удвои броя паралелно обслужвани заявки на един физически сървър.
Спекулативно декодиране и хиперскейлърска амортизация
Вторият решаващ компонент за намаляване на оперативната себестойност е въвеждането на напреднало спекулативно декодиране [1]. При този метод по-малък, ултрабърз помощен модел генерира предложения за следващите токени, след което големият разсъждаващ модел ги верифицира паралелно в един-единствен изчислителен цикъл на тензорните ядра.
Този механизъм съкращава латентността при генерация с над 40% и повишава коефициента на полезно действие на сървърните клъстери. По-високата производителност на единица силициев кристал директно се трансформира в по-високи маржове, позволявайки на компанията да свали крайните клиентски цени, без да жертва своята рентабилност.
Дефлационната крива на интелигентността и експлозията на автономните агентни вериги
Свалянето на цените от OpenAI с 20% потвърждава, че разходите за фронтиерен изкуствен интелект следват стръмна дефлационна крива. Всяко подобрение в софтуерните алгоритми и хардуерната ефективност на полупроводниците сваля разходите за единица токен, правейки напредналия интелект все по-достъпен за глобалната икономика.
За създателите на автономни агентни системи това намаление има колосален мултиплициращ ефект. Когато един автономен агент изпълнява комплексна инженерна задача, той често прави стотици междинни заявки, тестове и анализи на грешки. Намаляването на разходите с 20% отключва масовото внедряване на сложни агентни вериги в предприятията, превръщайки дълбоките разсъждения в рентабилен стандарт за бизнеса и засилвайки конкурентния натиск върху цялата технологична екосистема.