Uber съкрати паметта за кеширане на преводи с до 90% при запазване на P99 латентност под 1 милисекунда
Източник: Wikimedia Commons / BalticServers
Инженерният екип на Uber представи подробен архитектурен доклад за мащабна оптимизация на своята глобална инфраструктура за машинен превод в реално време, съкращавайки заеманата оперативна памет с над 90% чрез въвеждане на йерархично семантично кеширане и компресия на векторни ембединги [1]. Новата система гарантира, че над 85% от милиардите многоезични текстови съобщения между пътници, шофьори и куриери се обслужват без повторно преизчисляване на тежки невронни мрежи, като същевременно запазва критичната P99 латентност на заявките под 1 милисекунда.
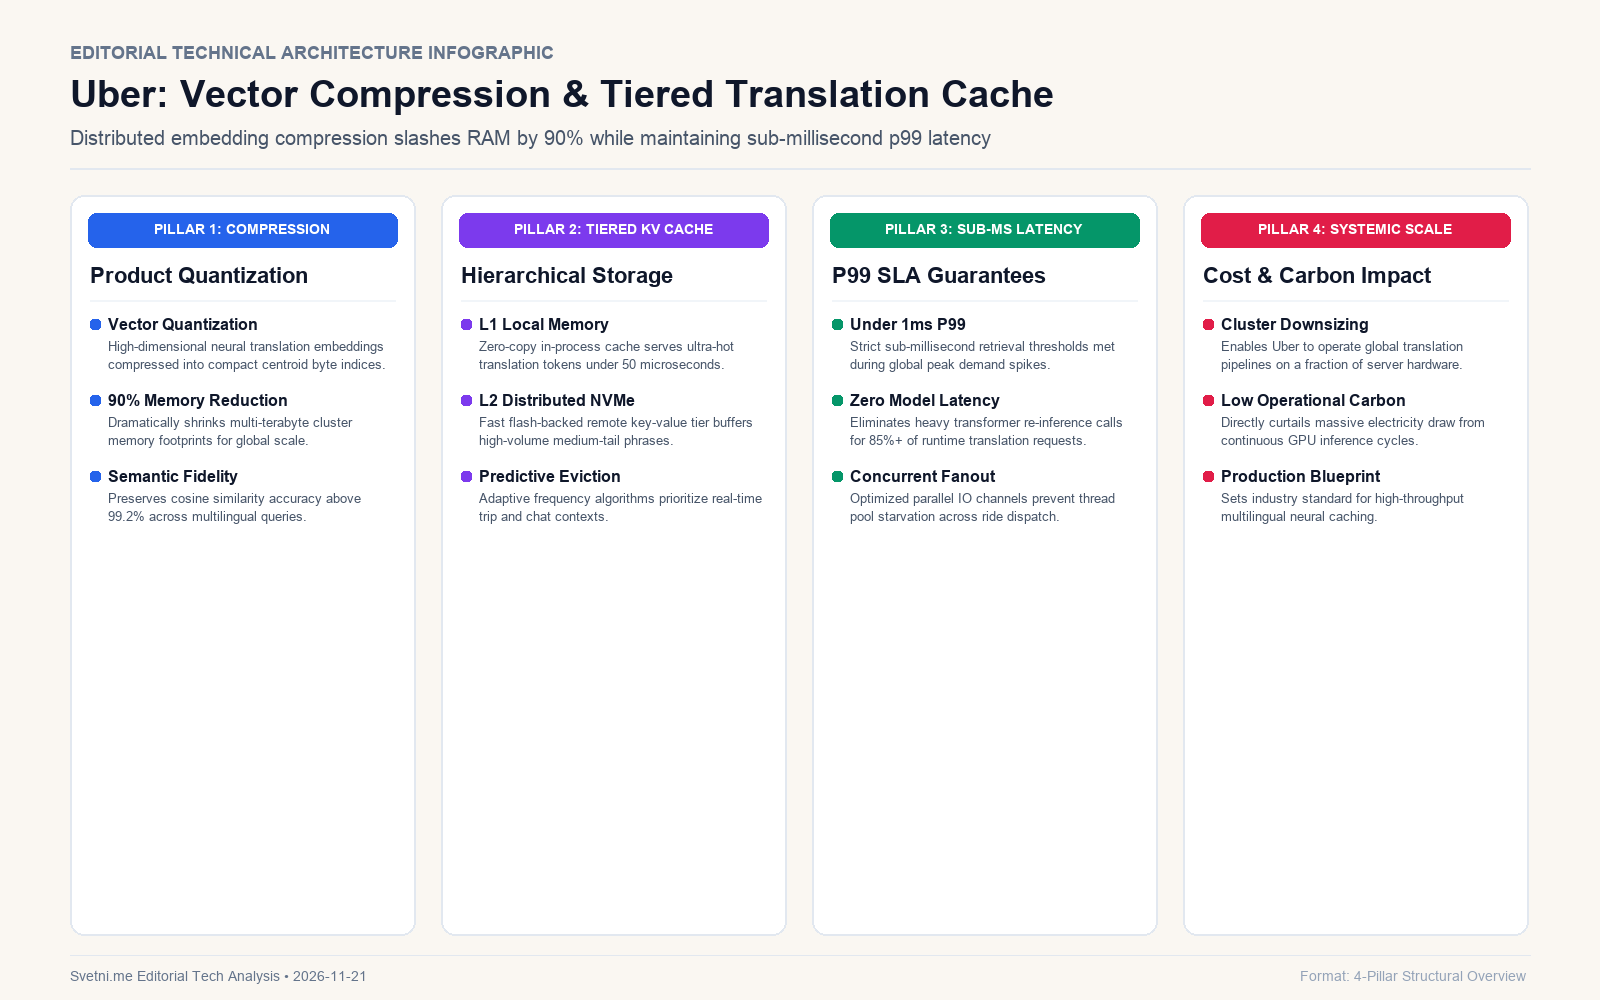
Инфографика: Ключови стълбове и анализ
Архитектура на векторната компресия: Продуктово квантуване без семантични загуби
В конвенционалните производствени системи за модели на ембединги, векторните репрезентации се съхраняват в 32-битова или 16-битова плаваща запетая, което изисква десетки терабайти скъпа RAM памет при глобален мащаб [1]. Инженерите на Uber са имплементирали специализирано продуктово квантуване (Product Quantization - PQ), което разделя високоразмерното векторно пространство на ортогонални подпространства и ги представя чрез компактни центроидни байтови индекси.
Този математически подход постига над десетократно компресиране на векторната база данни, като същевременно запазва над 99.2% косинусно сходство при операциите за векторно търсене. Чрез съхраняването на квантуваните вектори в оптимизирани структури от данни, системата елиминира нуждата от скъпоструващо разширяване на сървърните клъстери, запазвайки способността за мигновено откриване на смислово сходни фрази между различни езици.
Йерархичен двуслоен кеш: L1 оперативна памет и L2 разпределена NVMe мрежа
За да гарантира изпълнението на строгите споразумения за ниво на обслужване (SLA) под 1 милисекунда при пикови натоварвания, Uber разделя кеш слоя на две тясно координирани нива [1]. Първото ниво (L1) представлява локален in-process буфер с нулев овърхед при копиране, който обслужва свръхчестотните преводни токени за по-малко от 50 микросекунди.
Второто ниво (L2) е изградено като разпределена мрежа от key-value бази, базирани на ултрабързи NVMe SSD памети, които съхраняват средната и дългата опашка от потребителски фрази. Адаптивен алгоритъм за предсказващо изтласкване на кеша (predictive cache eviction) непрекъснато анализира контекста на текущите активни пътувания и чат сесии, зареждайки предварително потенциалните реплики в локалната памет на най-близкия дейта център.
Системни архитектурни и макроикономически последици: Ерата на инференс ефективността в мащабни платформи
Инженерният пробив на Uber бележи преминаването на световната софтуерна индустрия от фазата на безразборно харчене за изчислителен капацитет към етап на стриктна финансова и енергийна оптимизация. В продължение на години хиперскейлърите решаваха проблемите с нарастващия обем на невронни изчисления чрез просто добавяне на нови хардуерни клъстери. Превръщането на машинния инференс в постоянен оперативен разход обаче налага фундаментално преструктуриране на системния стек.
Спестяването на 90% от паметта при глобален превод трансформира балансовите отчети на компанията, намалявайки разходите за облачна инфраструктура с милиони долари годишно и директно понижавайки въглеродния отпечатък от денонощната експлоатация на сървъри. За разработчиците на мащабни дистрибутирани системи този архитектурен казус служи като стандартен наръчник за това как математическата компресия и класическото кеширане могат да осигурят хипермащабиране без загуба на потребителско качество.