Автономни кодиращи агенти написаха 3 милиона реда C++ и Verilog RTL код, ускорявайки FPGA инференс чип 33 пъти
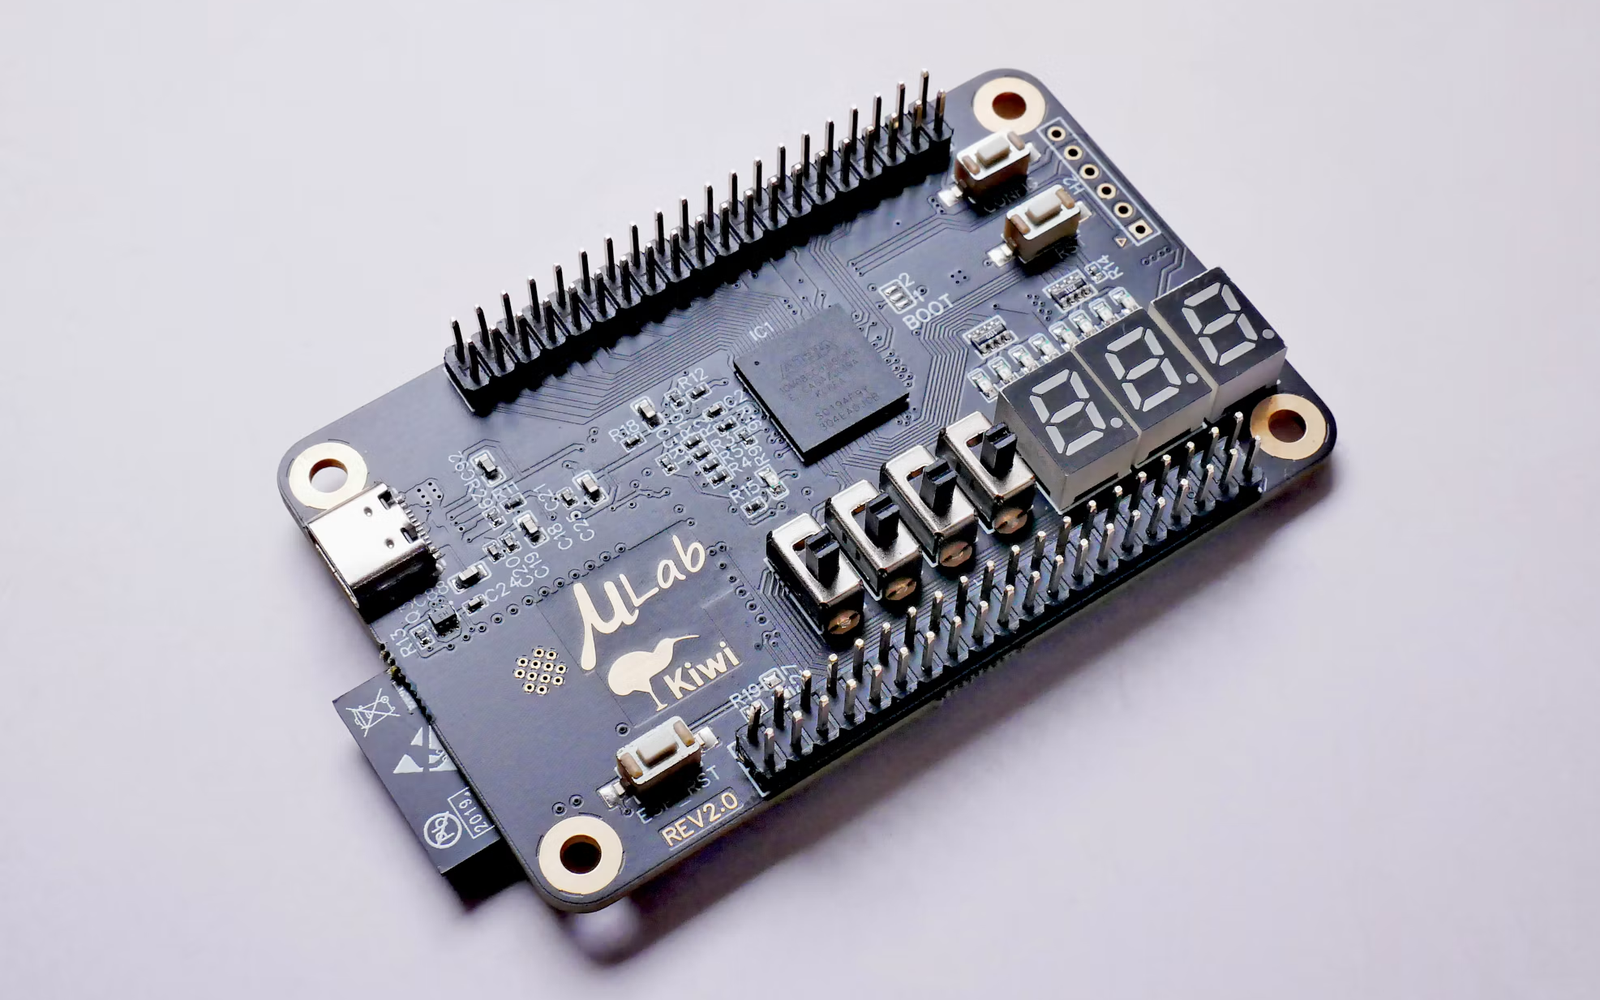
Източник: Ankit Gupta (ankitg.me) / Развойна FPGA платка за хардуерно ускоряване на инференс при тернарни езикови модели
В детайлен инженерен анализ софтуерният предприемач и изследовател Анкит Гупта демонстрира как автономни кодиращи агенти са успели самостоятелно да проектират, верифицират и оптимизират хардуерен ускорител за езикови модели върху програмируема логическа матрица (FPGA) без никакъв предварителен опит на автора с езика за описание на хардуер Verilog [1]. Използвайки облачна F2 инстанция на Amazon Web Services (AWS) с 16 GB високоскоростна HBM памет и новата архитектура с тернарни тегла на стартъпа DeepGrove, агентният цикъл в средата Conductor е работил непрекъснато в продължение на няколко дни [1]. В рамките на стотици автоматизирани експерименти моделите Claude Opus и GPT-6.2 Astra са написали около 3 милиона реда C++ и Verilog код, анализирали са 30 милиона реда симулационни и компилационни логове при бюджет от едва $10 000 за токени и са ускорили побитово точния инференс на модела 33 пъти — от началните 6 токена в секунда до реално приложимите 213 токена в секунда [1].
Тернарен матричен двигател без умножители и 32-канално поточно предаване от HBM паметта
Ключовият архитектурен фактор, който прави възможно вместването и радикалното ускоряване на езиковия модел върху ограничената до 16 GB памет на AWS F2 FPGA платката, е използването на 2-битови тернарни тегла (-1, 0, +1) по методологията на DeepGrove [1]. Тъй като при инференс с размер на партидата единица (batch size = 1) преносът на теглата от паметта консумира многократно повече време и енергия от самата математика, 2-битовото пакетиране осигурява 8 пъти по-висока плътност на трансфера спрямо стандартните 16-битови формати. Вместо класически хардуерни умножители всяка 2-битова стойност управлява прост 3:1 мултиплексор, който избира директно входа x, инвертирания вход ~x или 0, докато неизползваният четвърти двоичен код вдига хардуерен флаг за грешка при повредени тегла [1].
При отрицателните стойности операцията по допълнение до две (~x + 1) се оптимизира на ниво ред: отделните изчислителни линии само маркират отрицателните елементи, а редовият редуктор добавя единиците веднъж за целия ред вместо във всяка клетка [1]. Активациите се групират като цели числа (INT12 или INT16 при низходящата MLP проекция), редуцират се целочислено и едва след акумулирането се умножават по FP32 групови скали, като нормализацията RMSNorm се отлага след квантуването за идентичен числен резултат на много по-ниска хардуерна цена. Изчислителното ядро е организирано в 8 ядра, разделени в два клъстера за паралелно изпълнение на независимите gate и up проекции, което намалява използването на специализираните DSP блокове наполовина спрямо INT8/INT16 дизайните за сметка на логическите таблици (LUT) [1].
В подсистемата на паметта теглата се предават поточно директно от всички 32 канала на HBM паметта към изчислителните линии без междинно буфериране в чипа, тъй като се използват само веднъж на токен, докато активациите се кешират до всяко ядро [1]. KV кешът използва компактния формат MXINT8 (8-битови стойности с една споделена експонента за блок от 32 канала), а вътрешните буфери са реализирани като типизирани слотове с ясен жизнен цикъл (open -> write -> commit -> read -> release), които проверяват хардуерно формата, обхвата и производителя на данните [1].
C-Slow конвейерно внимание, четиристепенна верификация и физически тайминг при 225/425 MHz
Механизмът на вниманието (Attention) обработва кеша на плочки (tiles) от по 64 токена чрез онлайн softmax алгоритъм с текущ максимум и сума в FP32, така че пълната матрица на оценките никога не се записва в паметта [1]. Всеки модул за внимание преплита две независими задачи върху един и същ път за данни (техниката C-slow), което скрива латентността на конвейера без дублиране на хардуера, а нормализацията на Q/K главите и ротационните позиционни ембединги (RoPE) са изнесени в отделен малък векторен блок, работещ паралелно с V проекцията [1]. При Mixture-of-Experts конфигурациите всеки експерт се разпределя (striping) през всички 32 HBM канала, а маршрутизиращият слой (router) се запазва в пълна FP32 прецизност като критичен път на планировчика.
Най-впечатляващият резултат от експеримента е, че когато на 29 октомври авторът подава на агента подробен списък с хардуерни съвети от основателите на DeepGrove, агентът анализира собствените си логове и доказва, че основните архитектурни идеи вече са били самостоятелно планирани и имплементирани от него дни по-рано [1]. За да достигне финалната скорост от 213 токена в секунда, агентът самостоятелно въвежда двоен четец на банките памет за главите на вниманието (+17.3% ускорение), политика за предварително извличане на експерти в реално време и корекция в тайминга на рутера [1]. Физическият дизайн спазва строга дисциплина между трите суперлогически региона (SLR) на чипа с максимум 10 нива на логическа дълбочина, четиристепенна верификация с cocotb до побитово сравнение на 24 слоя и автоматично сваляне на тактовата честота с една стъпка надолу (от 231.25 MHz на 225/425 MHz), след като продължителен soak тест открива редки случайни грешки при пиковата честота [1].
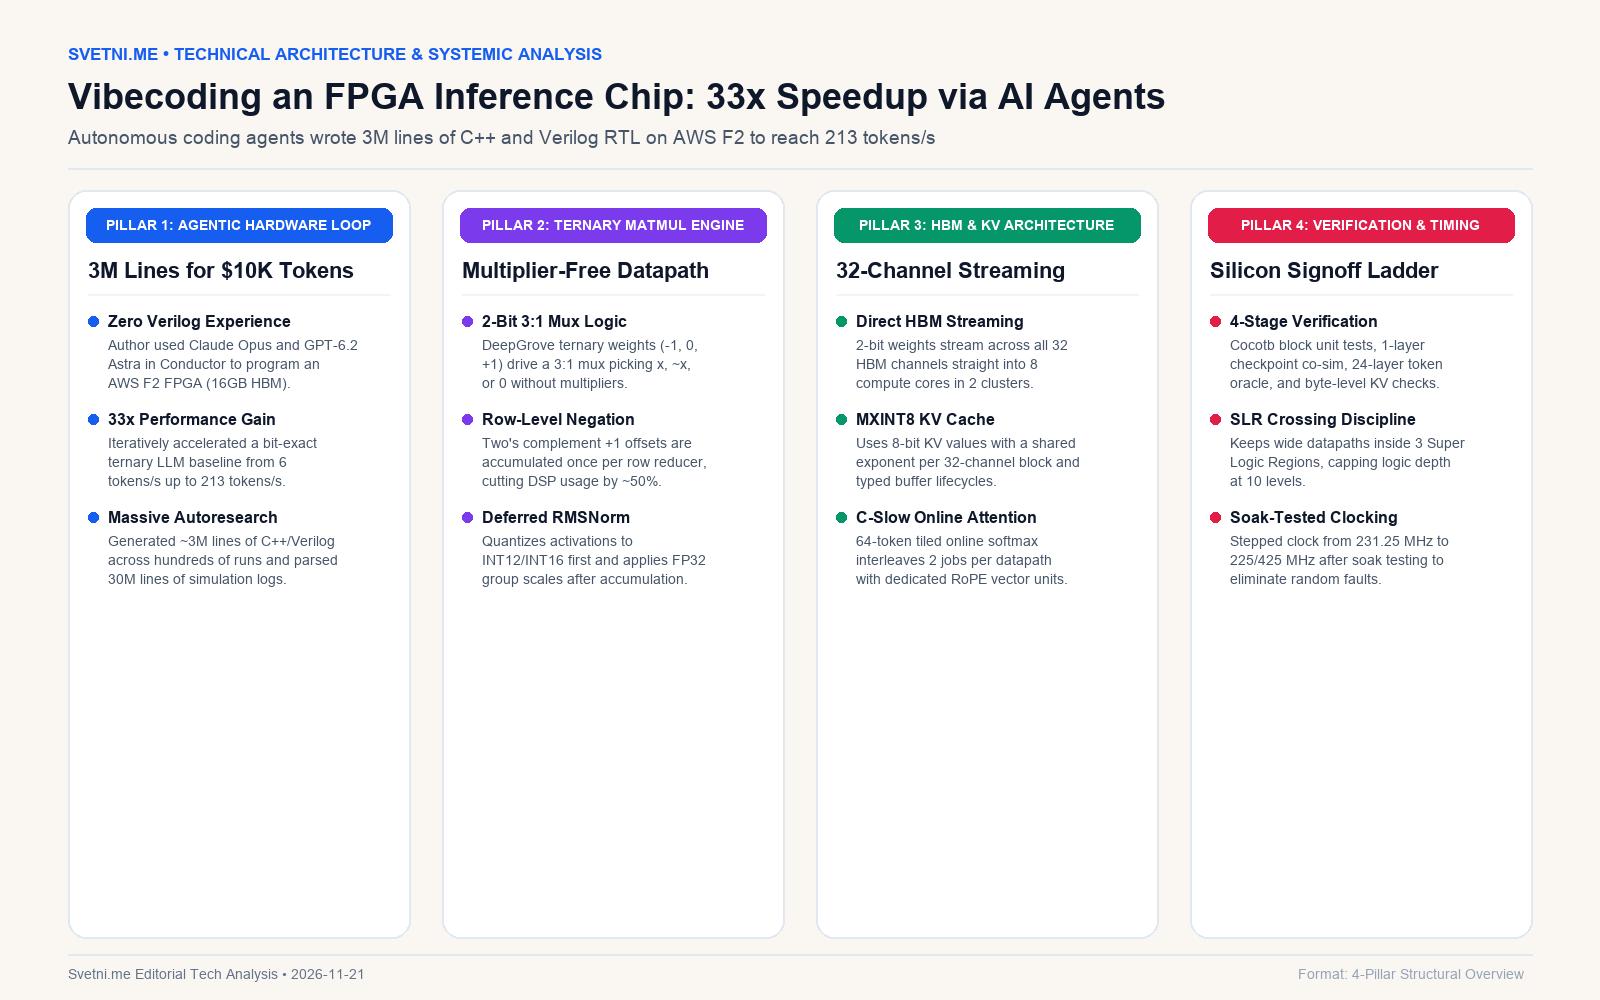
Инфографика: Ключови стълбове и анализ
Системни архитектурни и макроикономически последици: Демократизацията на силициевия дизайн чрез автономни RTL цикли
Успешното „вайбкодиране“ на работещ, високопроизводителен FPGA ускорител за езикови модели от софтуерен инженер без никакви познания по Verilog разрушава една от най-високите входни бариери в компютърната индустрия. Традиционно разработката на специализиран хардуер на ниво регистров трансфер (RTL), анализът на времеви диаграми (waveforms) и затварянето на физическия тайминг изискват екипи от високоплатени хардуерни инженери и месеци на ръчна симулация. Когато автономен агент може да извърти стотици цикли на „малка промяна -> линтинг -> cocotb модулен тест -> бърз синтез -> проверка на логическата дълбочина“ срещу $10 000 в облачни токени, хардуерното инженерство започва да се подчинява на скоростта и икономиката на софтуерните итерации.
От архитектурна гледна точка комбинацията от 2-битови тернарни модели без хардуерни умножители и реконфигурируеми FPGA матрици отваря изцяло нов фронт срещу монопола на графичните процесори с общо предназначение. Докато стандартните GPU ускорители са проектирани около масивни FP16/FP8 тензорни ядра, FPGA архитектурите позволяват изграждането на точно напаснати мултиплексорни конвейери и 32-канално директно поточно предаване от HBM паметта, което максимизира използването на пропускателната лента при нисколатентен инференс с партида единица.
В макроикономически план способността на модели като Claude Opus и GPT-6.2 Astra автономно да оптимизират RTL логика до 33-кратно ускорение ускорява експоненциално цикъла на самоподобрение на изкуствения интелект. Когато самите фронтиерни езикови модели могат да проектират и верифицират по-бързи хардуерни пътища за данни за изпълнение на следващото поколение компактни тернарни модели, разходите за внедряване на високоскоростен инференс в облака и в ръбовите системи ще продължат да падат много по-бързо от прогнозите на традиционните полупроводникови пътни карти.