Самоусъвършенстващият се модел на Sakana AI бележи напредък, но попада в капана на собствените си слепи петна
Методът MASS на Sakana AI за рекурсивно самоусъвършенстване. Снимка: The Decoder / Sakana AI
Японската изследователска лаборатория Sakana AI, известна със своите революционни еволюционни алгоритми за сливане на модели, публикува ново фундаментално изследване, посветено на рекурсивното самоусъвършенстване на невронни мрежи [1]. Разработеният метод MASS (Model as Solver, Judge, and Refiner) позволява на един базов езиков модел автономно да подобрява своите способности чрез едновременно изпълнение на три роли: решаване на задачи, оценяване на резултатите и пренаписване на системните работни процеси.
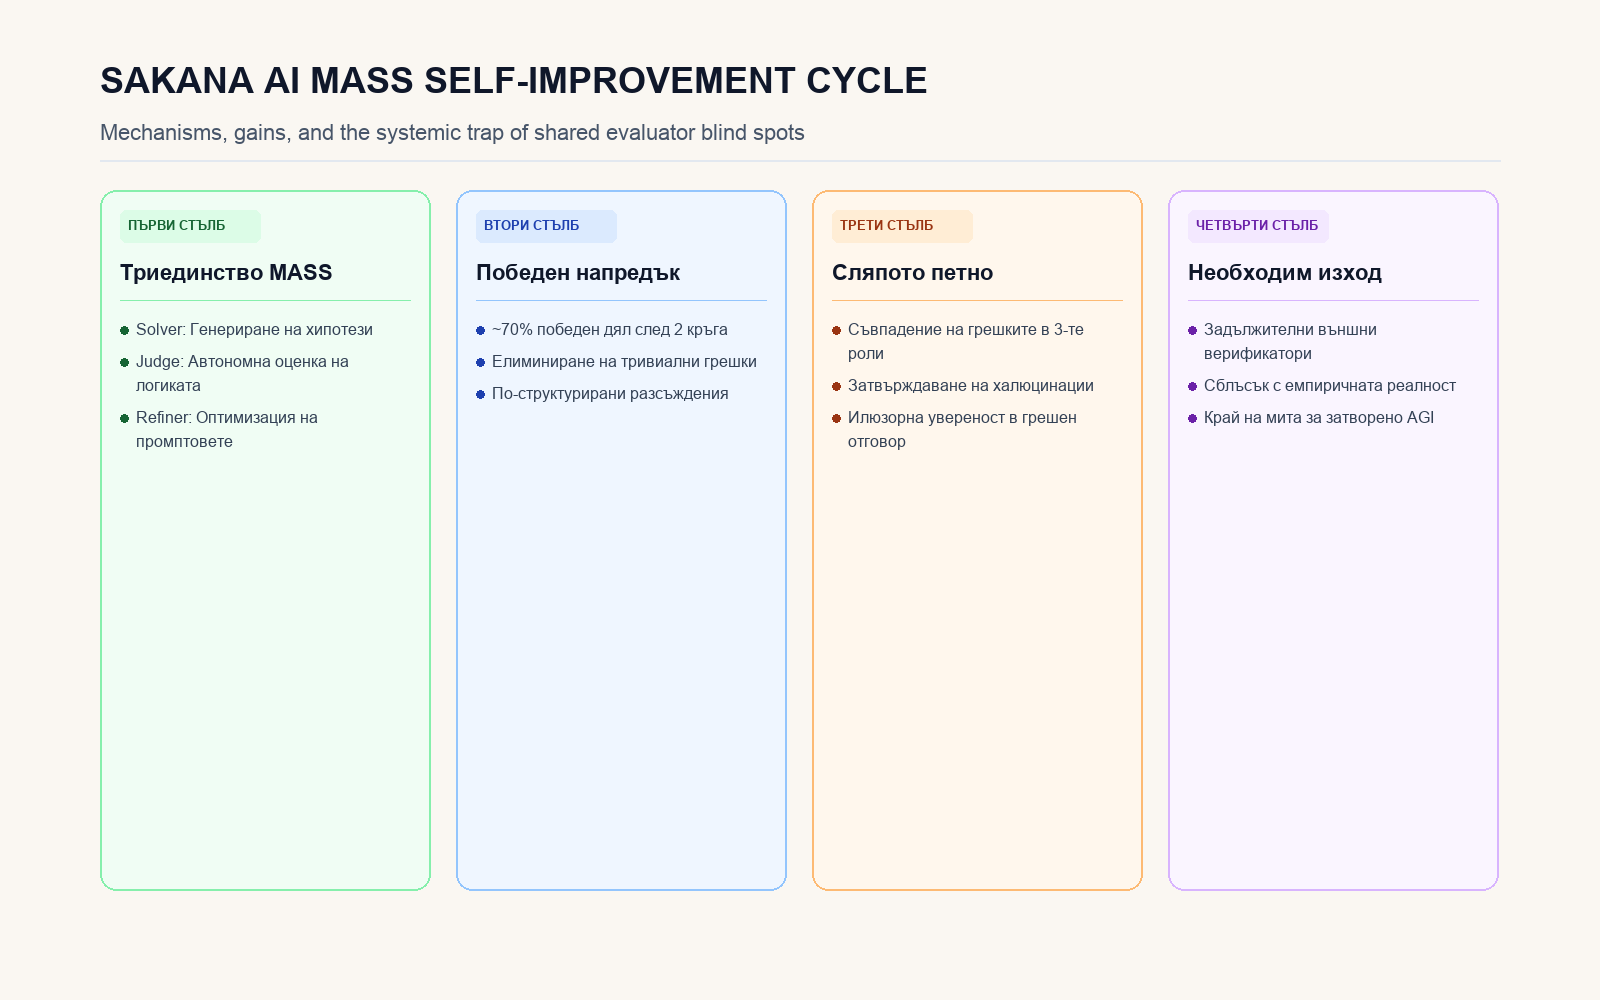
След два пълни итеративни цикъла методът MASS постига впечатляващ победен дял от близо 70% срещу първоначалния базов модел при решаване на сложни логически и аналитични проблеми [1]. Експериментите обаче разкриват критичен теоретичен дефект: моделът системно затвърждава собствените си грешки, когато слепите му петна съвпаднат и в трите роли.
Триединната архитектура MASS: Решател, съдия и оптимизатор
В основата на метода MASS лежи концепцията за затворен автономен контур [1]. Вместо да разчита на човешка обратна връзка (RLHF) или предварително етикетирани данни, моделът генерира вариативни решения за даден проблем, след което в ролята на съдия оценява тяхната правдивост и аргументация. В третата фаза моделът действа като оптимизатор, синтезирайки нови насоки и промптове за подобряване на работния поток.
В стандартните тестове за оценяване на модели този подход показва изключителна ефективност за бързо елиминиране на тривиални граматически и изчислителни грешки [1]. Моделът се учи автономно да структурира аргументите си, да избягва прибързани заключения и да прилага детайлни стъпки за проверка.
Капанът на споделените слепи петна
Фаталното ограничение на саморефлексията настъпва тогава, когато грешката произтича от фундаментално изкривяване в предварително обучените тегла [1]. Ако базовият модел съдържа дълбока концептуална заблуда или страда от AI халюцинации по определена тема, същата тази заблуда се проявява както при решаването на проблема, така и при неговото оценяване.
Когато „решателят“ направи грешка, а „съдията“ я оцени като брилянтно прозрение, оптимизаторът затвърждава този дефект като препоръчителна практика за следващите поколения [1]. Изследователите от Sakana AI установяват, че моделът може да изпадне в състояние на пълна илюзорна увереност, генерирайки псевдонаучни или неверни разсъждения с нарастващ математически ентусиазъм.
Епистемологичният таван на рекурсивния интелект
Откритието на Sakana AI поставя под сериозно съмнение популярния технологичен мит за бързо настъпваща „интелектуална експлозия“, при която един изкуствен интелект може безкрайно да подобрява себе си в изолация. Подобно на математическите теореми на Гьодел, една затворена когнитивна система не може да докаже собствената си пълнота или да коригира собствените си аксиоматични слепи петна без достъп до външен детерминистичен източник на истина.
За индустрията на самоусъвършенстващи се агенти този резултат означава, че бъдещите архитектури задължително трябва да включват външни верификатори — като формални компилатори, физически сензори, математически доказатели или диверсифицирани ансамбли от модели с напълно различен произход на данните. Истинският прогрес към надежден интелект няма да бъде постигнат чрез самовглъбен самоанализ, а чрез непрекъснат, строг сблъсък с емпиричната реалност.
Инфографика: Светни.ме