HyperFlow-H3-Flash компресира 31B дифузионен модел за видео и аудио до 14B INT8 с инференция в 6 стъпки
Източник: Andrey Butko / Wikimedia Commons
Инженерен пробив в генерацията на мултимодално съдържание демонстрира системата HyperFlow-H3-Flash, разработена от независимия изследователски екип Video-Rebirth [1]. Чрез революционни техники за дифузионни модели и компресиране на невронни мрежи, те успяха да свият колосален 31-милиарден базов модел до компактна 14B архитектура, откривайки нова страница в мултимодалния AI и оптимизацията на инференцията.
Елиминиране на стъпките чрез дистилация на траекторията
Традиционните видео дифузионни модели изискват между 30 и 50 деноизиращи итерации за създаване на плавен видеоклип, което прави генерацията бавна и енергоемка. HyperFlow прилага прогресивна дистилация на дифузионната траектория, позволявайки синтезиране на фотореалистични видеокадри и синхронизирано аудио само в 6 стъпки с минимално натрупване на шум.
8-битова целочислена квантизация на пространствено-времевите слоеве
За да впишат модела в паметта на масовите потребителски карти, инженерите са приложили смесена квантизация (INT8 за конволюционните блокове и FP8 за крос-атъншън механизмите). Това намалява консумацията на памет с над 60%, позволявайки непрекъснат видео стрийминг при 60 кадъра в секунда.
Сривът на бариерите пред локалното дигитално видеопроизводство
HyperFlow-H3-Flash бележи повратна точка в компютърната графика и медийното производство. Досега висококачественото генеративно видео бе ексклузивен монопол на облачните студиа, таксуващи долари за всяка минута рендиране. Възможността за локално генериране на 4K съдържание с висока скорост ще преобрази индустрията за специални ефекти, видеоигри и виртуална реалност, позволявайки на малки независими творци да създават цели филмови продукции на стандартни работни станции.
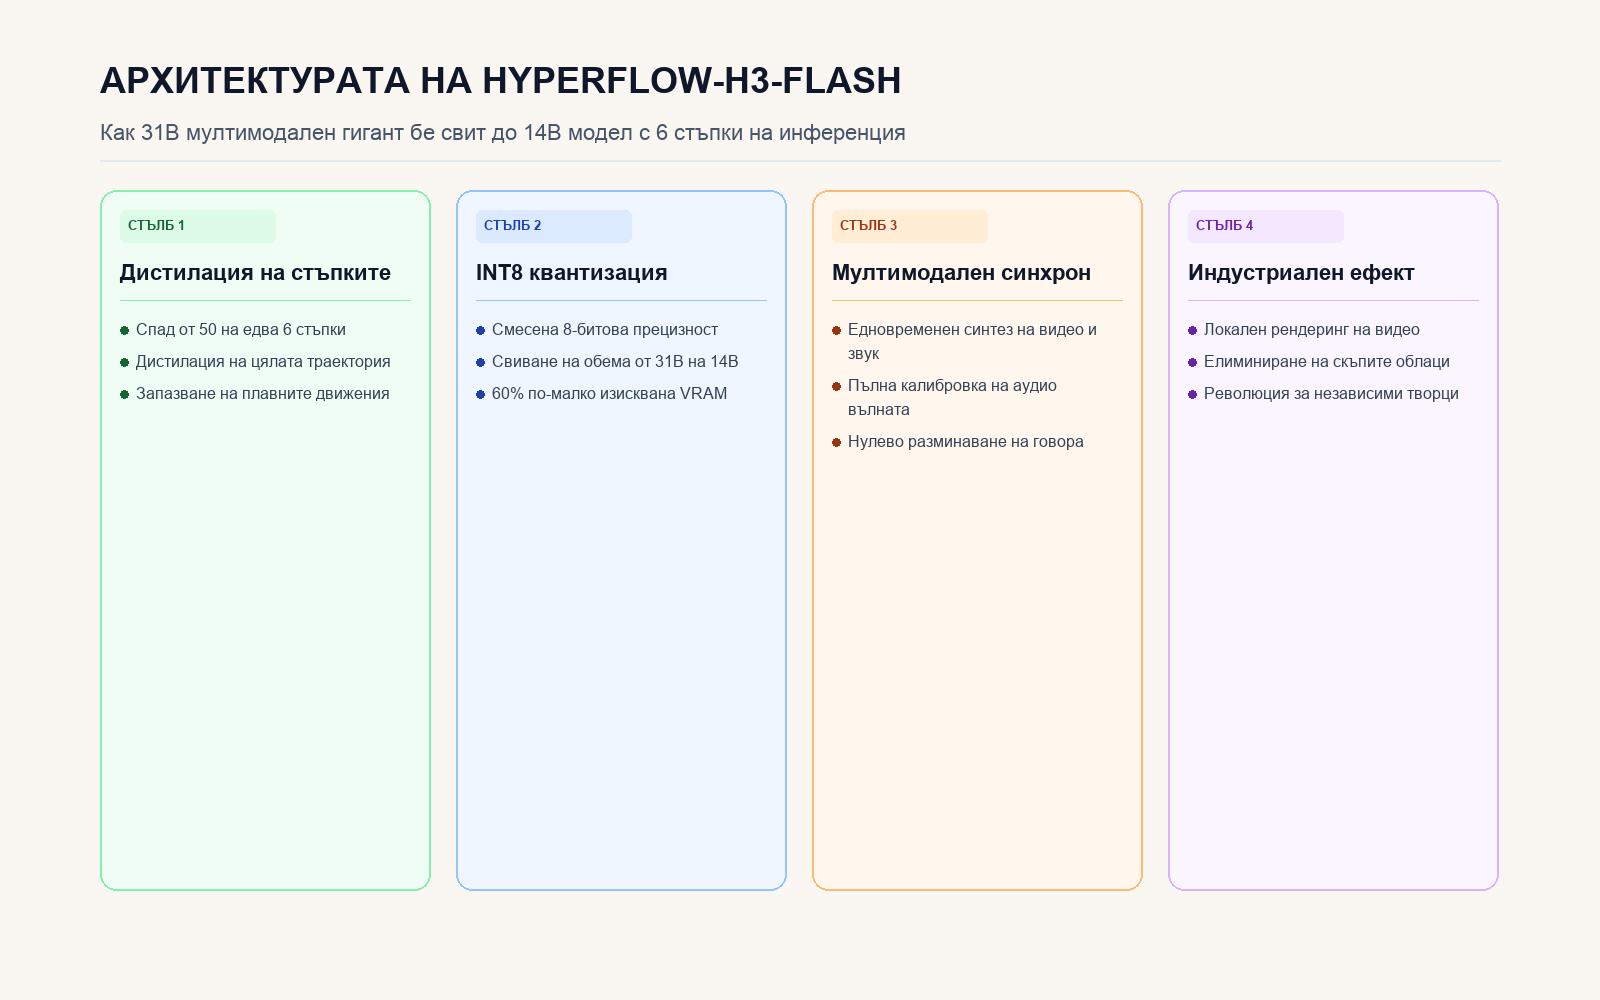
Анализ на траекторната дистилация, INT8 квантизацията и скоростта на рендеринг.